2026年10月9日,SuperCLUE发布最新一期智能体终端编程中文能力评测结果。在本次测评中,小米MiMo V2.6 Pro以综合得分64.65分位居榜首,成为表现最优的模型。
本次评测聚焦大模型在智能体框架下的中文任务执行能力,涵盖中文需求理解、任务拆解与规划、工具调用、源文件修改、错误定位与修复,以及最终成果交付等关键环节。所有参测模型均统一运行于Claude Code智能体框架之上,确保评测环境一致,实现跨模型能力的客观横向比较。
榜单其余名次依次为:Kimi位列第二,GLM第三,Hy4第四;小米另一版本MiMo V2.6 Flash以53.54分排在第五位。
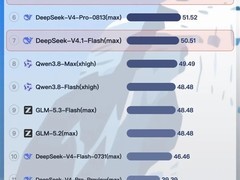
在成本效率维度,MiMo V2.6 Pro单题平均成本为1.52元,对应最高得分;MiMo V2.6 Flash单题成本仅0.67元,为所有参测模型中最低。作为参照,DeepSeek-V4.1-Flash(max)得分为50.51分,单题成本1.86元;Hy4-Preview(high)得分为55.56分,单题成本高达11.61元。相较而言,MiMo V2.6 Pro不仅得分超越Hy4-Preview,单题成本亦显著更低,在整体任务集上展现出更优的性能与成本平衡。
从任务执行全过程观察,DeepSeek-V4.1-Flash在响应速度与耗时控制方面表现突出;而MiMo V2.6 Pro则在保障高完成质量的同时,兼顾了合理的执行效率,体现出良好的综合能力。
当前,越来越多开发者将智能体作为日常编码的得力助手,不再依赖从头编写完整程序,而是更多用于脚本生成、异常诊断、缺陷修复等高频场景。在中文语境下,部分海外大模型对指令语义、上下文逻辑及技术术语的理解仍存在局限,而国产模型凭借对本地语言习惯、开发生态和工程规范的深度适配,展现出明显优势。
智能体终端编程整体仍处于演进阶段,尚无任何模型可全面替代专业程序员。但此次评测清晰表明,国产大模型在复杂工程类任务上的能力已快速提升,正逐步缩小与国际主流模型的技术差距,并在特定中文技术场景中实现有效超越。



 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论