2026年9月15日,一位独立开发者近日公开发布名为“CUDA-for-AMD-Windows”的开源项目,首次在Windows平台实现了原生支持AMD显卡运行原本仅适配CUDA的工作负载,整个过程无需虚拟机或双系统环境。
实测表明,该项目在RX 9060 XT显卡上成功完成了参数量达220万的PPO强化学习模型训练任务,全程调用未经任何修改的标准CUDA库接口。
该项目本质上是一套高度自动化的PowerShell脚本工具链,其核心是将ZLUDA翻译层与AMD官方为Windows提供的HIP/ROCm SDK进行深度集成。脚本可自动识别当前GPU架构,精准获取并部署适配的ZLUDA预发布版本(v6-preview.69),同时将其底层数学运算能力映射至系统中已安装的ROCm基础库。
开发过程中,关键的CUDA驱动API及cuBLAS、cuSPARSE、cuFFT三大核心库已被完整拦截并重定向至AMD平台对应的HIP实现,从而在接口层实现无缝兼容。
随着AMD近期持续更新ROCm生态,Windows平台上的消费级GPU已获得PyTorch框架及HIP SDK的正式支持,RX 7000与RX 9000系列显卡均被全面纳入支持范围。然而,大量行业专用软件、历史遗留代码及定制化AI工具仍严格依赖CUDA生态,导致AMD用户长期受限于WSL2透传方案,或只能被动等待开发者完成HIP移植。本项目正是为填补这一现实断点而生,相当于为只认CUDA的软件提供了一个即插即用的兼容适配层。
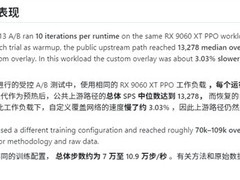
基准性能测试显示,在RX 9060 XT上执行同一220万参数强化学习任务时,采用官方ZLUDA配合AMD HIP SDK 6.4的组合路径,平均吞吐量为13278 steps/秒;若改用从旧版ZLUDA二进制中提取并优化的自定义覆盖层,则为12876 steps/秒,性能差距约为3%。开发者指出,后续尝试剥离LibTorch与ZLUDA依赖后,吞吐量显著提升,印证当前翻译层仍存在一定运行开销。
需要明确的是,CUDA生态的核心组件如cuDNN、TensorRT与NCCL尚未被该项目支持。若目标应用深度耦合cuDNN等闭源库,该方案将无法生效。但该项目的重要价值在于证实:AMD显卡运行CUDA专属软件所面临的并非硬件不可逾越的壁垒,而是可由软件翻译层解决的兼容性问题。项目全程开源,具备良好可扩展性,社区协作有望持续拓展对更多GPU型号及CUDA功能模块的支持范围。








 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论