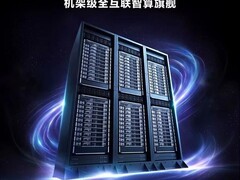
2026年9月29日,新紫光集团旗下子公司新华三正式发布以国产GPU为算力核心的机架级全互联智能计算旗舰产品——UniPoD S81000 X1超节点。
当前,AI智能体正加速融入企业日常业务流程。单次任务所消耗的Token数量已普遍达十万至百万量级,较传统对话式交互场景提升数十倍。据第三方机构调研数据显示,在已完成智能体部署的企业中,有37%已进入实际应用阶段;其中超过六成用户反映,实时交互类应用的响应延迟明显超出预期。通信效率不足,已成为制约整体算力有效释放的关键瓶颈。
传统八卡服务器多依赖以太网进行堆叠组网,卡间互联时延处于微秒级,带宽上限约百Gb/s。面对万亿参数MoE大模型所需的All-to-All全连接通信压力,大量GPU运算时间被消耗在数据传输等待中,硬件资源利用率严重受限。
S81000 X1超节点提出系统性解决方案。其单Scale-Up域最多可集成40张国产加速卡,并通过4个专用交换Tray构建一级CLOS全互联拓扑结构,实现任意两张加速卡之间点对点带宽高达448GB/s。其中一项核心技术是正交连接架构:计算节点与交换节点采用高速连接器直接对接,省去线缆与背板环节,信号路径更短、损耗更低;全程纯电互联,不依赖光模块,物理可靠性提升十倍。
在内存与算力协同方面,40张加速卡可聚合形成5760GB统一编址显存池,全面支持FP8精度计算,整机总算力达28P FLOPS,为万亿参数大模型的训练与推理一体化提供坚实算力支撑。
部署适配能力同样突出。该产品严格遵循19英寸标准机柜规格,支持机柜解耦交付模式,单个机柜最高可容纳两套40卡超节点系统,可无缝衔接现有数据中心基础设施。
散热设计采用以液冷为主、风液兼容的协同架构。高热密度部件如CPU与GPU均配备冷板式液冷模块;新建数据中心可直接部署液冷系统,而存量风冷机房亦可通过风液CDU方案实现平滑升级。
从底层芯片、高速互联、高效散热,到资源调度与智能运维,国产智能算力的发展重心已由单卡性能比拼,全面转向系统级全栈能力构建。S81000 X1超节点的推出,标志着面向企业智能体规模化落地的国产化高性能计算基础设施迈入新阶段。

 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论