当前,大模型参数规模已突破五万亿,正快速向十万亿逼近。此时制约技术发展的关键瓶颈,已不再是算力是否充足,而是内存容量与带宽所构成的“内存墙”问题日益突出。
一家总部位于美国的初创企业近日宣布完成八千八百万美元A轮融资。该公司正致力于研发一种全新的人工智能推理架构,核心目标是在内存容量与数据传输带宽之间实现更优平衡。
其首款系统代号为A-1,专为支持参数量超过二十万亿的大模型而设计。在该系统下,单用户推理吞吐量可达每秒一万Token,同时显著降低单位推理成本。
这一能力意味着什么?目前业界公开参数规模最大的模型约为五万亿级别,但其单用户实际推理速度通常不超过每秒一百Token。相比之下,A-1所支持的模型参数量是前者的四倍,推理速度则提升了百倍。
若以FP16精度运行二十万亿参数模型,理论上需占用约四十太字节内存。即便采用当前最先进的硬件平台,也难以在合理成本下满足如此庞大的内存需求,更遑论维持每秒一万Token的持续输出。
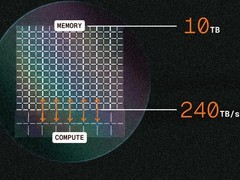
A-1采用该公司自主研发的新型架构,大规模引入光互连技术,将分布式内存单元整合为统一、可弹性调用的内存池。单通道数据传输速率可达每秒二十四吉比特,整机光互连总带宽标称为二百五十太字节每秒(官网披露数值为二百四十太字节每秒),远超现有主流内存带宽,亦较高带宽内存高出一个数量级以上。
除带宽优势外,该架构还实现了设备体积缩减至传统方案的两千五百分之一,能效表现大幅改善,单比特能耗低于一皮焦耳,实际运行中远低于该阈值;同时单系统内存容量可达十太字节。上述各项指标均显著超越当前光互连技术的行业平均水平。
真实性将于明年起逐步接受实践检验。该公司计划于二零二七年向首批客户交付集成式推理引擎,届时其架构的实际性能与工程落地能力将得到全面验证。







 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论