【ZOL中关村在线原创分析】对于硬件而言,自身的规格参数足够高,往往意味着构建了非常坚实的性能基础。但是在实际应用层面,如果没有软件层的优化配合,再强的纸面参数也会被糟糕的应用体验或兼容性所埋没。尤其是从开发者角度来说,如果一个平台的性能足够强,但软件栈又难装又难用,还跟不上生态的话,它也会被开发者们所抛弃,这一点其实在很多行业都已经有过深刻教训。
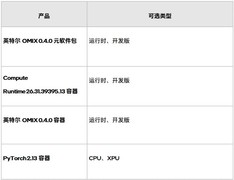
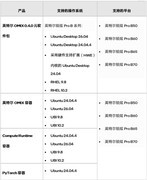
英特尔虽然在iGPU领域有着深厚积累,但是在独立显卡,也就是高性能GPU领域,却依旧是行业的新生力量,因此对于生态的构建上,英特尔依然在不断前行。前不久,英特尔正式发布了Open Middleware Xe(OMIX)0.4.0,并且同步推出多个容易,包括OMIX 0.4.0容器、Compute Runtime 26.31.39395.13容器以及PyTorch 2.13容器。虽然单看每一项改动都不算特别大,但多种方案组合起来,恰恰是弥补了锐炫GPU普及之路上最为关键的几个节点之上。
·把安装门槛真正打下来
以往,在Linux环境下配置GPU计算栈,可以说是公认的劝退环节。驱动、Runtime、框架层层依赖,版本稍有错配便全线报错。OMIX 0.4.0的第一个发力点正是在这一环节,它让英特尔GPU软件的安装流程更符合用户的操作习惯,降低安装复杂度。
同时这次英特尔提供的软件包新增了离线安装支持,且覆盖所有已支持的GPU和操作系统。这对内网机房、涉密环境和对数据安全有严格要求的企业场景意义更大,过去这些环境几乎被必须联网依赖的安装方式排除在外,而如今锐炫Pro B系列GPU则可以完全离线部署相应软件栈。
·开箱即用的AI体验
与OMIX 0.4.0同步发布的还有PyTorch 2.13容器,它同时提供CPU与XPU版本。另外还有Compute Runtime 26.31.39395.13容器。
其实容器的价值在于把驱动—Runtime—框架的版本匹配问题一次性打包封装,开发者只需拉取一个镜像,环境即刻可用,不必再在兼容性里排雷。这种开箱即用的交付方式,契合了当下AI开发者的工作习惯。
现如今,大模型训练与推理应用的爆发让XPU算力需求猛增,谁能让开发者以最低成本把环境跑起来,谁就能率先进入开发者的默认选项。
·跟上开源世界的节奏
AI开源框架的迭代速度是以周为计算单位,足见其迭代速度之快。PyTorch、vLLM等更新周期越来越短。GPU厂商的软件支持如果慢半拍,就会出现框架已升级、支持还停留在旧版的脱节死循环中,这会导致开发者的流失。
OMIX则是将加快版本迭代速度,以更好跟进包括PyTorch、vLLM在内的上游开源框架的更新周期列为明确的核心目标,等于向开发者承诺了“选择英特尔锐炫,就不会被生态甩掉。”而且对中间件层而言,跟上节奏本身就是竞争力的基础要求。
·RHEL支持落地
本次版本还新增了对RHEL 9.8和RHEL 10.2(Red Hat公司推出的商业企业级 Linux 操作系统)的支持,可运行于此前已支持的英特尔锐炫Pro B系列GPU;容器层面则通过UBI 9.8、UBI 10.2与Ubuntu 24.04.4、26.04形成呼应,平台覆盖锐炫Pro B50、B60、B65、B70所有型号。
RHEL的重要性不言而喻,它是企业级服务器和工作站部署的主要环境。补上这块拼图,意味着OMIX的目光已越过个人开发者,投向工作站、边缘AI与商用部署等更广阔的市场。
·结语
此外,英特尔OMIX为持续提升软件质量奠定了非常出色的基础,它有助于推动跨团队架构的一致性,以及加强API/ABI接口的规范管理。GPU软件栈的碎片化和接口不稳定,是行业一大难题。接口规范一旦稳定,上层框架、工具链和第三方开发者才敢于跟进投入。不过这是典型的慢变量,短期虽然看不到爆点,但却决定了英特尔锐炫生态未来能走多远。
OMIX 0.4.0的推出,诠释了GPU硬件领域一个铁律:即硬件规格自身决定上限,但软件层却决定着它的下限,然而能否在更广泛的层面普及却恰恰取决于下限。当安装不再复杂,容器即取即用,版本不再脱节,企业系统逐步覆盖,接口规范日渐清晰,这一层层阻力被逐一拆掉之后,英特尔锐炫GPU的应用和普及,便真正落地到了可以兑现的路径之上。
























 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论