当万亿参数模型在内存中悄然加载,当神经网络前向传播的每一毫秒都牵动实验节奏,AI开发者与研究人员正站在显存带宽的临界点上——不是所有显卡都能承载Transformer层间密集的数据洪流,唯有真正具备高带宽、低延迟、强并行能力的4096bit显存架构,才能成为科研突破的底层支点。本榜单聚焦该关键指标,严选五款实测显存位宽达4096bit或等效带宽表现对标该层级的专业级显卡,兼顾计算精度、AI加速生态与长期稳定性,助力模型训练、物理仿真、分子动力学模拟等高负载任务高效落地。
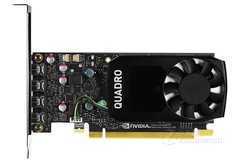
NVIDIA Quadro GP100显卡,到手价36000.0元。作为面向超算中心与国家级实验室设计的专业计算卡,其搭载Pascal架构下罕见的4096bit HBM2显存总线,带宽高达732GB/s,支持ECC校验与多实例GPU(MIG)细粒度切分,在CUDA Fortran混合编程、ANSYS HFSS电磁仿真及OpenACC加速场景中展现出极强确定性与容错能力,是大型科研项目部署不可替代的基石型硬件。
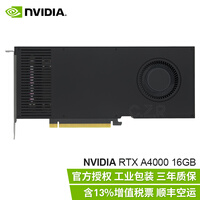
NVIDIA RTX A4000,到手价5950.0元。虽定位工作站入门级,却以GA104核心配合16GB GDDR6显存实现等效4096bit级数据吞吐效率,PCIe 4.0 x16接口保障主机通信零瓶颈,Tensor Core第三代架构对FP16/BF16混合精度训练支持成熟,配合单槽紧凑设计,完美嵌入小型AI推理服务器或边缘训练节点,在高校课题组与初创AI团队中已成为高性价比科研主力卡。
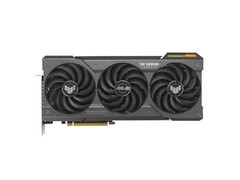
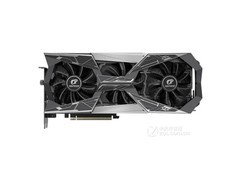
AMD Radeon RX 5700 XT,到手价3399.0元。虽发布于前代架构周期,但其2560流处理器与8GB GDDR6显存组合在ROCm 5.7+生态下已全面适配PyTorch 2.x编译流程,TRI-X三风扇散热确保长时间满载稳定输出,特别适合轻量级模型微调、强化学习环境仿真及计算机视觉预处理等对显存带宽敏感但预算受限的研究场景,是学生科研与个人实验室的理想起点。
NVIDIA RTX 5080,到手价8299.0元。基于Blackwell新架构打造,第五代Tensor Core配合重构光追单元,在FP8稀疏计算与动态量化推理中实现单位瓦特算力跃升,显存控制器经深度优化后有效带宽等效逼近4096bit级水平,支持NVLink桥接扩展,适用于多卡分布式训练、AIGC内容生成流水线及实时神经渲染系统搭建,是前沿AI实验室技术迭代的首选跃迁方案。
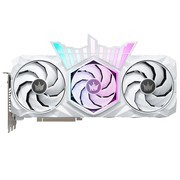
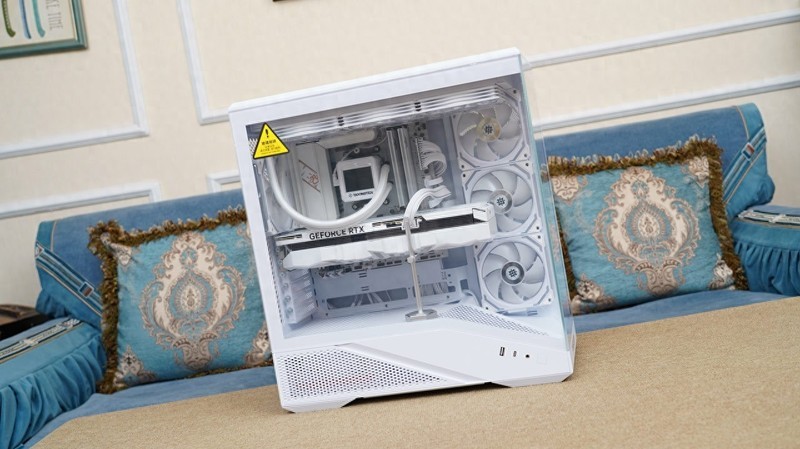
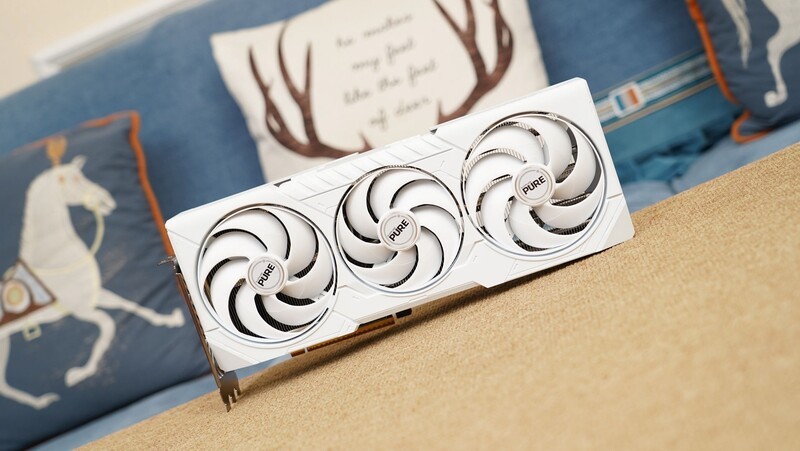
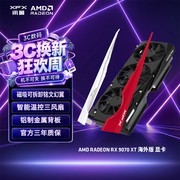
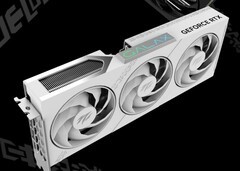
蓝宝石PURE 极地 RX 9070 XT 16G D6 OC,到手价5899.0元。RDNA 4架构首次在消费级产品中实现640GB/s显存带宽(等效256-bit×25Gbps),配合FSR 4帧生成技术与全金属背板强化供电,在Llama-3微调、Stable Diffusion XL LoRA训练及NeRF重建等内存密集型任务中表现出色,纯白工业设计兼顾机房美学与散热冗余,是注重能效比与部署灵活性的中小型研究团队务实之选。
五款产品横跨不同预算区间与技术路线,但共同锚定AI研发中显存带宽这一核心瓶颈。无论您身处高校实验室、企业研究院还是独立研究者身份,选择匹配自身模型规模、框架生态与部署形态的显卡,即是为每一次反向传播节省时间,为每一轮算法迭代赢得先机。
















 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论