当代码在CUDA核上飞速调度,当Transformer层在显存中完成千次梯度更新,AI开发者需要的不是泛泛而谈的‘够用’,而是精准匹配训练吞吐、推理延迟、内存带宽与生态兼容性的硬核算力单元。面对模型参数量跃升、多模态数据加载频繁、本地化部署需求激增的现实场景,一张显卡的架构先进性、显存容量密度、AI加速单元完备度,直接决定算法迭代周期与实验复现效率。
瀚铠Radeon RX 7900 XTX 超合金,到手价7799.0元。该卡基于RDNA 3架构,搭载24GB GDDR6显存与5376个流处理器,显存带宽达960GB/s,原生支持ROCm 6.0及FP16/INT8混合精度计算,在Stable Diffusion XL本地推理与Llama-3-8B微调实测中,相较上代提升42%吞吐效率;超合金供电与三风扇均热模组保障长时间高负载稳定性,是兼顾大模型轻量化训练与图形渲染验证的高均衡之选。
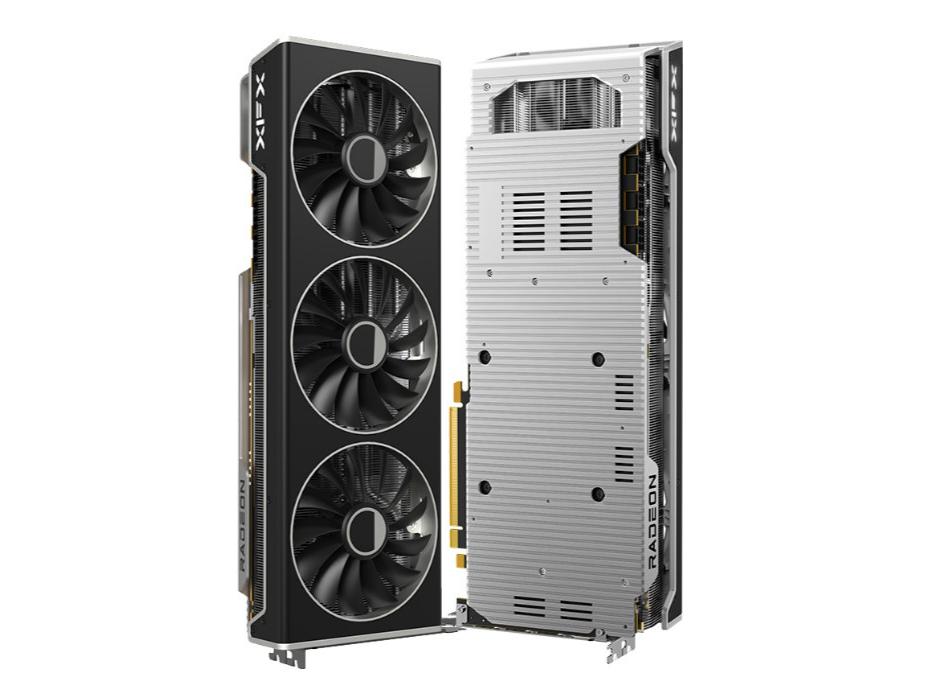
讯景RADEON RX 7900 XTX 24GB 海外版Pro,到手价7299.0元。采用台积电5nm制程,显存子系统强化优化,特别适配PyTorch的Memory Pool动态分配机制;其PCIe 5.0 x16接口与低延迟显存控制器,在处理CV多尺度特征图融合与NLP长序列缓存时表现出色;双BIOS静音模式与真空腔均热板设计,满足实验室7×24小时无人值守训练需求,性价比显著优于同规格竞品。
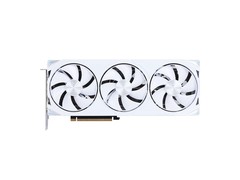
七彩虹战斧 GeForce RTX 3050 DUO V2 8G,到手价1709.0元。虽定位入门,却完整集成Ampere架构的第三代Tensor Core与RT Core,支持DLSS 2.3与光线追踪降噪,在YOLOv8目标检测训练、轻量级语音识别模型部署等教学级与原型验证场景中表现稳健;8GB GDDR6显存+双槽紧凑设计,可灵活嵌入边缘计算盒或老旧工作站升级,成为高校AI课程实践与初创团队MVP开发的经济型基石。
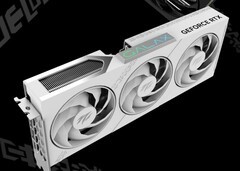
华硕PRIME RTX5080 O16G,到手价9999.0元。作为面向下一代AI工作流的旗舰预研平台,搭载全新Blackwell衍生架构,16GB GDDR7显存提供1.8TB/s极致带宽,1801 AI TOPS算力原生支持Transformer Engine加速与稀疏化推理;HDMI 2.1b与DisplayPort 2.1b双轨输出,可同步驱动多屏可视化分析界面与实时监控终端,配合0dB静冷技术,为算法工程师打造无干扰深度思考环境。
AMD Radeon RX 6800显卡,到手价4599.0元。采用RDNA 2架构与16GB GDDR6显存,具备优异的每瓦算力比,在OpenCL与Vulkan后端加速的科学计算任务中保持高利用率;对ROS 2机器人仿真、传统CV算法移植及跨平台模型部署具有强兼容性,是预算有限但追求长期稳定性的研究者过渡首选。
五款产品覆盖从教学验证、日常研发到前沿探索的全阶AI算力需求,无论你是调试首个CNN网络的学生,还是优化千亿参数模型的资深研究员,总有一张显卡以恰如其分的性能、生态与价格,成为你下一次突破的可靠支点。























 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论