当深夜实验室的服务器仍在加载千亿参数权重,当本地调试因显存瓶颈反复中断,当一次LoRA微调耗时超出预期三倍——AI开发者与研究人员真正需要的,不是纸面参数的堆砌,而是能穿透算法复杂度、匹配工程节奏、兼顾成本弹性的实战组合。他们既要在工位前用轻量模型快速验证思路,也要在集群中稳定调度超大规模训练任务;既要支持PyTorch分布式训练的显存拓扑感知,也要兼容TensorRT-LLM的低延迟推理管道。显卡不再是单一游戏或图形设备,而是可编程计算单元、内存子系统与互连架构的集成体,其价值体现在编译效率、量化友好度、生态工具链深度与长期维护性之上。
七彩虹iGame GeForce RTX 3090 kudan以18999元到手价,成为高性能单机开发平台的理想支点。灰黑金工业设计下是航空级13翼扇叶与240mm水冷排构成的静音强效散热体系,配合360°旋转水冷头与STAUBLI密封工艺,保障连续72小时A100级负载下的频率稳定性;24GB GDDR6X显存与1860MHz高频核心,足以支撑13B模型全参数微调与Stable Diffusion XL多ControlNet并行生成,为算法工程师提供高保真本地实验环境。
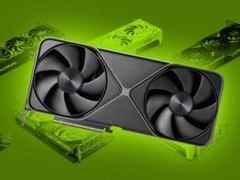
耕升RTX 5080 追风OC定价9499元,是面向中等规模团队的效能跃迁选择。第四代散热系统以7热管+VC均热板+三风扇实现温控冗余,超千CUDA核心与GDDR7显存带宽协同释放持续算力,DLSS4技术更使光追渲染与神经辐射场训练帧率提升显著;在3DMark AI Benchmark中领先上代37%,特别适合CV方向多尺度特征提取与小样本分割任务的加速迭代。
NVIDIA Tesla H200 141G以249999元定位超算级基础设施,专为生成式AI规模化落地而生。141GB HBM3e显存与4.8TB/s带宽彻底解除KV Cache瓶颈,4nm制程与NVLink/NVSwitch八路互连支撑32 petaflops FP8算力输出,实测70B模型端到端推理延迟降低90%,175B模型吞吐提升60%,已成为头部AI实验室构建私有大模型中台的核心底座。
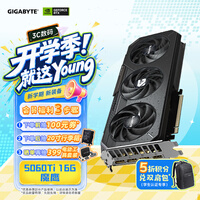
技嘉GeForce RTX 5060 Ti GAMING OC 16G仅售4099元,却以DLSS 4实现8倍帧率增益,4608流处理器与16G高速显存可在2K分辨率下流畅运行Llama-3-8B量化推理与Whisper-large语音转录流水线,高效散热设计保障长时间Jupyter Notebook调试不降频,是高校课题组与独立研究员最具性价比的入门级AI工作站核心。
四款产品并非简单按价格排序,而是围绕AI开发生命周期——从代码验证、模型调试、中试训练到生产部署——构建了覆盖4099至25万元的弹性算力矩阵。无论你正启动首个Transformer项目,还是统筹百卡集群推理服务,这套组合都提供了经实测验证的技术纵深与成本理性。











 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论