深夜调试完Transformer模型,GPU显存占用刚回落,服务器队列又排到明天——这早已是AI开发者与研究人员最熟悉的日常。当开源模型参数规模突破十亿、多模态训练任务频繁切换、本地验证需求日益迫切,一张响应迅速、生态兼容、功耗可控的显卡,不再只是图形加速器,而是科研节奏的节拍器、实验迭代的加速键、论文复现的可靠支点。我们聚焦真实开发场景:既要支持CUDA 12.x与最新cuDNN版本,又要兼顾TensorRT部署、ONNX导出及混合精度训练稳定性;既需满足单机轻量微调,也得为后续多卡分布式预留扩展空间;更重要的是,在预算约束下实现单位算力成本最优解。
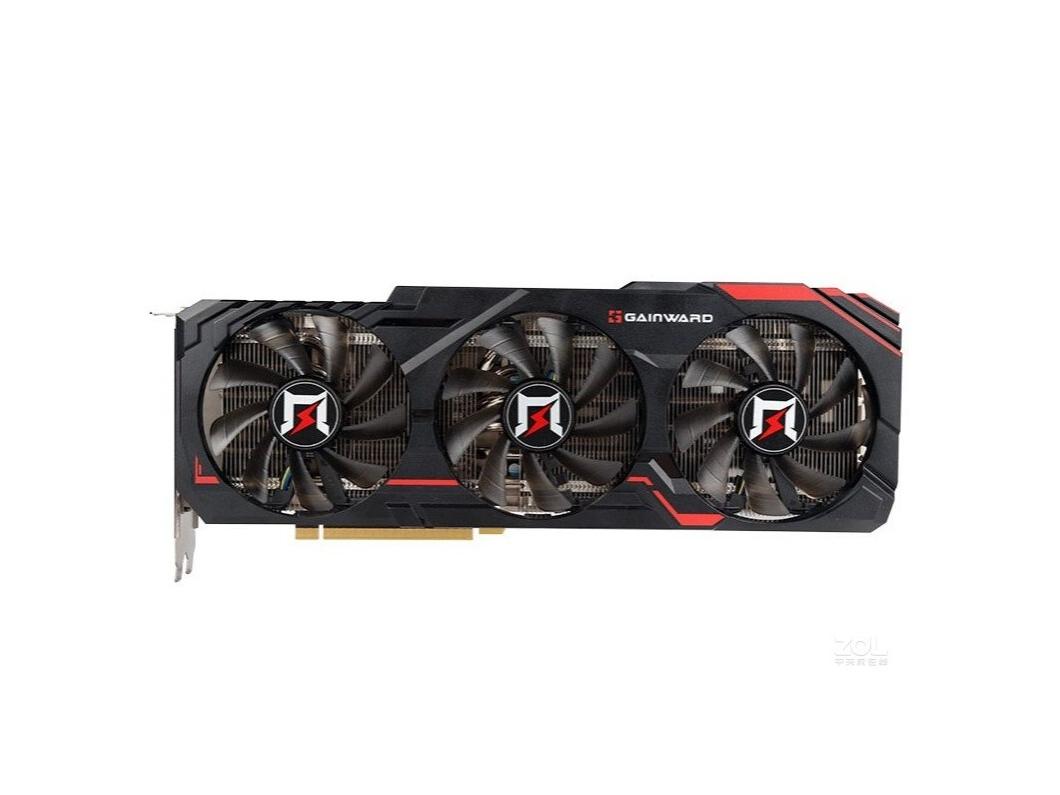
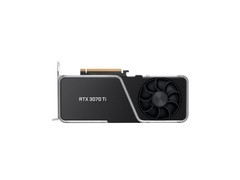
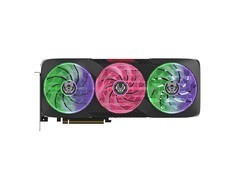
耕升GeForce RTX 3080 Ti 追风,到手价8999.0元,是当前面向中等规模模型本地训练与推理的理想旗舰选择。其GA102核心拥有10240个CUDA核心与320个Tensor核心,24GB GDDR6X显存带宽达912GB/s,实测在BERT-base微调任务中较RTX 3070提速近70%,同时支持PCIe 4.0 x16全速互联与NVLink双卡桥接(需主板支持),配合其定制三风扇+均热板复合散热系统,可连续运行ResNet-50全量训练超8小时无降频,特别适合高校实验室搭建小型训练节点或初创团队构建模型验证平台。
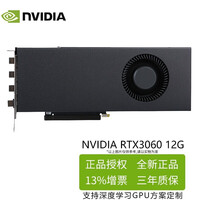
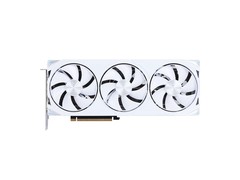
NVIDIA GeForce RTX 3060 12G,到手价3899.0元,堪称AI开发者入门与进阶之间的黄金支点。12GB大容量显存显著缓解ViT、Stable Diffusion等显存敏感型模型的OOM压力,实测可在FP16模式下流畅运行Llama-2-7B量化版本地推理;3584流处理器与第二代RT Core保障3D仿真可视化、NeRF重建等跨领域任务效率;DLSS 2.3与CUDA 11.4完整支持,使其成为Kaggle竞赛选手、CV/NLP课程实践者及独立研究者的高性价比主力卡。
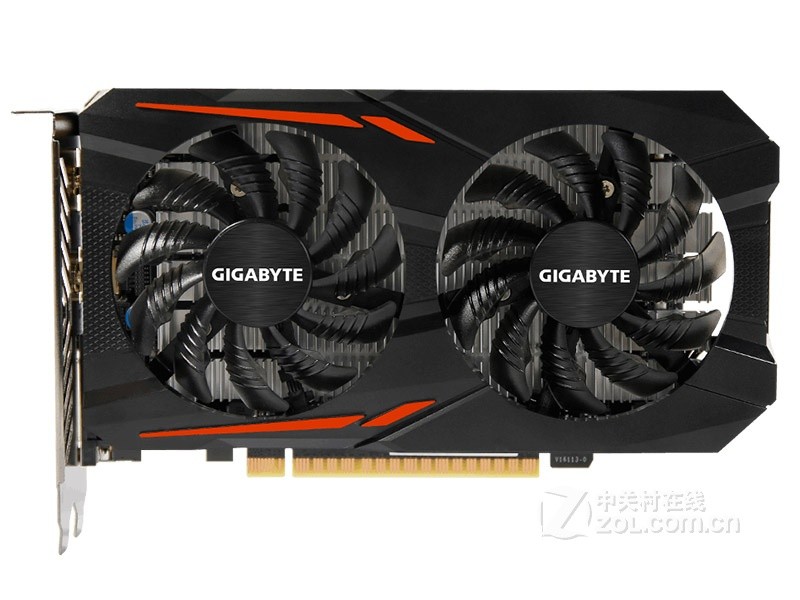
技嘉GTX 1050Ti OC 4G,到手价1049.0元,是轻量级AI教学、基础算法演示与嵌入式AI原型开发的务实之选。虽定位前代架构,但其完整支持CUDA 10.2及cuDNN 7.6,在TensorFlow 1.x与PyTorch 1.8等经典教育框架下稳定运行CNN图像分类、RNN时序预测等基础实验;4GB显存足以承载YOLOv3-tiny目标检测全流程,HDT热管直触设计确保编译与调试期间静音低热,配合三年联保,成为高校计算机系AI通识课实训机房与学生个人笔记本外接显卡盒的可靠基石。
从千行代码的模型调优,到一行命令的环境部署,显卡已深度融入AI研发毛细血管。这三款产品并非简单按价格分层,而是围绕实际科研生命周期构建的弹性算力梯队:高端卡支撑创新验证,主流卡承载日常迭代,入门卡护航学习启蒙。双11之际,以理性配置替代盲目堆叠,让每一分预算都转化为可落地的模型收敛速度、可复现的实验结果与可交付的技术沉淀。


 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论