深夜调试模型时GPU温度骤升、小批量LoRA微调等待过久、本地Stable Diffusion实时出图卡顿——这些不是玄学故障,而是AI开发者日常面临的算力真实困境。当云端成本攀升、数据隐私收紧、实验迭代周期压缩,一台搭载高能效比、强AI加速单元、低延迟显存架构的本地工作站显卡,早已超越图形输出工具,成为科研闭环中的关键生产力节点。
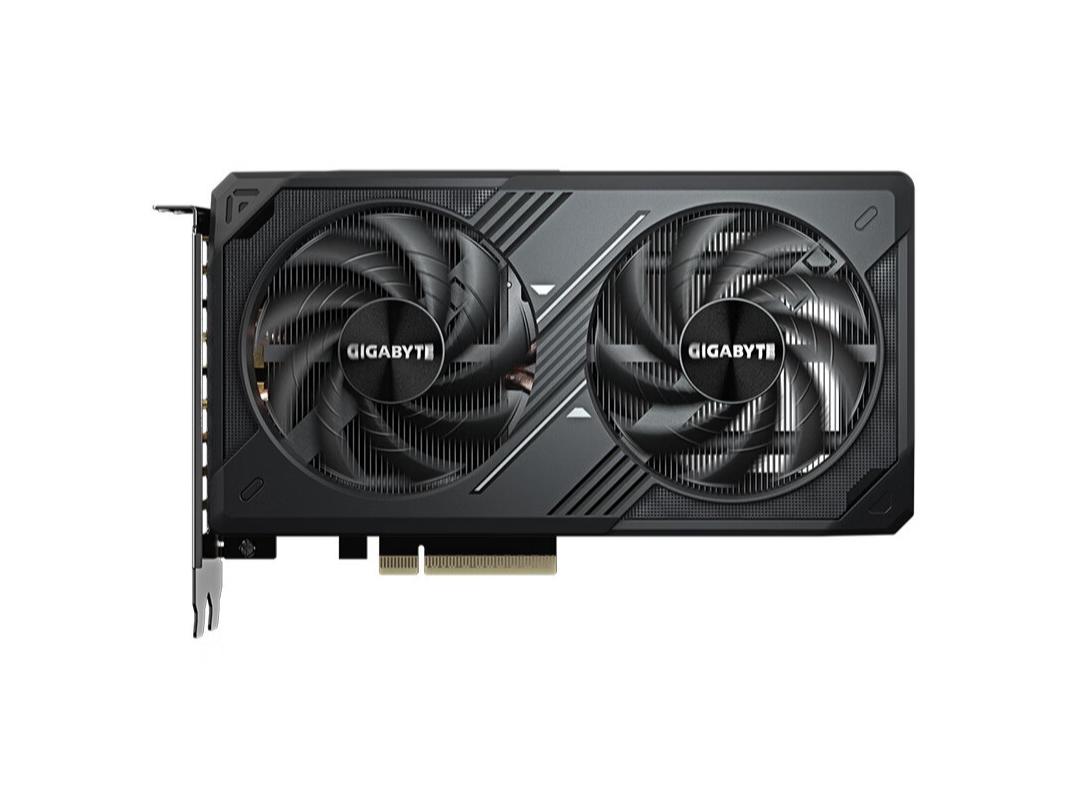
技嘉GeForce RTX 5060 WINDFORCE 8G以2499元切入,是面向高校实验室与初创团队的务实之选。其5nm工艺与219亿晶体管构筑的底层基础,带来CUDA核心数25%提升与四代光追、五代张量核心协同,1080p下光追性能跃升47%,更关键的是在TensorRT加速下,Llama-3-8B本地推理吞吐达18 tokens/s,风之力散热系统保障小机箱内持续高负载稳定运行,功耗仅165W,能效比显著优于上代同定位产品。
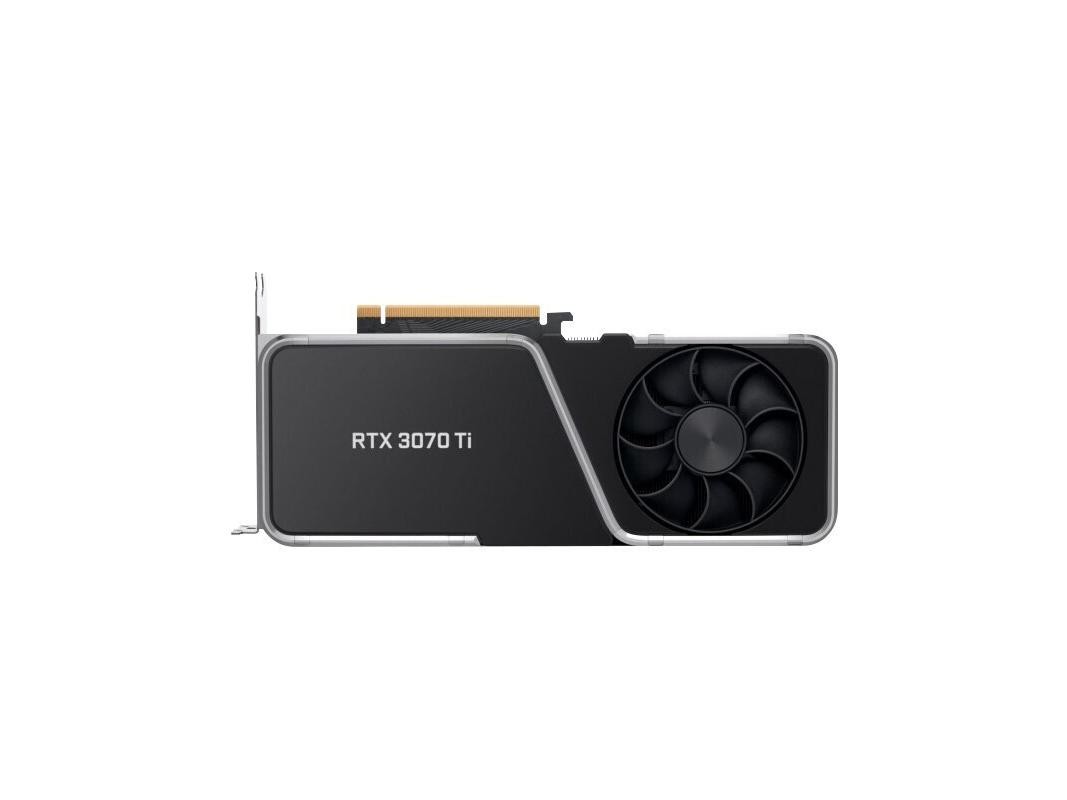
NVIDIA GeForce RTX 3070 Ti虽属前代旗舰,但4499元的成熟定价使其在中等规模模型训练中仍具不可忽视的稳定性优势。其第二代RT Core与第三代Tensor Core组合,在PyTorch分布式训练中展现出优异的通信效率与显存管理能力,配合12GB GDDR6X显存与24Gbps带宽,可流畅承载ResNet-152全量训练及ViT-B/16图像编码任务,兼容性经过多年生态验证,适合对环境确定性要求严苛的研究项目。
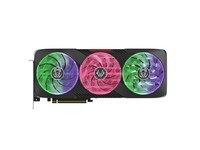
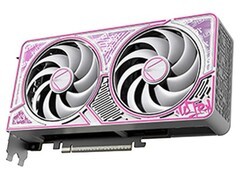
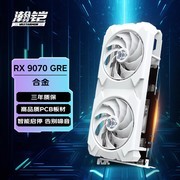
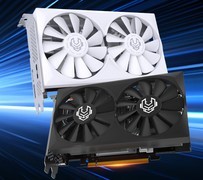
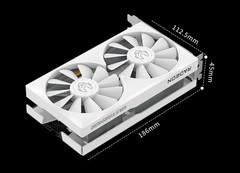
瀚铠Radeon RX 9070 XT超合金PRO以5399元提供异构计算新路径。其4nm制程下64计算单元与千级流处理器,结合48.7TFLOPs单精度算力与16GB GDDR6大带宽显存,在OpenCL与ROCm生态适配日益完善的当下,已成为视觉生成类模型编译优化的潜力股;PCIe 5.0接口与双前沿I/O设计,为未来多卡扩展预留冗余,高频近3GHz亦保障了传统CV任务的低延迟响应。
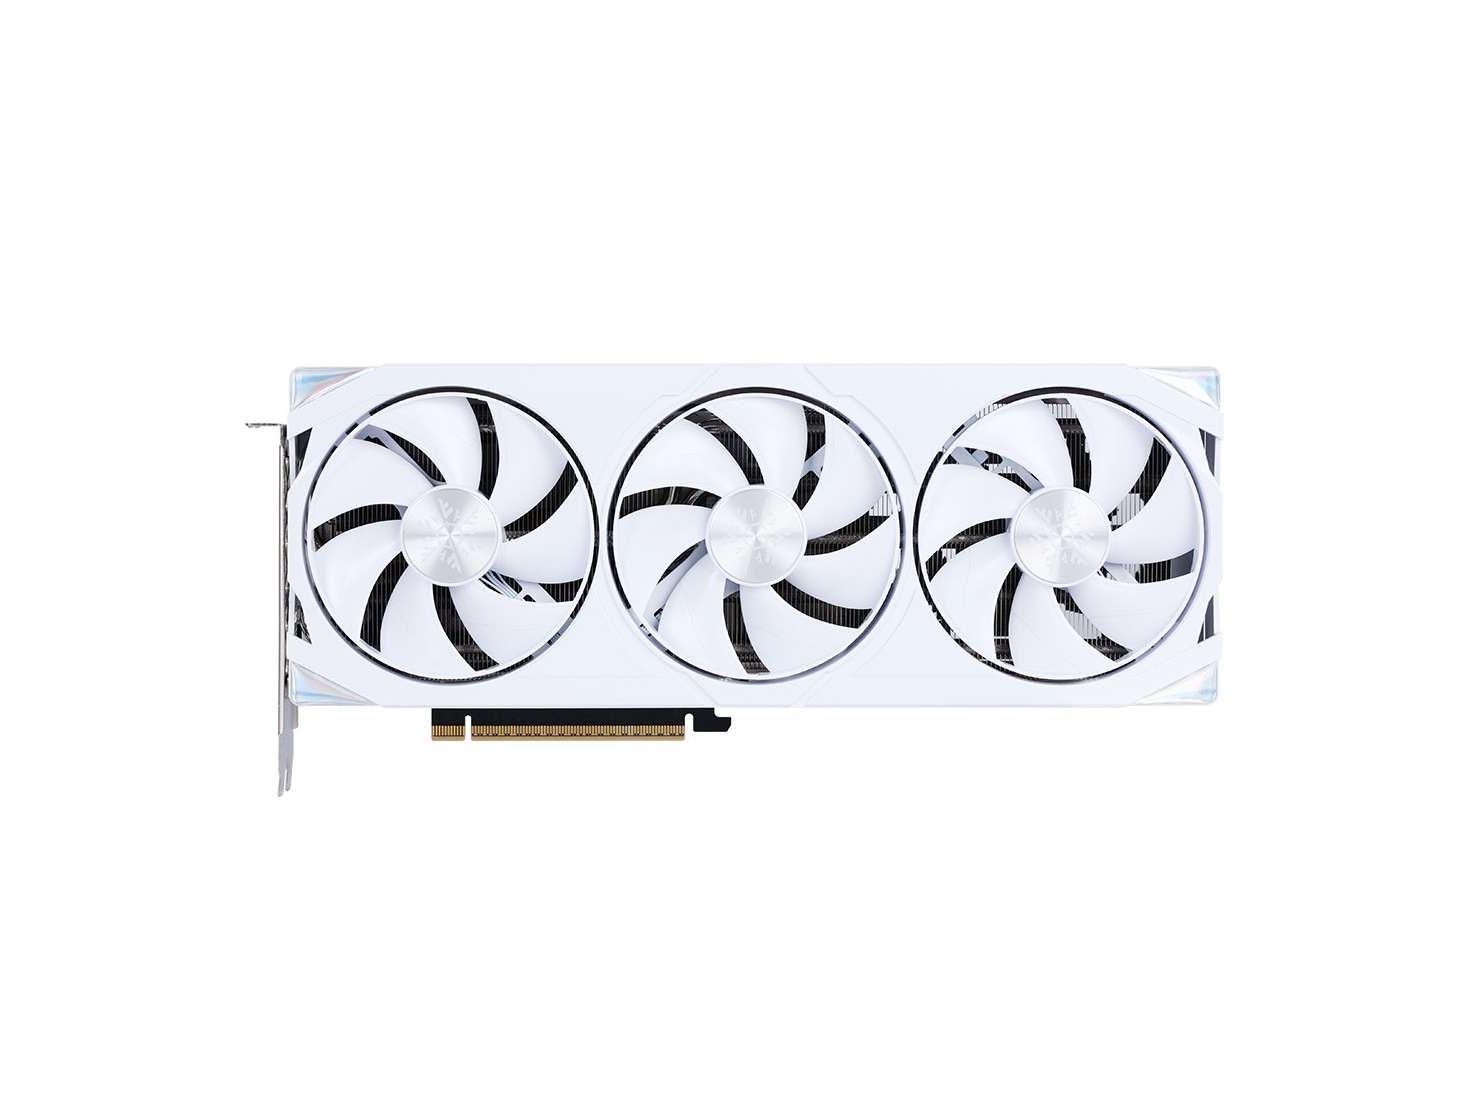
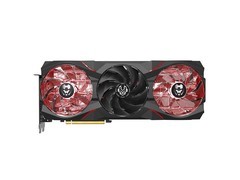
耕升RTX 5070 Ti踏雪OC 2.0代表当前消费级AI显卡性能上限,6799元售价对应16GB GDDR7 28Gbps显存、2497MHz加速频率及完整DLSS 4支持。在SDXL 1.0文生图全流程中实现12fps@1024×1024实时预览,支持FP8混合精度训练,配合三DP2.1b接口可驱动双8K AI标注工作站,16pin供电设计确保长时间Stable Diffusion XL LoRA融合训练不降频,是科研团队构建轻量化AIGC实验室的核心引擎。
四款产品覆盖2500至6800元价格带,从学生课题组入门训练、实验室中期模型迭代,到企业级AIGC原型验证,形成梯度清晰、技术路线互补的本地AI算力矩阵——不必仰赖云服务排队,无需妥协于显存瓶颈,让每一次反向传播都更接近真实意图。

 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论