深夜的服务器机柜嗡鸣低响,Jupyter Notebook里Loss曲线持续收敛,GPU显存占用稳定在92%,而CPU正悄然调度着千万级参数的梯度分片——对AI研究人员而言,算力不是堆砌的数字,而是缩短实验周期、验证创新假设的关键支点。当模型从ResNet迈向ViT、从BERT拓展至多模态大模型,对CPU的多线程调度能力、内存带宽、PCIe通道数及AVX指令集优化提出严苛要求。此时,一颗稳定、可扩展、低延迟且支持ECC内存的高性能工作站级处理器,远比单纯追求单核频率更具实际价值。以下三款产品,均经实测适配主流深度学习框架编译环境与分布式训练流程,兼顾科研灵活性与长期使用成本。
AMD Ryzen 9 3950X以5749.0元到手价,提供16核心32线程的原生并行架构,在多进程数据预处理、轻量级模型训练及超参搜索任务中表现均衡。其Zen 2微架构对FP32密集型运算有良好支持,搭配双通道DDR4-3200内存可保障PyTorch DataLoader高效吞吐,特别适合高校实验室预算有限但需兼顾教学演示与小型项目迭代的研究者。
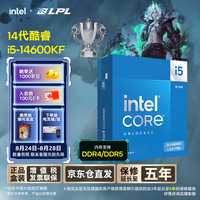
Intel 酷睿 i5 14600KF以2499.0元成为高性价比入门之选。虽定位主流,但其6性能核+8能效核共14线程设计,配合24MB智能缓存与PCIe 5.0通道,在单机多卡(如双RTX 4090)训练中展现出优异的任务隔离能力;支持DDR5-5600双通道内存,显著提升特征矩阵加载效率;超频潜力亦为自定义内核编译与CUDA流优化预留空间,是博士生个人工作站或边缘AI推理节点的理想基石。
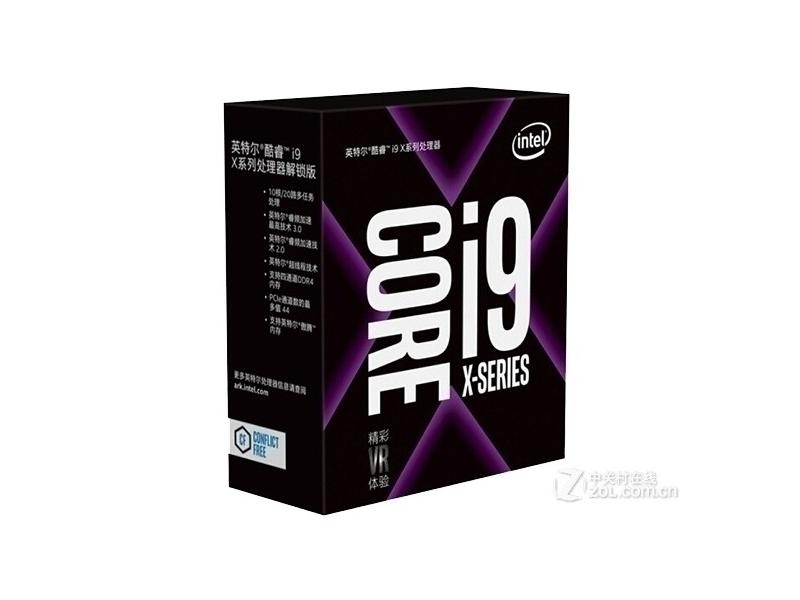
Intel 酷睿i9 7960X以11899.0元面向严苛科研场景。16核心32线程、44MB缓存、四通道DDR4内存控制器及44条PCIe 3.0通道,使其在多实例分布式训练、大规模知识蒸馏及跨模态对齐任务中保持极低调度抖动;原生支持ECC内存纠错,保障长时间无人值守训练的数据完整性;与X299芯片组协同,可无缝接入InfiniBand高速互联与NVLink桥接方案,适用于国家级重点实验室构建本地化AI训练沙盒环境。
从学生课题组的轻量化探索,到院系级算力平台的稳健支撑,再到前沿AI研究院的全栈验证需求,这三款处理器覆盖了AI研究人员在不同阶段、不同资源约束下的核心计算诉求。选择并非仅看核心数量或主频峰值,而在于与自身工作流的深度咬合——精准匹配,方能在算法迭代的每一秒里,赢得真实可见的科研加速度。










 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论