许多初学本地部署的小伙伴在看到”7B”的模型名称时,第一反应是:我的卡还跑得动吗?其实只需要一个公式,就可以简单估算出你的目标需求!
1、【B】是什么?
就像说一个人"身高175",你得先知道单位是厘米。模型名字里的B也有单位——B是Billion,也就是"十亿"。
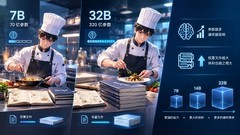
举个例子:把模型想象成一位学徒厨师。7B就是这位厨师记住了70亿条做菜经验,32B是记住了320亿条。经验条数越多,手艺通常越好;但记满经验的笔记本(也就是权重文件)也就越厚、越占地方。所以B越大,模型越聪明,同时也越吃硬件。
2、模型同样参数,为什么体积差好几倍?
同一部电影,蓝光原盘40GB,压缩版只要2GB——看着差不多,体积差了二十倍。
模型也是这个道理。同一系列(Qwen、DeepSeek这些)常有参数量一样、体积差好几倍的版本,差别在每个参数占多少字节,也就是"位数":
同一个7B模型,FP8版约7GB,换成FP4只要3.5GB。把位数往下压缩这个操作,叫量化。理论上,数字越大越接近原版,模型也更聪明,但也越占显存。
文件名中的FP、INT、Q是什么?
拿个真名看:Qwen3.8-27B-Q4——27B是参数量,Q4是压到4位,另外Q4和FP4是同一档位的两种叫法。
4、基础权重公式
只算权重的话,显存公式如下:
这里的权重,指的是模型里那几十、上百亿个数字,比如7B的70亿个参数,模型大脑内的东西都在里面。下图以32B模型的不同精度去使用这一公式为例:
这就像去超市买米。32B的模型是你要买的32斤米,Q4是“一斤米装半个袋子”,套进公式算出来的结果,就是“至少需要几个袋子才装得下”。而这几个袋子,就是你的显卡必须拿得出的显存。
5、别忘了“活”的显存
上面的公式算的是权重显存,是相对固定的。但大模型运行还需要占用一块“活”的显存——对话记忆(KVCache),可以理解为上下文。
对话聊得越长,它占得显存就越多,所以显存还需预留2GB左右才更稳妥。
6、实际显存公式
系统、框架运行也会占用一定显存,所以实际选卡时,要在权重显存基础上多留约5%给系统开销,再留2GB左右给上下文,不把显存卡在临界值。
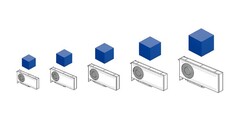
7、一图看懂模型与显卡的选择
上表显存按FP4量化/8K上下文的对话为例
以目前主流的Qwen3.8-27B_Q4模型为例:权重27B,Q4每参数占0.5字节,实际占用约为:27x0.5x1.05+2=16.175(GB),至少需要16GB显存的显卡才能运行。
例如RTX5080 星曜LUNAOC,配备16GBGDDR7显存,AITOPS高达1801,面对27B-Q4级模型,合理设置量化档位与上下文长度后即可流畅运行;可助力你流畅运行本地部署的大语言模型,日常14B级问答、写文案更是轻松胜任。
















 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论