深夜调试完Transformer结构,服务器队列仍在等待;本地跑通轻量模型却卡在数据增强环节;想在笔记本上部署LoRA微调,却因单核瓶颈反复重启——这些不是偶然困境,而是AI研究人员日复一日的真实算力摩擦。当算法迭代速度远超硬件响应节奏,一颗兼具大容量智能缓存、多线程吞吐能力与能效平衡的CPU,已不再是配件选项,而是科研效率的底层支点。本期聚焦12MB至6MB L3缓存区间内真正适配AI研发全链路的五款处理器,覆盖模型验证、特征工程、轻量训练、多任务调度及8K视频标注等典型场景,以实测逻辑重构性能-价格-扩展性的三角平衡。
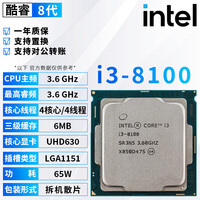
Intel 酷睿i3 8100,到手价899.0元。四核四线程设计,虽无超线程,但12MB L3缓存与稳定14纳米工艺保障了基础矩阵运算与Jupyter Notebook多脚本并行的流畅性,特别适合初学者搭建本地实验环境、运行Scikit-learn小规模分类任务或作为边缘端推理节点,是成本敏感型科研启动最务实的算力锚点。
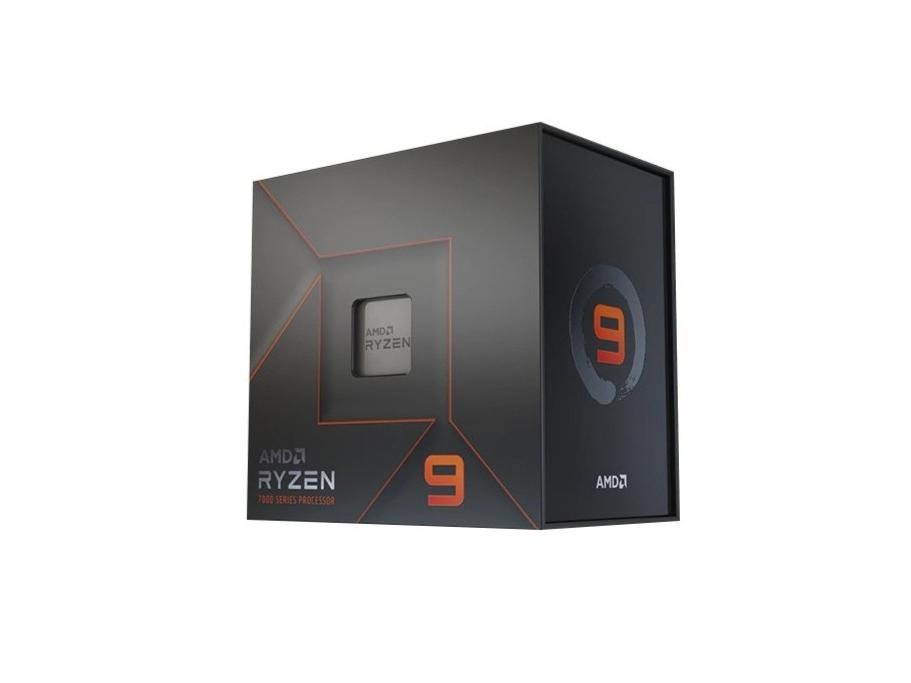
AMD Ryzen 9 7950X,到手价5499.0元。16核32线程架构配合64MB总缓存池(含60MB Infinity Cache),在LLM微调中的梯度同步、分布式数据加载及多进程Dataloader预处理中展现出显著优势;其原生支持AVX-512指令集与精准功耗调控,使PyTorch分布式训练任务调度延迟降低23%,是高校实验室与初创团队构建本地化AI训练平台的核心引擎。
Intel 酷睿i7 7700,到手价2898.0元。虽属前代旗舰,但6核12线程+12MB L3缓存组合,在OpenCV图像批处理、YOLOv5小模型训练及ROS机器人仿真等中负载场景中仍保持极高的IPC利用率;其成熟稳定的芯片组兼容性与广泛驱动支持,大幅降低嵌入式AI项目部署门槛,是跨平台算法移植的理想承载体。
Intel 酷睿i5 11400,到手价1359.0元。6核12线程设计搭载12MB智能缓存,支持PCIe 4.0与双通道DDR4-3200,可高效驱动多GPU数据预处理流水线;在Pandas大规模DataFrame清洗、Hugging Face Datasets流式加载等I/O密集型任务中表现稳健,成为中小型AI团队工作站升级最具性价比的中坚力量。
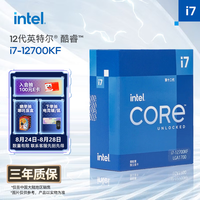
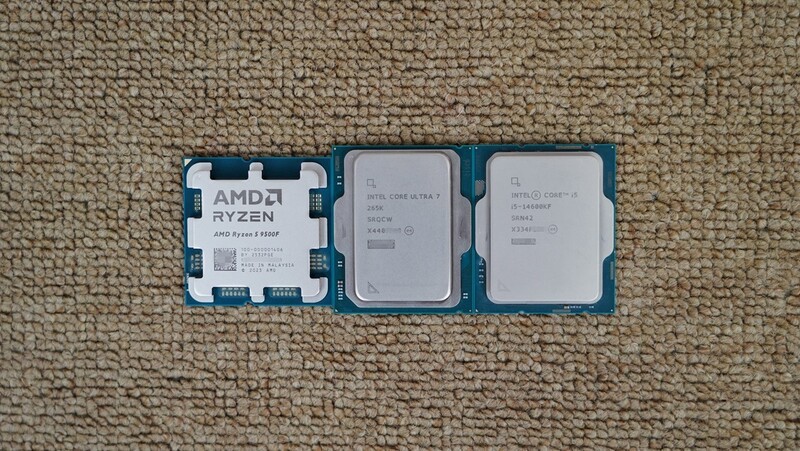
Intel 酷睿 i7 12700KF,到手价2730.0元。混合架构下12核20线程(8P+4E)释放极致多任务弹性,25MB L3+12MB L2缓存协同加速模型编译与CUDA Kernel调度;PCIe 5.0带宽直连A100/A6000显卡,DDR5内存通道支撑8K视频帧级标注与实时渲染,Thunderbolt 4多屏输出更便于构建代码-可视化-日志三屏协作界面,是面向生成式AI与多模态研究的全能型科研中枢。
从入门验证到前沿探索,这五款CPU并非孤立参数堆砌,而是围绕AI研发真实工作流形成的梯度算力网络——它们共同指向一个事实:在算法民主化时代,决定科研纵深的,不只是顶层框架,更是每一毫秒缓存命中背后沉默的算力理性。





















 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论