借助NVIDIA PAIR,本地AI智能体更易于安装、运行速度更快,并可调用家中多台RTX PC的算力;此外,全新NVIDIA RTX Spark Windows PC 将于10 月上市。
作者:GerardoDelgado Cabrera
前沿智能正在走向本地。在IFA 2026上,NVIDIA、微软及其合作伙伴携手提供更快的推理性能与全新工具,让智能体能够更轻松地在NVIDIA硬件上完成设置并实现本地运行。全新NVIDIA RTXSpark 小巧高能效桌面主机也将于10 月上市,为AI发烧友、开发者和创作者提供更多方式,在本地安全运行功能强大的智能体。
本次发布内容包括:
Hermes Agent、OpenClaw 与 Perplexity Portable Computer 即将为 NVIDIA GPU 提供更便捷的本地 AI 支持。
本地 AI 推理速度提升最高可达 1.9 倍——全新 llama.cpp 和 vLLM 优化现已发布,可直接使用或通过 LM Studio 体验,Ollama 的性能更新也即将推出。
NVIDIA PAIR——一款个人 AI 路由工具,可在用户本地网络的多台 PC 之间智能分配 AI 推理任务。
NVIDIA RTX Spark 将于 10 月上线——联想和宏碁将推出全新 Windows PC。EA、Embark 和育碧等最新加入的游戏发行商与开发者,正将旗下重磅大作带到 NVIDIA RTX Spark。
8月的本地AI领域更新:
Nemotron 3.5 Lightning 是一款 300 亿参数模型,现已发布,可在 NVIDIA RTX PC、RTX PRO 工作站、DGX Spark 和 Jetson 上运行。 智谱的 GLM-5.3-Flash 是一款多模态混合专家 (MoE) 模型,正将代理式 AI 带到 DGX Station。 千问已发布 Qwen3.8-Flash-Next,这是一款开放权重的多模态 MoE 模型,可在 DGX Spark 上本地运行;同时还发布了 Qwen3.8-27B,这是一款拥有 270 亿参数的开放模型,并为在 NVIDIA GPU 上运行本地智能体和编码工作流而优化。 LTX 的 LTX 2.5 是一款针对 NVIDIA RTX GPU、DGX Spark 优化的开放世界视频生成模型,借助全新 NVFP4、FastVideo 和 ComfyUI 增强功能,可实现更快、内存效率更高的本地生成。 MiniMax-H3 是一款支持音视频同步的开放权重视频生成模型,可通过 ComfyUI 在 NVIDIA GPU 上本地运行。FastVideo 携手 NVIDIA 研究人员发布 FastH3,进一步提升 MiniMax-H3 性能。FastH3 是一款开放权重的四步蒸馏版本,可将性能提升 7 倍。面向 NVIDIA RTX GPU 和 DGX Spark 优化的 FastVideo 方案即将推出。 Meta 的 Muse Glimmer 是一款面向编码和智能体工作流的 300 亿参数开放权重模型,可在 GeForce RTX PC、DGX Spark 和 Jetson 上本地运行。NVIDIA 还发布了支持 DGX Spark 的 NVFP4 量化,让本地部署的内存效率更高。 DeepSeek v4 Flash 是一款拥有 2,840 亿参数、130 亿活跃参数的混合专家 (MoE) 模型,可在由 2 台 DGX Spark 组成的集群上本地运行。
更轻松地启用本地智能体
要让本地智能体搭配本地模型顺利运行,过去往往需要投入不少精力:选择模型、寻找兼容的推理服务器、调整量化设置,以及持续维护和更新整个软件环境。如今,在RTX 和DGX系统上,这些使用门槛正在逐渐消失。
三款主流智能体应用将在Windows上提供简化的本地模型部署,均基于llama.cpp构建,并集成NVIDIA最新的推理优化。全新的部署体验可减少手动配置,让用户能够更加轻松地部署并运行本地智能体。
上个月,Perplexity推出PortableComputer智能体,将模型、编排和工具整合在统一的应用体验中,让用户可在NVIDIADGX Spark 等Linux系统上轻松地本地运行Perplexity。
PerplexityPortable Computer 现已支持运行Linux、搭载显存至少为24GB 的NVIDIA RTX GPU 的系统,Windows支持即将推出,为更广泛的PC用户带来简化的一站式部署体验。
用户可在本地运行完整的工作流,无需担心Token额度和费用;当任务需要额外研究或思考能力时,也可选择性地将任务的部分内容交给云端超过15款前沿模型之一来处理。PortableComputer 在将内容发送至云端前会请求授权,帮助用户将敏感信息保留在设备上。以下是一些使用示例:
工程:审查已连接 GitHub 仓库中的开放 Pull Request(PR),并将其分类为“可合并”,“受阻”, “已停滞”和“待审查”,同时为每个 PR 标注下一步操作。对于未能与最新合并内容保持同步的文档,系统会自动发现并修正,并为相关修改创建一个新的 PR。 金融:将智能体指向两年的券商账户汇总文件、合并 1099 税表及报税申报表,让它追踪反复出现、造成最多可避免费用和税务拖累的持仓,并为每一项数字精确标注对应的文件和页码——整个过程中,任何文档都无需上传至聊天机器人或发送到云端。 初创企业:询问“为什么用户激活率趋于停滞?”,智能体会在本地分析漏斗数据导出文件,找出新用户从安装到完成首个任务之间的流失环节,然后将最关键的洞察直接发布到团队的 Slack 频道。
Hermes Agent由NousResearch 开发的Hermes Agent是一款拥有数百万用户的通用智能体,以可靠性和自我改进能力见长。Hermes不依赖特定模型或服务提供商,旨在本地系统上全天运行,因此非常适合部署在RTX PC、RTXPRO 工作站和DGX Spark上。
即将推出:在Hermes中配置本地模型,将为用户在Windows 和Linux 的RTX 与DGX系统上提供一键式部署。该智能体会自动检测NVIDIAGPU,选择合适的模型和配置,并通过已集成NVIDIA推理优化的llama.cpp运行,无需手动下载模型和调优步骤。
启动后,Hermes的工作方式与在其他环境中一致。它会使用工具、在任务之间保持上下文信息、跨会话记忆信息,并随着时间推移创建可复用技能,让智能体在持续使用中不断提升能力。将模型在本地GPU上运行,可在保持高性能的同时将数据留在本地系统中。
一键式本地模型设置即将推出。查看链接了解更多HermesAgent 详情。
OpenClaw已成为开放智能体浪潮中最具标志性的项目之一——它是GitHub上规模最大的AI 项目,拥有超过38万颗星标(stars),并拥有快速增长的社区,其成员正在为研究、工程、项目管理和日常生产力场景构建工具与技能。
NVIDIA、微软与OpenClaw携手合作,让这套体验更易于在Windows PC上实现。为降低上手门槛,OpenClawWindows 应用简化了本地模型的设置过程,可在任何至少配备24GB 显存的RTX GPU上完成优化配置。
更快推理性能,加速本地智能体
推理性能对于保持本地智能体的快速响应至关重要。NVIDIA将继续与开源社区中的llama.cpp 和vLLM 合作,加速NVIDIA各类本地平台上的智能体工作负载。
vLLM在两个DGX Spark集群上最高可达1.4倍性能提升。FlashInfer中的全新XQA注意力内核与后端优化,可加速这两类平台上的推理。
llama.cpp和vLLM推理后端现已获得性能提升。用户也可通过LM Studio 和Ollama应用体验性能提升。
借助NVIDIA PAIR 调用闲置PC,提升本地AI算力
超过一半的美国家庭拥有2 台或更多PC,其中大量算力在一天中的大部分时间处于闲置状态。NVIDIAPersonal AI Router(PAIR)是一款免费的开源软件工具,可让这些系统协同工作,为本地AI 提供算力。
[NVIDIA PAIR VIDEO:https://youtu.be/GjGM-ZKQMa0]
智能体工作流通常会将复杂任务拆分为可并行执行的小任务,但当所有推理请求都在争用同一块GPU时,性能可能会下降。NVIDIAPAIR 会自动发现本地网络中的兼容PC,并将相互独立的推理请求路由至具有可用算力的系统。它可与Ollama 和LM Studio配合使用,并随设备加入或离开网络自动调整。
例如,用户可创建一份“周日重整”计划,要求Hermes整理杂乱的收件箱,区分哪些事项需要立即处理、哪些可以稍后处理、哪些可以略过。Hermes可将工作拆分给多个子智能体,PAIR则将这些作业分发至可用PC,无需全部排队等待同一块GPU。
结果是,本地智能体可获得更多计算资源,让更多任务并行运行;同时,当主系统正用于游戏、内容创作或其他工作时,AI工作负载也可灵活迁移到另一台PC 上运行。
NVIDIAPAIR 测试版现已通过图形界面和终端界面登陆Windows、macOS和Linux,支持NVIDIAGeForce RTX 20 系列及更新GPU、NVIDIARTX PRO 桌面端GPU(图灵架构及更新)、NVIDIADGX Spark,以及Apple M4或更新款芯片。
CyberLink PhotoDirector AI PC 模式在RTXSpark 上带来强大的端侧照片编辑
开放图像和视频模型让创作者可在PC 上试验创意AI模型,快速迭代并探索概念与想法,无需再担心Token用量,同时将更多创作内容保留在设备本地。
CyberLink全新的PhotoDirectorAI PC 模式是首批将这些扩散模型直接集成至创意软件的应用之一,让模型成为创作者触手可及的创意工具。该模式将随PhotoDirector365 推出,并针对NVIDIA RTXSpark 优化。AIPC 模式为用户提供由AI驱动的编辑工具,包括生成式编辑、图像增强、对象与干扰物移除、背景移除和替换、人像优化,以及创作全新视觉内容;用户可根据任务灵活选择本地或云端处理。
在NVIDIA GPU上,PhotoDirector借助TensorRT-RTX和FP8 加速本地AI。
立即开始使用CyberLinkPhotoDirector 365 照片编辑软件,并了解更多将于10 月随RTX Spark推出的PhotoDirectorAI PC 模式详情。
NVIDIA RTX Spark Windows PC 将于2026年10月上市
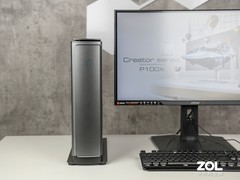
NVIDIARTX Spark 将于今年10 月上市。在IFA 2026上,合作伙伴正展示相关硬件。全新发布的产品设计将与现有6 家OEM厂商的产品一同于10月出货。宏碁展示了RTX Spark高能效桌面主机的概念设计,联想则发布了Yoga Pro 9n和Yoga 9n二合一设备。
RTXSpark 是Windows PC新的开始:一台专为创作者、玩家和AI 智能体打造的PC。凭借强大的1 PetaflopRTX Blackwell GPU、最高128GB统一内存和高能效20 核GraceCPU,RTXSpark可提供出色的性能与能效。这款超级芯片可为高性能、轻薄且具备全天续航的笔记本电脑和小巧、高能效的桌面主机提供动力,支持始终在线的智能体。搭配全新WindowsAgent 框架,智能体可在操作系统级管控下安全地在后台运行。
上周在科隆游戏展上,EA、Embark和育碧等最新加入的游戏发行商与开发者,正将旗下重磅大作带到NVIDIA RTXSpark Windows PC。它们加入了今年5 月在COMPUTEX上宣布支持RTX Spark的发行商行列,包括KRAFTON、网易、拳头游戏和XBOX。查看页面了解更多详情。
#别错过:NVIDIA本地AI的更多更新
? NVIDIA在科隆游戏展带来全新RTX技术和游戏——NVIDIA发布DLSS 4.5光线重建,采用全新第二代Transformer模型,可提升光线追踪和路径追踪游戏的图像质量。科隆游戏展还带来了《007初露锋芒》(007First Light)、《控制:共振》(CONTROLResonant)和《战争机器:事变日》(Gearsof War: E-Day) 等游戏的全新RTX消息,即将推出的NVIDIA RTXSpark 也将获得更广泛的游戏支持。
?DeepSeekHarness 正式推出——DeepSeek的全新开源Harness与DeepSeek-V4-Flash搭配使用,可在多DGX Spark配置上为本地智能体编码工作流提供动力。
?MLPerfClient v2.0 扩展AIPC 基准测试——MLCommons发布了与NVIDIA及其他行业领导者合作开发的MLPerfClient v2.0。此次更新新增了代理式AI和图像生成基准测试,并扩展了面向现实本地AI工作负载的大语言模型(LLM)测试。
NVIDIARTX AI PC的相关信息请关注微博、抖音及哔哩哔哩官方账号,并订阅NVIDIA本地AI新闻通讯,及时了解最新动态。有关NVIDIA工作站的更多信息,请关注微信公众号。











 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论