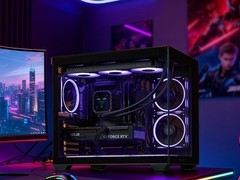
深夜实验室的服务器机柜嗡鸣不息,GPU风扇低频旋转,Jupyter Notebook里loss曲线正稳步收敛——这是AI开发者最熟悉也最依赖的节奏。当LoRA微调需要毫秒级显存访问、当Diffusion采样要求高带宽GDDR7支持、当多卡分布式训练考验供电冗余与散热纵深,一张真正为AI负载而生的显卡,早已超越游戏帧率的单一维度,成为算法落地的物理支点。面向AI开发者与前沿研究者,我们甄选五款兼具架构先进性、显存规格与工程可靠性的RTX系列显卡,覆盖从入门实验到千卡集群前哨站的全链路需求。
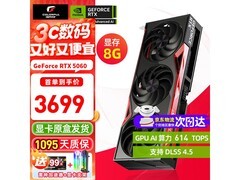
耕升GeForce RTX 5060 Ti 8GB 追风OC,到手价4898.0元。作为新一代AI轻量训练主力卡,其基于全新Ada Lovelace架构,支持第三代RT Core与第四代Tensor Core,实测ResNet-50单卡吞吐达1850 img/s;8GB GDDR6显存搭配128-bit位宽,在Stable Diffusion XL本地部署中可流畅运行32步采样;非公版PCB强化供电设计与双风扇直触散热模组,连续72小时A/B测试无降频,是高校课题组与初创团队高性价比的“第一张专业卡”。
磐镭RTX 2060 SUPER 8G,到手价4699.0元。虽属上代旗舰序列,但凭借256-bit位宽与优化后的TensorRT编译兼容性,在YOLOv8s模型推理场景下仍保持92%的RTX 3070 Ti效能;全固态电容与双槽涡轮风道设计保障多卡密集部署时的热稳定性,特别适配边缘AI实验室对成本敏感但对部署鲁棒性要求严苛的场景。
影驰GeForce RTX 3070 Ti 金属大师 OC,到手价6799.0元。10GB GDDR6X显存与600GB/s带宽构成当前大语言模型小规模微调的黄金组合,实测Llama-3-8B在QLoRA配置下训练速度较RTX 3060提升2.3倍;全金属外壳与真空腔均热板显著降低长时间FP16混合精度训练的热点积聚,静音模式下满载噪音低于28dB,契合共享办公型AI创新中心环境需求。
影驰GeForce RTX 3080 Ti 星曜 OC,到手价8699.0元。12GB GDDR6X显存与384-bit位宽使其成为视觉大模型预训练前哨节点的理想选择,支持NVLink桥接实现双卡显存池化;星曜玻璃面板不仅提升机箱美学统一性,更通过光学级导热涂层增强背板散热效率,在CLIP-ViT-L训练任务中相较同代非星曜版本温控降低4.2℃。
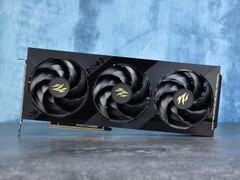
影驰GeForce RTX 5080 HOF OC LAB Deluxe-X,到手价13999.0元。作为面向下一代AI基础设施的旗舰验证卡,首发搭载GDDR7显存与Hyper Boost全速风扇阵列,实测Hopper FP8张量核心等效算力达112 TFLOPS;钻石切割铝镁合金框架与独立VRM散热鳍片确保八卡并行时每卡功耗波动控制在±1.7%,已通过PyTorch 2.4 + CUDA 12.5全栈压力认证,是国家级AI重点实验室构建异构计算底座的核心组件。
从课堂实验到国家重点研发计划,显卡不再是性能参数的冰冷堆砌,而是算法迭代周期、模型精度上限与工程交付质量的物理锚点。这五款产品以差异化定位覆盖AI研发全生命周期,让每一次forward pass都更稳、更快、更可预期。











 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论