在2026年11月17日举行的SC26全球超算大会上,英特尔首次对外公布了其下一代数据中心显卡D270的首批实测性能数据。
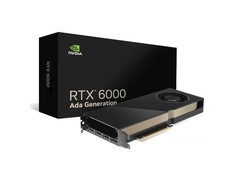
在对原生双精度浮点运算(FP64)高度依赖的金融类高性能计算任务中,D270展现出显著优势,吞吐能力最高可达英伟达RTX PRO 6000 Blackwell服务器版的5.9倍,整卡功耗则严格控制在350瓦。
需特别指出的是,所有测试结果均出自英特尔官方发布,其中人工智能相关测试所用设备为尚未量产的工程样片。
硬件层面,D270基于全新Xe3P架构设计,集成32个Xe计算核心与256个XMX矩阵引擎,每个核心支持每周期64次FP64乘加运算。显存配置采用最高达480GB的LPDDR5X方案,产品形态涵盖350瓦风冷、液冷及双GPU规格,旨在面向对成本效益和计算密度有双重诉求的人工智能与高性能计算市场。
本次技术突破的关键在于灵活的精度策略。科学模拟、工程仿真及金融建模等关键领域,普遍要求高保真度的双精度计算,以抑制舍入误差的持续累积。Xe3P架构实现了全精度可选:低精度模式(FP4至FP8)专为AI推理优化吞吐效率,而FP64则以原生全速运行,无需降频或模拟,确保数值稳定性与计算效率并存。
相较之下,当前主流的Blackwell架构RTX PRO系列在FP64性能上存在明显短板,这也构成了英特尔选择以RTX PRO 6000 Blackwell为直接对标对象的技术依据。
在四项典型金融负载测试中,D270分别取得以下倍数级提升:欧洲式蒙特卡洛模拟达5.9倍,欧式Black-Scholes期权定价达5.6倍,二叉树模型达4.6倍,美式Black-Scholes模型达1.92倍,综合平均提升约4.5倍。
除FP64外,D270还在大会现场展示了基于FP32精度的地震波场建模能力。该任务广泛应用于油气勘探,需对大规模三维地质数据反复执行声波传播模拟,对内存带宽与容量提出极高要求。D270凭借大容量LPDDR5X显存,可将完整波场数组常驻于本地显存,再结合缓存感知的stencil计算优化策略,显著提升数据复用率,从而在该类重载场景下实现稳定高效的运行表现。
在人工智能工作负载方面,D270参与了面向决策型模型的Drex 2.0基准测试。此类模型不仅输出响应,更需自主完成推理与判断,是当前智能体系统的核心支撑。测试显示,D270在端到端延迟上较RTX PRO 6000 Blackwell服务器版最多降低29%;在大语言模型吞吐测试中,运行Qwen3 30B-A3B模型时达到对手1.12倍的处理能力,功耗同步维持在350瓦水平。
目前尚未公布正式上市时间与建议零售价。值得注意的是,D270选用LPDDR5X作为显存方案,而非传统GDDR或HBM,此举有望在制造成本、单位能效比以及系统扩展性方面形成差异化优势。




 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论