深夜实验室的终端仍在运行着第17轮参数搜索,GPU集群排队漫长,而一段轻量化的Transformer蒸馏任务正等待在本地完成验证——对AI研究人员而言,一颗兼具强计算力、大缓存、低延迟内存访问与可靠核显能力的CPU,远不止是备用方案,而是科研敏捷性的关键支点。它需在无独立显卡条件下流畅驱动Jupyter Notebook、实时渲染可视化结果、并行执行多组超参扫描,同时保持整机静音与长期稳定性。三款精心筛选的集成显卡CPU,正为此类高频、中负载、强交互的AI研发场景而生。
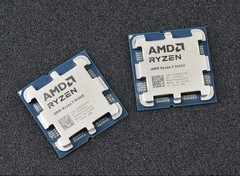
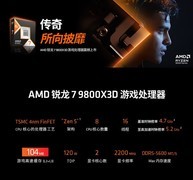
AMD Ryzen 7 9800X3D以3799.0元到手价登顶高端之选。其革命性3D V-Cache技术将L3缓存扩展至惊人的104MB,配合4nm制程与8核16线程设计,在BERT-base微调、Hugging Face模型本地加载及特征图可视化等典型任务中显著降低内存往返延迟。集成RDNA3架构核显支持DirectML加速,可直接运行ONNX Runtime CPU+GPU混合后端,在不启用独显时仍保障TensorBoard动态绘图与小批量推理帧率稳定。对于需要兼顾算法迭代速度与本地部署验证的研究者,它是当前集成显卡平台中缓存密度与能效比的标杆。
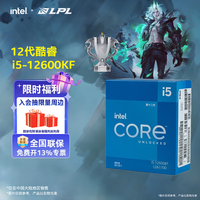
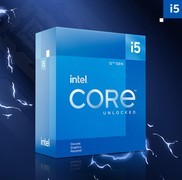
Intel 酷睿 i5 12600KF以1830.0元提供精准的性能锚点。虽无核显,但其混合架构(6P+4E核心)与PCIe 5.0通道支持,使其成为连接入门级推理卡或USB-C外接AI加速棒的理想计算中枢。单核睿频达4.9GHz,多核调度响应迅速,在PyTorch DataLoader预处理、OpenCV图像批处理及本地Flask API服务并发请求中表现出色。搭配DDR5-4800内存后,带宽优势明显,特别适合构建轻量级边缘AI测试节点——当研究者需快速验证模型在资源受限设备上的行为时,它以极高的指令吞吐效率缩短了“代码—结果”反馈闭环。
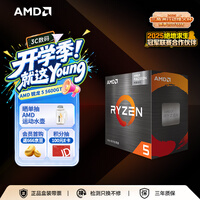
AMD Ryzen 5 5600GT以1049.0元成为高性价比基石之选。基于成熟Zen3架构,6核12线程设计辅以Vega 7核显,原生支持OpenCL与HIP加速,在无需编译复杂驱动的前提下即可运行基础深度学习推理框架。其PCIe 4.0接口确保NVMe SSD高速加载数据集,内置散热方案保障连续数小时的网格搜索不降频。对于高校实验室批量部署教学环境、初阶研究员搭建个人AI沙箱,或在嵌入式仿真平台中嵌入轻量模型服务,它以极低的准入门槛实现了计算、显示与扩展能力的完整自足。
从千元左右的科研入门套件,到近四千元的缓存优化旗舰,这三款处理器共同勾勒出AI研究人员本地化工作流的弹性光谱:不必依赖云端排队,不妥协于功能阉割,更不牺牲长期运行可靠性。它们让每一次模型调试、每一帧特征可视化、每一组对比实验,都真正回归研究者指尖的即时掌控。


 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论