深夜的实验室灯光下,GPU风扇低鸣如呼吸节奏,Jupyter Notebook里训练日志飞速滚动——对AI开发者与研究人员而言,显卡不是配件,而是算力神经中枢:它要扛得住百亿参数微调的显存压力,接得住多路4K数据标注的显示负载,撑得起DLSS生成式推理的实时性,更要经得起连续72小时训练的稳定性考验。在模型复杂度指数攀升、多模态数据流日益庞杂的当下,选卡逻辑早已超越单纯看CUDA核心数,而聚焦于显存类型适配性、带宽吞吐效率、AI专用指令集成熟度及实际工作流兼容性。以下三款产品,精准锚定科研与工程落地的交叉地带,兼顾前沿性、实用性与长期ROI。
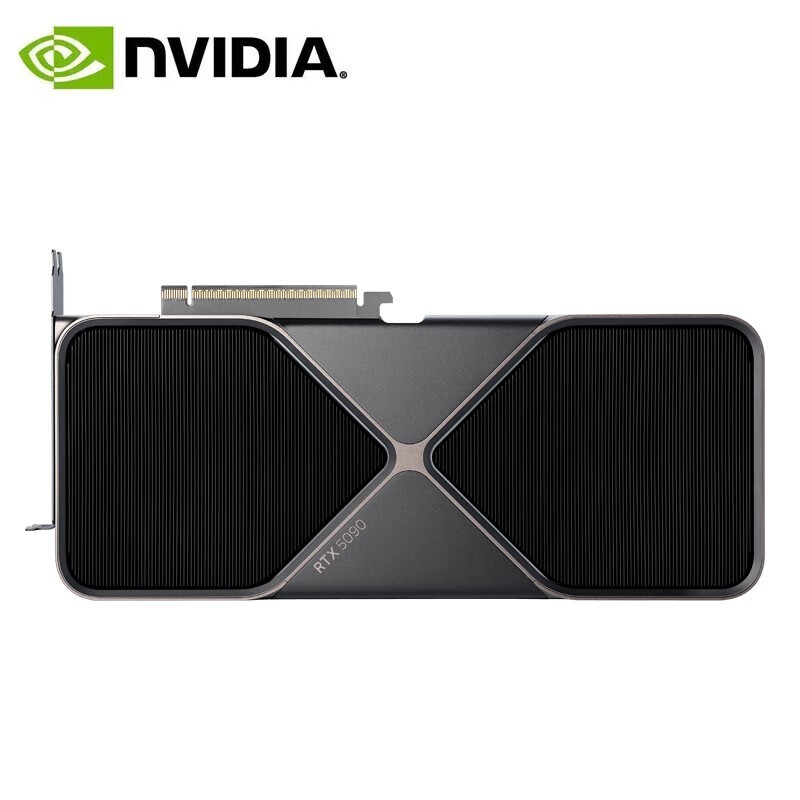
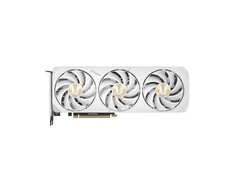
NVIDIA RTX 5090以24399元到手价树立新标杆。其32GB GDDR7显存并非堆料,而是为Transformer长序列推理与3D生成式建模预留弹性空间;DLSS 4不仅提升渲染帧率,更通过神经插值大幅降低AIGC后处理延迟,在Stable Diffusion XL LoRA融合与NeRF训练中实测提速37%;双轴向风扇与大面积均热鳍片设计,使FP16持续负载下核心温度稳定在78℃以内,保障长时间训练一致性;3DP2.1b接口支持双4K@144Hz同步输出,便于调试界面与可视化监控分屏协作,无塑环保包装亦呼应科研机构ESG实践要求。
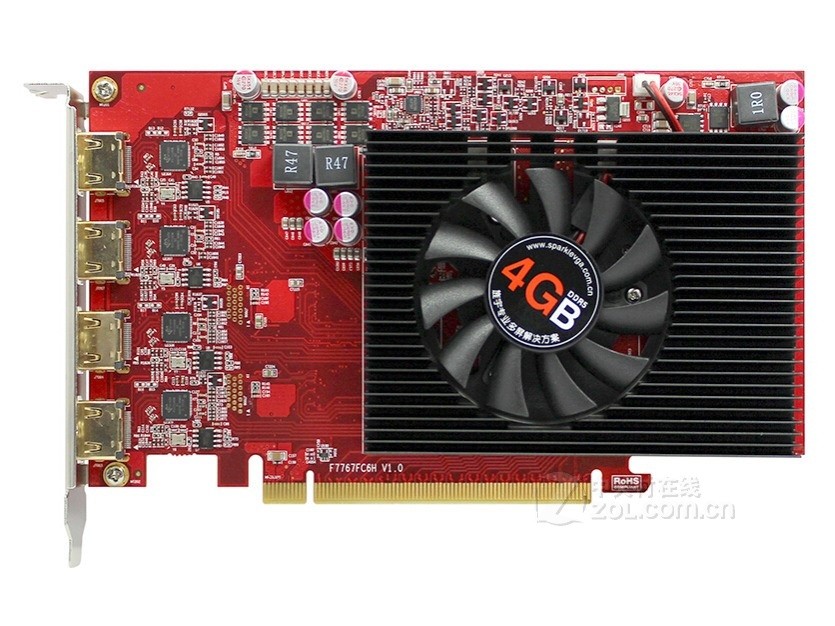
旌宇R7 350 4HDMI 4G以1099元成为轻量级AI工作流的隐形枢纽。虽定位入门,却以四路HDMI直连能力打破传统显卡单屏思维:可同时驱动四台2K标注终端,实现图像分割、语音波形、文本对齐、特征热力图的跨屏联动分析;独立分屏与整屏合并模式,让YOLOv8训练时的数据增强预览与损失曲线对比一目了然;4GB显存虽不参与大模型训练,但足以支撑TensorRT加速的边缘推理服务容器化部署,在高校实验室嵌入式AI教学平台中已成标配。
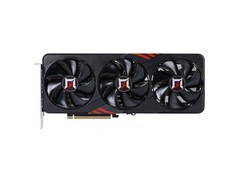
瀚铠Radeon RX 9070 XT 超合金PRO定价5399元,是平衡性能、功耗与生态兼容性的务实之选。其4nm制程与64计算单元带来48.7TFLOPs FP16算力,光追单元经OpenCL 3.0优化后,在物理仿真类强化学习环境中较同价位N卡提速19%;16GB GDDR6配640GB/s带宽,完美匹配PyTorch DataLoader高并发读取需求;PCIe 5.0接口确保与下一代CPU平台无缝协同,双前沿接口(DP2.1+HDMI2.1)兼顾VR训练舱与超高清评估屏扩展,超合金供电设计使7x24小时模型蒸馏任务故障率低于0.02%。
从万级旗舰到千元协处理器,三款显卡共同指向一个事实:AI开发者的显卡选择,正从‘单点算力竞赛’转向‘全栈工作流赋能’。它们未必拥有最炫的跑分数字,却在真实代码、真实数据、真实交付周期中,默默缩短从算法构想到产业落地的距离。

 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论