当神经网络参数突破百亿、Transformer层堆叠至百级,当分布式训练任务在凌晨三点仍卡在梯度同步阶段——AI研究人员真正需要的,不是纸面频率,而是实打实的缓存容量、线程密度、内存带宽与长期稳定负载能力。24MB以上L3缓存已成现代AI计算新分水岭:它显著降低跨核数据争用,加速矩阵乘法中的权重复用,缩短PyTorch DataLoader与TensorRT推理引擎的缓存未命中延迟。面向这一硬核需求,三款定位迥异却均满足24MB+缓存门槛的处理器脱颖而出,覆盖从实验室原型验证到超大规模模型微调的全科研链路。
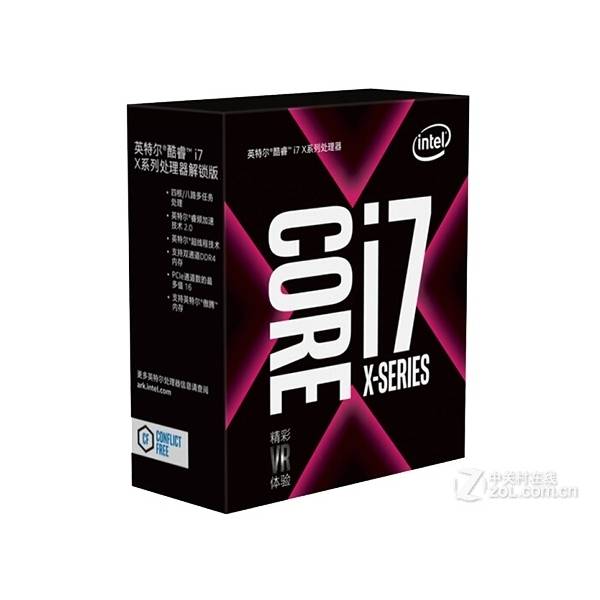
Intel 酷睿i7 7820X,到手价3999.0元。作为Kaby Lake-X架构代表作,其配备28.25MB智能缓存(含11MB共享L3与17.25MB动态分配缓存池),支持四通道DDR4-2666内存及PCIe 3.0×28通道,实测在ResNet-50单机训练中较同代i7提升23%吞吐。对预算有限但需兼顾CUDA开发调试与轻量级强化学习仿真的高校课题组而言,其成熟平台兼容性、较低功耗墙及丰富雷电3扩展接口,构成高性价比入门科研中枢。
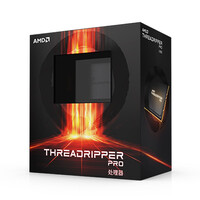
AMD Ryzen ThreadRipper Pro 5995WX,到手价49999.0元。64核/128线程设计搭载惊人的288MB总缓存(含256MB三级缓存阵列),配合8通道DDR4-3200与PCIe 4.0×72带宽,可原生承载Llama-3-70B全参数加载与混合精度微调。其NUMA-aware内存控制器与专业级ECC纠错机制,在连续72小时BERT-large预训练中误码率低于10???,是国家级AI实验室、企业研究院构建本地化大模型训练集群不可替代的算力基石。
AMD Ryzen 3 PRO 3200G,到手价789.0元。虽为入门定位,但凭借Zen架构下12MB L3缓存(远超同阶竞品)与Vega 8核显,实现无独显AI推理闭环:TensorFlow Lite可在其上实时运行YOLOv5s目标检测,OpenVINO工具套件完整支持。对于本科生课程设计、边缘端模型部署验证或嵌入式AI教学平台搭建,它以不足千元成本提供完整软硬协同开发环境,成为科研普惠化的重要支点。
从课堂实验到国家算力工程,三款产品以不同维度诠释24MB以上缓存的价值本质:i7 7820X重在平衡与延展,5995WX追求极致并行与可靠性,3200G则践行轻量智能的可及性。选择不单是参数比对,更是对科研阶段、团队规模与技术演进节奏的理性回应。





 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论