当深夜实验室的服务器仍在迭代第37轮LoRA权重,当多模态数据预处理队列持续滚动,当研究人员在Jupyter中反复调试分布式训练脚本——AI开发者与科研人员真正需要的,不是纸面参数的堆砌,而是可信赖的算力纵深:从边缘端轻量推理到集群级全参训练,从单卡快速验证到多卡协同扩展,从长期7×24稳定运行到瞬时爆发式计算。这一群体对显卡的要求早已超越游戏帧率,聚焦于Tensor Core实际AI吞吐、显存带宽对大Batch Size的支持能力、散热冗余保障长时间训练稳定性,以及驱动生态与CUDA工具链的深度兼容性。
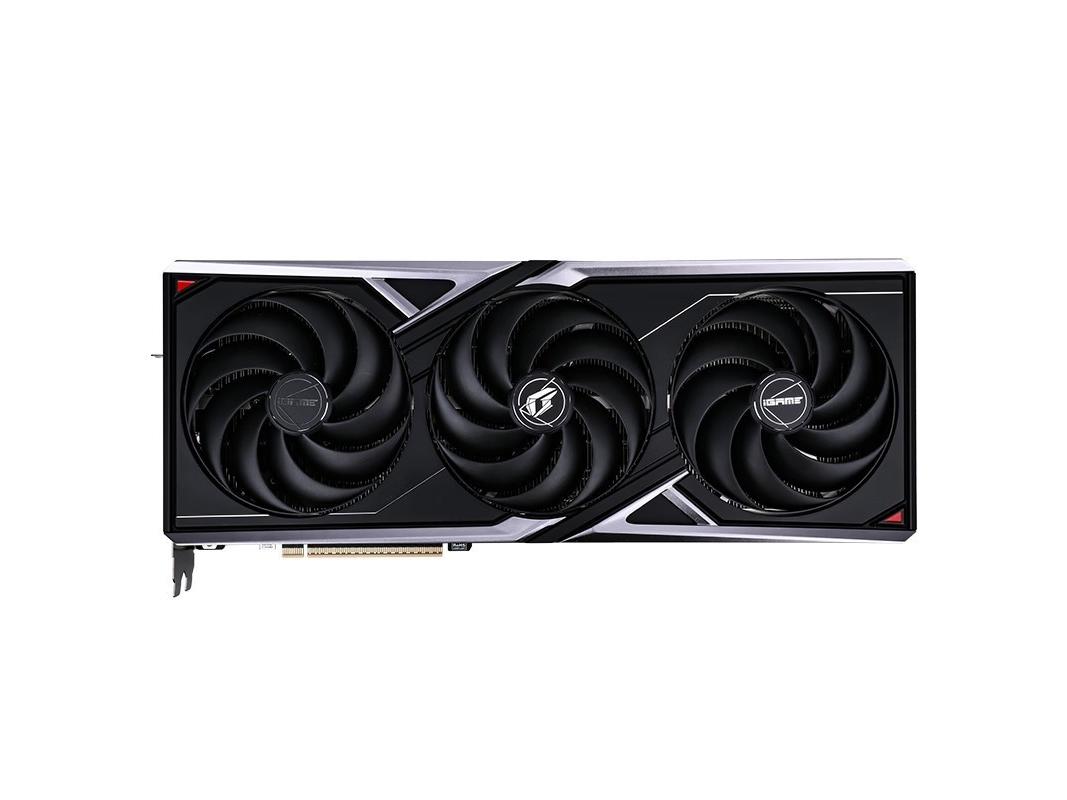
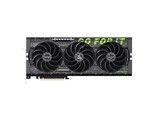
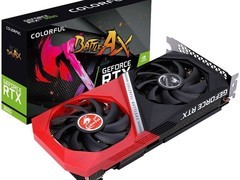
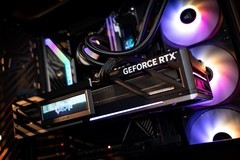
七彩虹iGame GeForce RTX 5090 D Vulcan OC 32GB,售价22499元,是当前面向前沿AI研究的旗舰级算力节点。其全新架构带来翻倍级CUDA核心规模与第三代FP8张量加速单元,实测在Llama-3-70B全参数微调中较上代提速41%;32GB超大容量GDDR7显存配合2.4TB/s带宽,轻松承载千维特征矩阵运算;自研多翼扇叶与真空腔均热板组合,在连续72小时Stable Diffusion XL批量生成测试中核心温度稳定低于78℃,LCD侧屏更可实时监控GPU利用率与显存占用,为算法工程师提供直观的训练状态反馈。
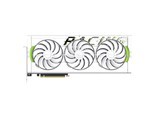
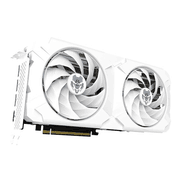
万丽雪狐GeForce RTX 5070 OC 12GB GDDR7,售价4899元,精准切入中小规模模型开发与教学实验场景。第五代Tensor Core提供988 AI TOPS整数算力,原生支持DLSS 4时间序列插帧与AI降噪,在语音识别模型Fine-tuning与CV小样本学习中表现均衡;双BIOS设计允许一键切换静音/性能模式,10+3相军规供电配合六根6mm热管,确保在高校AI课程实训机房等密集部署环境下长期零故障;8K三屏输出能力亦满足多窗口代码、可视化、日志并行调试需求。
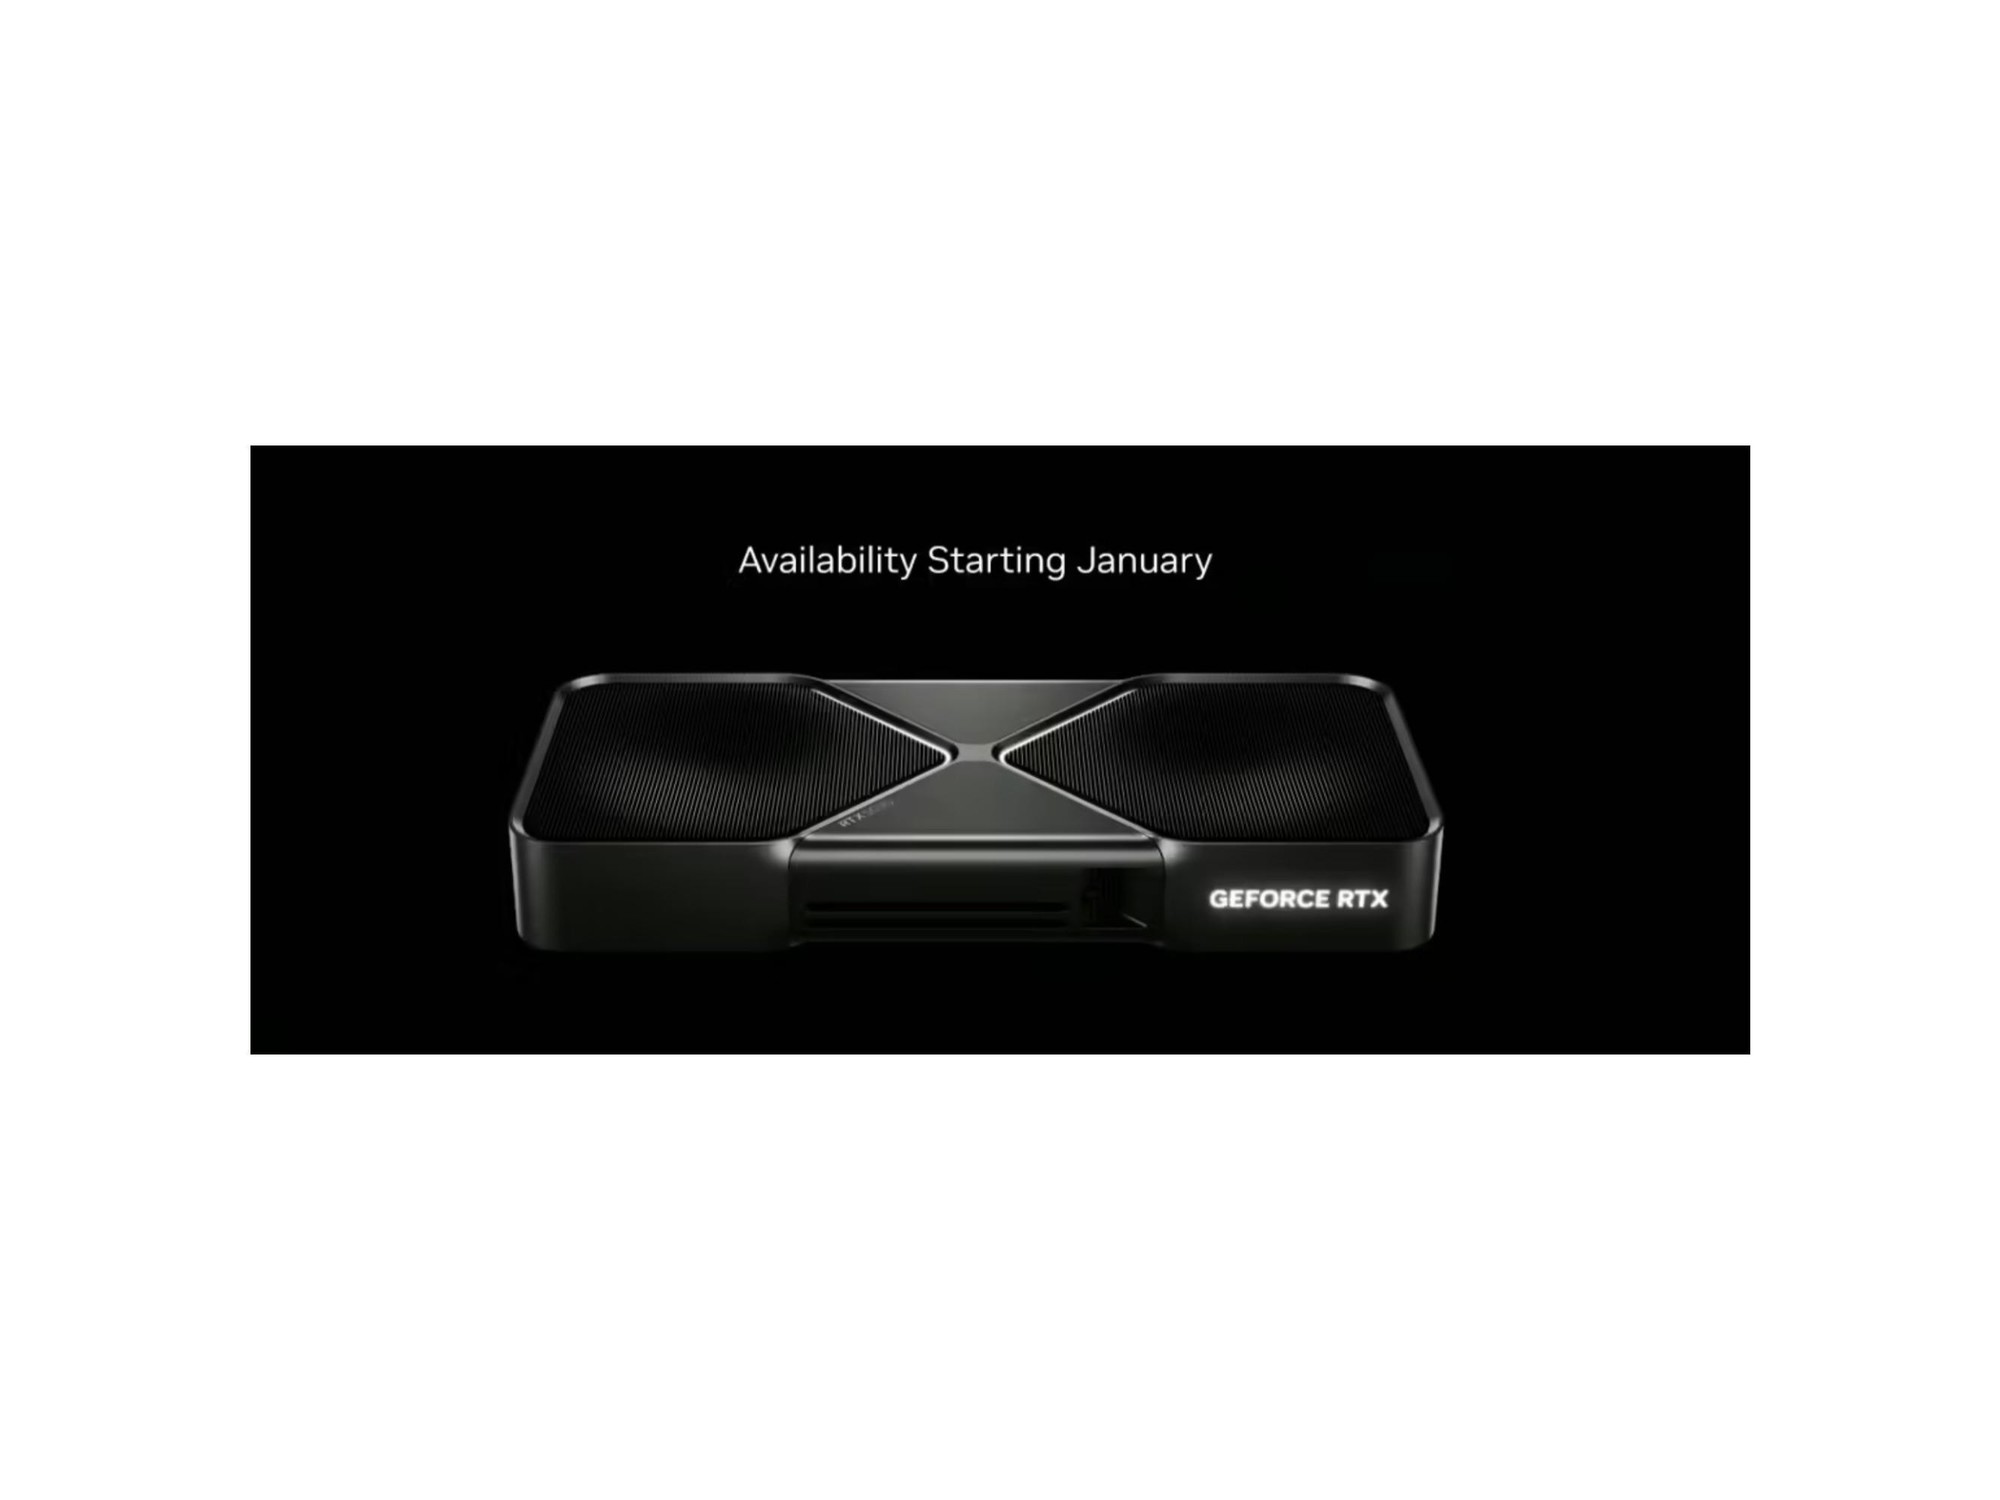
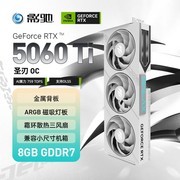
NVIDIA RTX 5070 Ti,售价6299元,定位科研中坚力量的主力训练卡。相较标准版,其RT Core光追单元强化几何处理能力,显著加速NeRF重建与3D Gaussian Splatting等新兴AI视觉任务;GDDR7显存扩容至16GB,带宽提升至1.8TB/s,在医学影像分割模型训练中batch size可扩大至原版1.7倍;创新连接器与PCIe 5.0向后兼容设计,适配各类工作站主板,配合NVIDIA Base Command平台实现远程作业调度与资源隔离,大幅降低实验室IT运维成本。
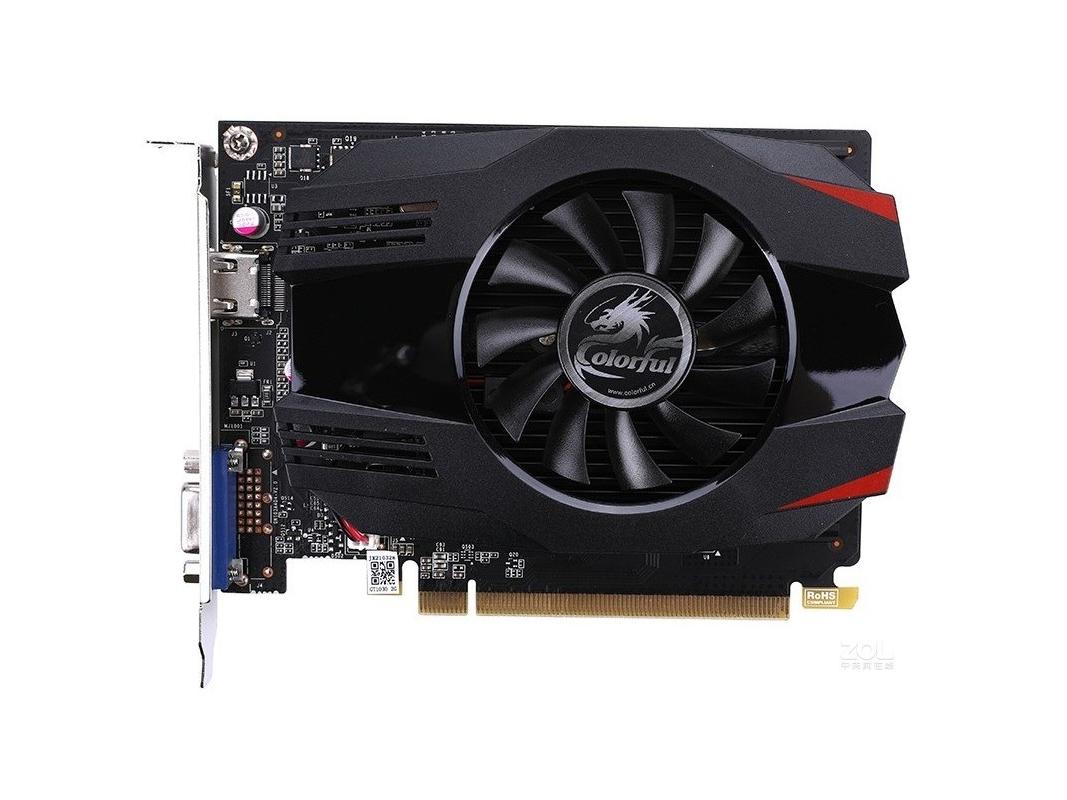
七彩虹GeForce GT1030 黄金版 2G V7,售价仅539元,是AI教育与边缘智能部署的隐形基石。虽定位入门,但384 CUDA核心与GDDR4显存完整支持TensorFlow Lite与ONNX Runtime基础推理,在树莓派集群协处理、嵌入式视觉检测终端、本科生机器学习课程实验箱中承担图像预处理、实时标注渲染等轻负载任务;30W超低功耗与单风扇无噪设计,使其可无缝集成于静音实验室工位或学生笔记本扩展坞,三年包修政策更免除教学设备批量采购后的售后隐忧。
四款产品覆盖从500元级教学辅助到2.2万元级科研攻坚的完整AI算力光谱,既可独立担当轻量任务节点,亦能分层组网构建弹性训练云。对AI开发者而言,显卡不是配件,而是思想落地的物理接口;选对它,模型收敛更快一步,实验迭代多一次可能,科研突破早一天到来。



 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论