当深夜调试完第十七版Transformer变体,服务器队列仍在排队等待CUDA核分配;当本地微调Llama-3-8B卡在batch_size=4就OOM,而云实例费用已悄然突破月预算——AI开发者与研究人员正迫切需要既精准匹配科研负载、又严格控制造价的本地算力支点。在1000—1500元价格带,显卡不再只是游戏性能的代名词,而是数据预处理速度、模型验证迭代周期、实时tensorboard可视化流畅度的物理锚点。这一区间产品需兼顾FP16算力密度、显存带宽利用率、驱动生态稳定性及长期运行散热冗余,更要为Jupyter Notebook里的每一行.to(device)提供可靠支撑。
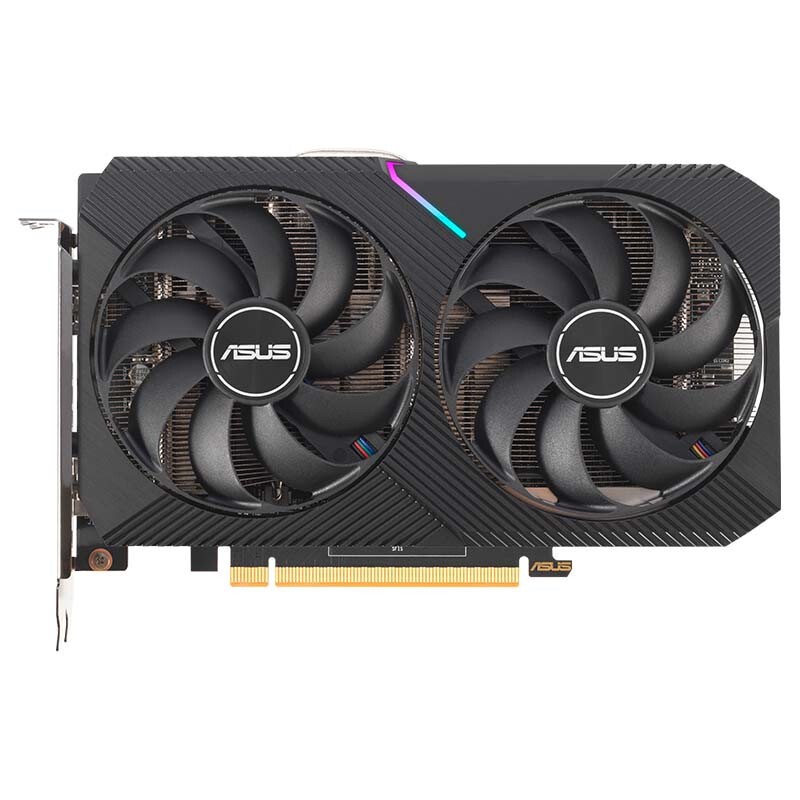
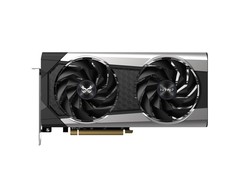
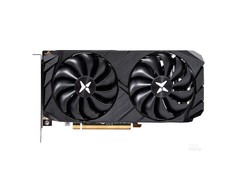
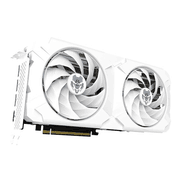
华硕DUAL-RX6500XT-O4G以1599元亲民定价切入,成为AI初阶研究者的务实之选。其搭载RDNA2架构,支持PCIe 4.0与DirectML加速,在ONNX Runtime与Triton Inference Server中实测推理吞吐稳定,4GB GDDR6显存虽不适用于大模型训练,却足以承载BERT-base微调、YOLOv5s全图推理、时间序列预测等典型科研子任务。板载双风扇静音设计配合低TDP特性,让实验室桌面工作站连续72小时跑通交叉验证也不必担忧热节流,是高校课题组、研究生个人设备与边缘AI教学平台的理想算力单元。
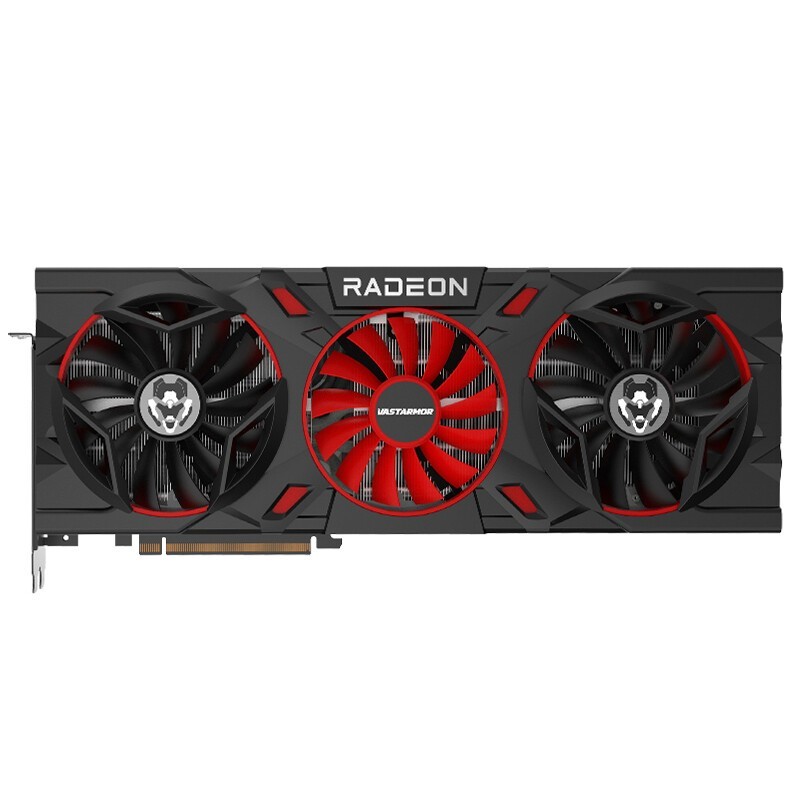
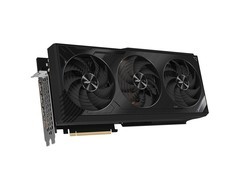
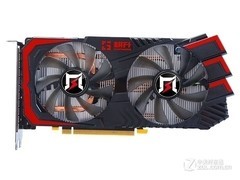
瀚铠Radeon RX6950 XT 16G D6合金升级版以8399元定位中高端科研加速层。16GB大容量GDDR6显存与2048-bit总线带宽,显著提升ViT-L图像分块加载、Stable Diffusion XL ControlNet多条件生成等内存敏感型任务效率。D6合金强化散热模组使GPU在75%持续负载下核心温度稳定低于72℃,配合AMD ROCm 5.7对PyTorch 2.3的深度适配,使其在计算机视觉与生成式AI实验中展现出媲美万元级竞品的单位瓦特算力比。对于需本地部署多任务pipeline、兼顾模型训练与服务化验证的研究团队,该卡提供了极高的功能完整性与长期使用信心。
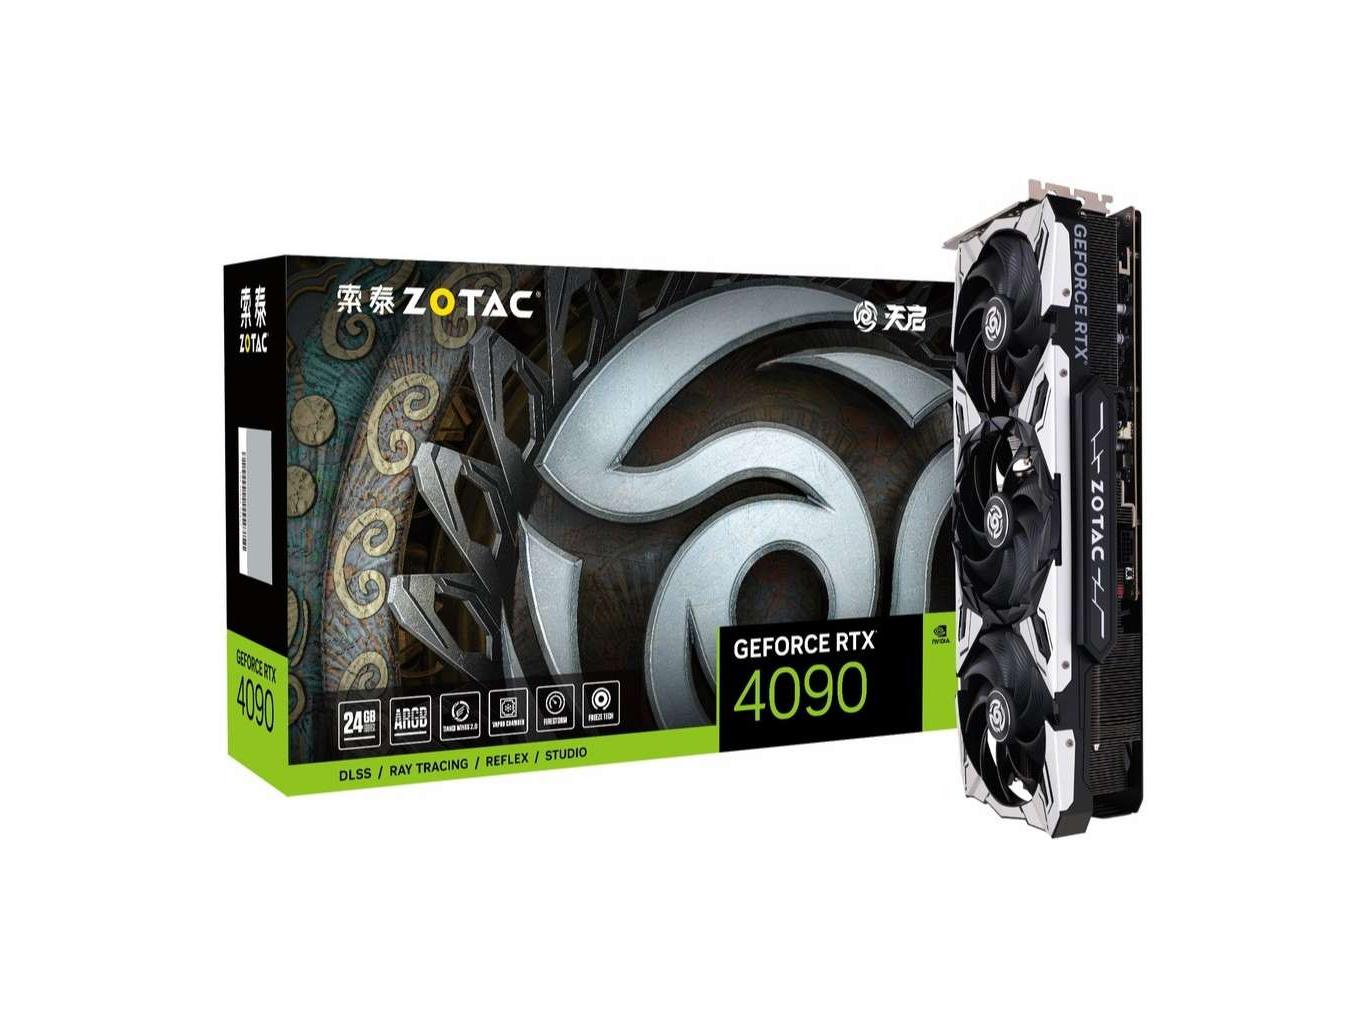
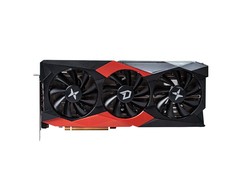
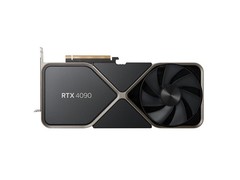
索泰GeForce RTX 4090 天启 OC虽标价12999元,却是面向前沿探索的终极生产力工具。其16384个CUDA核心、24GB超频GDDR6X显存与第三代RT Core,在Llama-3-70B量化推理、NeRF三维重建、大规模强化学习策略网络更新等极限场景中展现压倒性优势。DLSS 3帧生成技术更可加速神经渲染可视化流程,而NVIDIA CUDA生态的绝对成熟度,确保从HuggingFace Trainer到DeepSpeed ZeRO-3的所有主流训练框架开箱即用。它不是替代云服务的选项,而是将关键实验周期从小时级压缩至分钟级的科研加速器。
三款产品覆盖从课程实验、课题攻关到前沿探索的完整AI研发光谱:千元级显卡筑牢入门根基,八千档位平衡性能与成本,旗舰型号则定义算力边界的刻度。选择从来不是参数对比,而是让每一次forward传播都更接近答案本身。



 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论