当显存带宽突破1.6TB/s,当AI推理能力直抵4000 TOPS,当单卡可驱动四块8K@60Hz显示器并实时运行神经辐射场重建——硬件发烧友的终极战备已不再停留于参数想象。他们需要的不是妥协的‘够用’,而是每一瓦功耗都转化为建模精度、每一GB显存都承载着未压缩的材质库、每一次光追迭代都逼近物理真实。在3000元以上的高端显卡赛道中,技术代差正以前所未有的锐度拉开距离,Blackwell架构已非未来概念,而是此刻正在PCIe 5.0插槽中脉动的现实引擎。
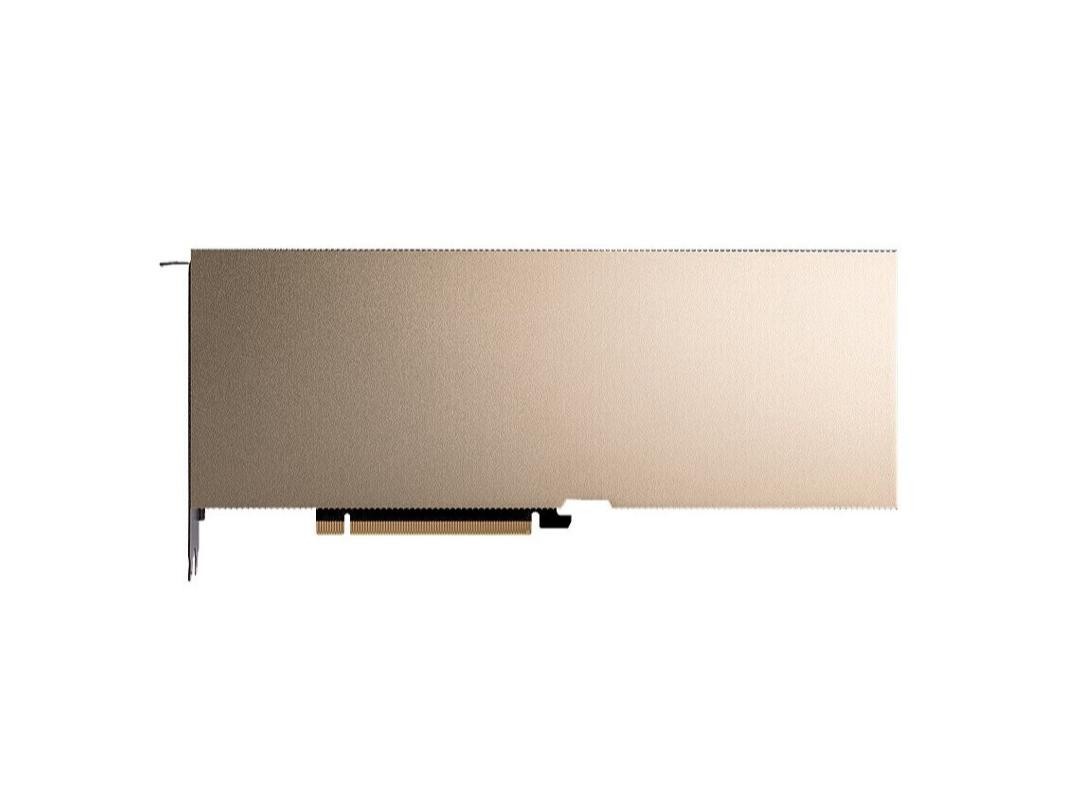
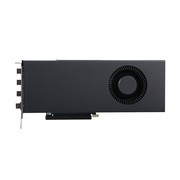
NVIDIA RTX PRO 6000 Blackwell 服务器版以88299元定价,面向专业图形计算与AI科研场景。其96GB GDDR7 ECC显存配合512bit位宽与1.6TB/s极致带宽,确保大型三维仿真、分子动力学模拟或百亿参数模型微调过程中零显存溢出;24064个CUDA核心与752个Tensor核心构成的算力矩阵,在FP32达125 TFLOPs的同时,将AI训练吞吐稳定在4000 TOPS,远超上代A100。对依赖Blender Cycles、ANSYS Discovery或PyTorch分布式训练的工程师而言,这不是一张显卡,而是整套本地化HPC节点的基石。
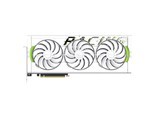
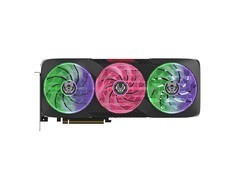
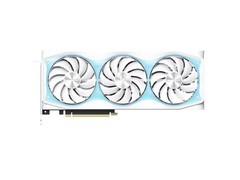
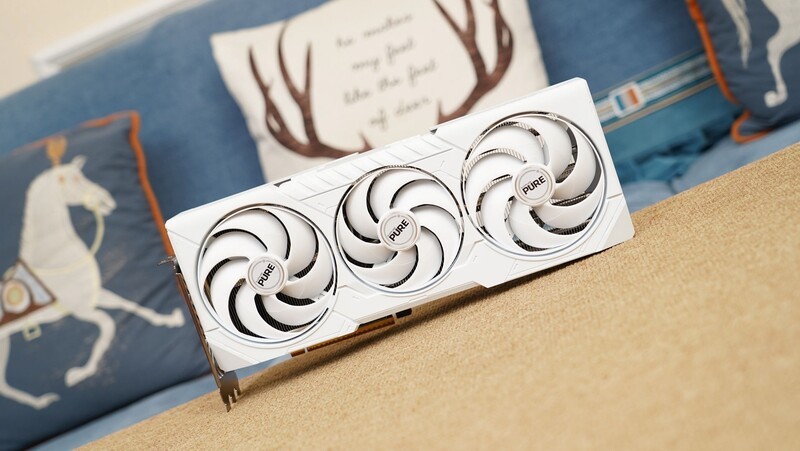
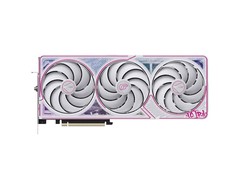
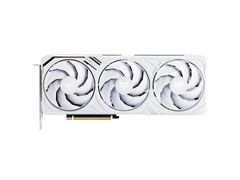
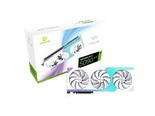
万丽雪狐GeForce RTX 5070 OC以4899元切入主流高性能市场,成为发烧友装机最具战术价值的选择。GB205核心赋予其6144 CUDA单元与988 TOPS AI算力,12GB GDDR7在28Gbps速率下实现672GB/s带宽,足以流畅驾驭《赛博朋克2077》路径追踪全开+DLSS 4帧生成;三风扇六热管直触散热与双BIOS设计,让满载温度控制在67℃以内,兼顾静音剪辑与暴力超频双重需求;纯白幻彩ARGB外观与Win11 Dynamic Lighting生态深度协同,满足硬件美学控对桌面统一性的苛求。
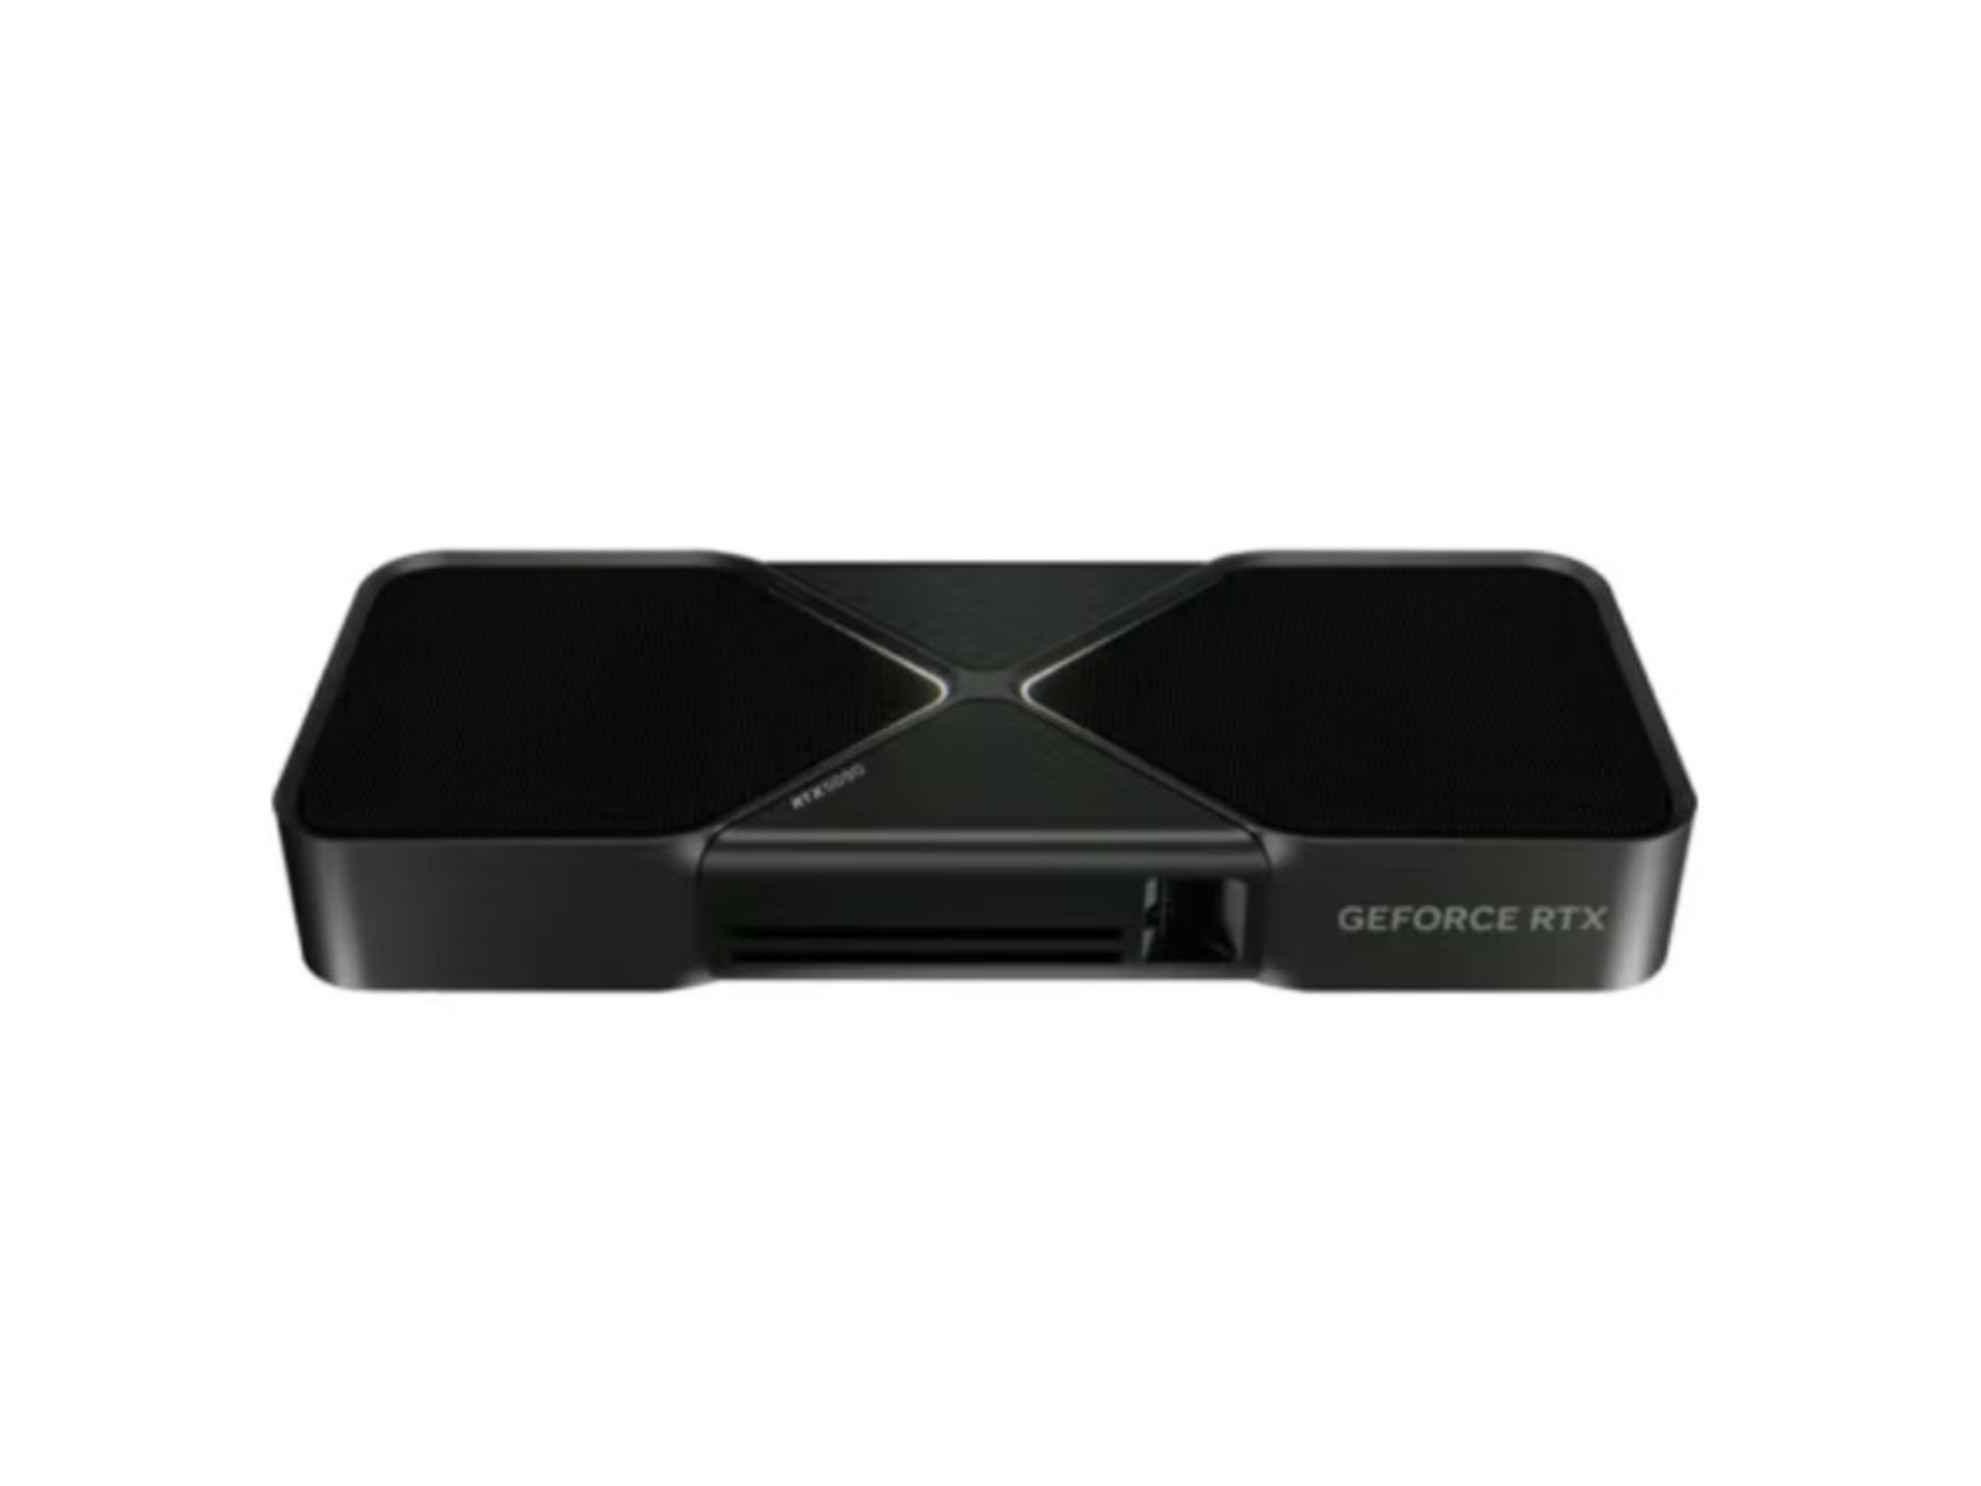
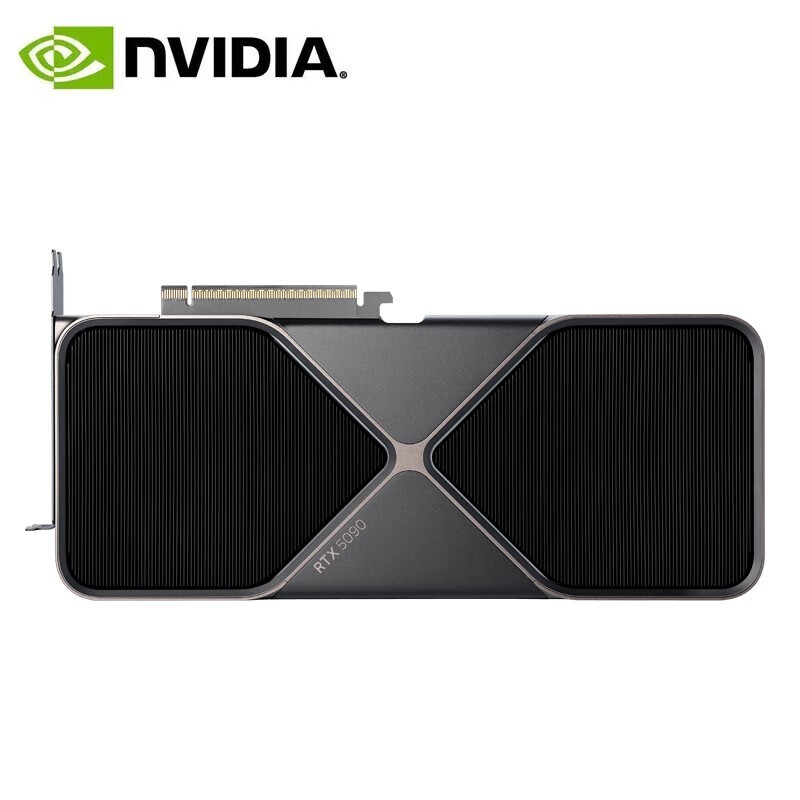
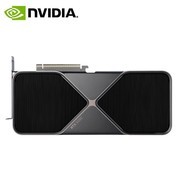
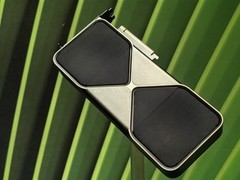
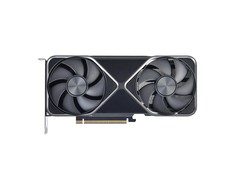
NVIDIA RTX 5090 FE公版以33999元定义消费级旗舰新标尺。21760 CUDA核心与32GB GDDR7显存构成无瓶颈4K/8K游戏与实时渲染平台,575W图形功率经液态金属导热与双轴空气流优化,实现在137×304×40mm紧凑双槽尺寸内持续释放峰值性能;第五代RT Core与第六代Tensor Core协同,使光线追踪反射精度提升40%,DLSS 4帧时序预测误差降低至毫秒级,是追求零延迟交互式VR开发与电影级虚拟制片的不二之选。
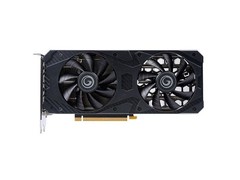
而同源架构的NVIDIA RTX 5090非公版以24399元提供更优价格弹性。虽为FE设计语言,但通过双风扇+双轴风道强化气流穿透力,芯片端仍沿用高导热液态金属介质;在保持与FE版完全一致的21760 CUDA核心、32GB GDDR7及PCIe 5.0支持前提下,以更亲民门槛让硬核玩家首次触达Blackwell全功能集,尤其适配需长期高负载运行的渲染农场副节点或家庭级AI实验平台。
从实验室级PRO 6000到个性定制的雪狐5070,从公版严苛工艺的5090 FE到高性价比落地的5090非公版——这一梯队并非线性替代关系,而是按算力密度、扩展性、生态兼容性与使用场景精准分层。硬件发烧友的装备进化,从来不是盲目堆叠参数,而是在每一分预算里,锚定自己最不可妥协的技术支点。



 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论