深夜调试Transformer架构时显存溢出,批量预处理千张医学影像卡在数据加载环节,多实验并行跑网格搜索却因CPU瓶颈被迫降配——这些不是偶然故障,而是AI研究人员日常面临的算力真实困境。他们不需要泛用型性能,而需要可预测、低延迟、高吞吐、强扩展性的计算中枢:既要扛住分布式训练的数据调度压力,又要兼容各类框架底层优化,还要为未来两年的模型规模预留余量。在此场景下,CPU已不再是“配角”,而是决定研究效率与迭代速度的关键支点。
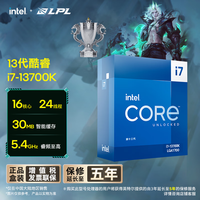
Intel 酷睿 i7 13700K 到手价3900.0元。其性能核+能效核混合架构在保持单线程高频响应的同时,以16核24线程保障数据预处理、特征工程与轻量训练任务并行不卡顿;PCIe 5.0通道直连高速NVMe与GPU,大幅缩短I/O等待时间;大容量智能缓存加速矩阵运算中间结果复用,核显亦可承担部分预处理渲染任务,是中小型实验室构建高性价比AI开发节点的理想选择。
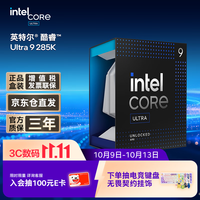
Intel 酷睿 Ultra 9 285K 到手价4799.0元。依托先进制程与全新AI引擎,该处理器在INT8与BF16指令集支持上实现硬件级加速,显著提升ONNX Runtime推理吞吐;超高主频配合24核32线程设计,在模型超参搜索、强化学习环境模拟等CPU密集型任务中展现稳定低延迟表现;新一代网络协议栈更利于跨节点通信优化,适合需频繁同步梯度的联邦学习本地端部署。
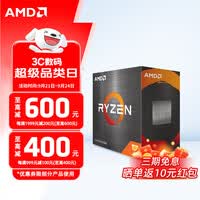
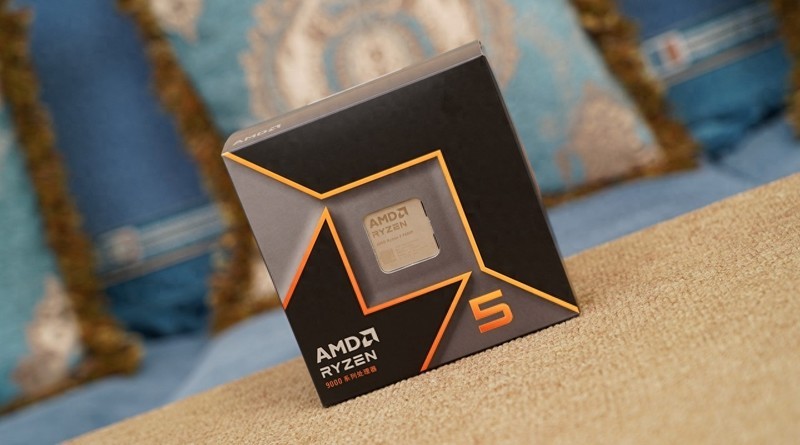
AMD Ryzen 7 5700X 到手价1999.0元。作为成熟可靠的7纳米主力型号,其8核16线程结构在单位功耗下提供扎实多任务能力,对TensorBoard日志解析、Jupyter Notebook多内核切换、小规模BERT微调等典型科研负载表现出色;平台兼容性强,可无缝接入现有Ubuntu/CentOS科研镜像环境,是高校课题组与初创AI团队控制预算又不失稳定性的务实之选。
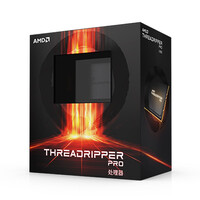
AMD Ryzen ThreadRipper Pro 5995WX 到手价49999.0元。64核128线程架构专为超大规模科学计算而生:8通道DDR4内存带宽满足百亿参数模型权重快速载入;128条PCIe 4.0通道支持四卡A100拓扑直连,消除总线争抢;Zen 3微架构在HPC Benchmark中展现出色浮点吞吐与缓存一致性,是高校超算中心、国家级AI实验室开展大语言模型基座训练与多模态联合建模不可或缺的算力基座。
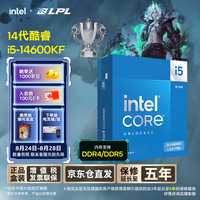
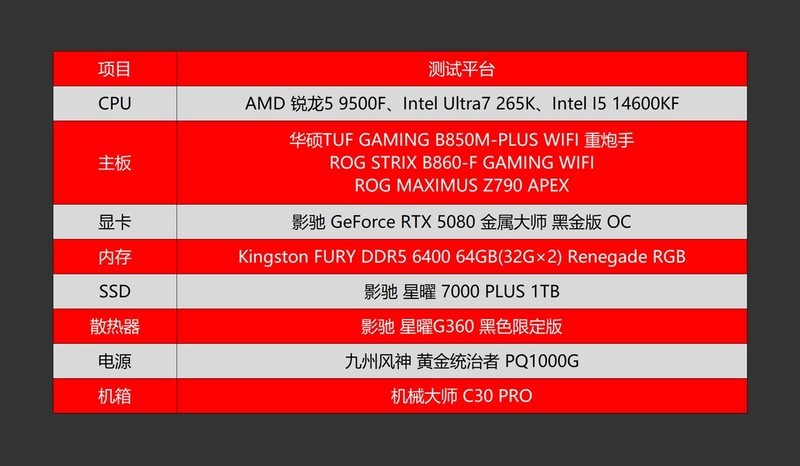
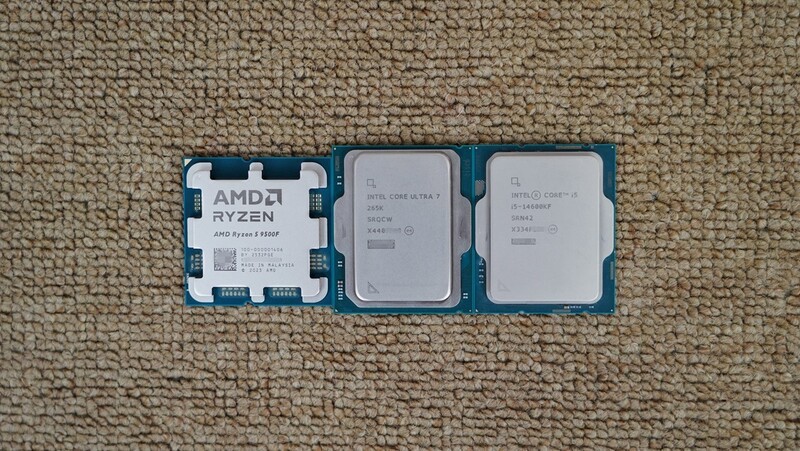
Intel 酷睿 i5 14600KF 到手价2499.0元。虽定位主流,但其14核20线程(6P+8E)与高频特性在兼顾能耗比前提下,显著超越前代i5在PyTorch DataLoader调度与CUDA Kernel预编译阶段的响应速度;KF版本无核显设计反而降低系统复杂度,更适合纯计算服务器部署;对于聚焦算法创新而非底层系统调优的研究者而言,它是高确定性、低维护成本的可靠搭档。
五款处理器覆盖从个人科研终端到国家级训练平台的完整光谱,它们共同指向一个事实:AI研究的加速度,始于一颗懂代码、知框架、耐长考的CPU。




 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论