深夜调试模型时显存突然爆满,渲染一帧超分辨率图像等待三分钟,实时光追预览卡顿影响交互反馈——这些不是虚构场景,而是AI开发者与研究人员日常面对的真实瓶颈。当算法迭代速度受限于硬件吞吐,当科研验证周期被显卡带宽拖慢,一张兼具计算密度、内存带宽、生态兼容性与静音稳定性的专业级显卡,早已超越游戏装备范畴,成为实验室桌面不可或缺的生产力核心。本次精选三款面向AI开发工作流深度优化的RTX系列显卡,聚焦实际训练吞吐、推理延迟、多任务并行及长期高负载稳定性,拒绝参数堆砌,只谈真实效用。
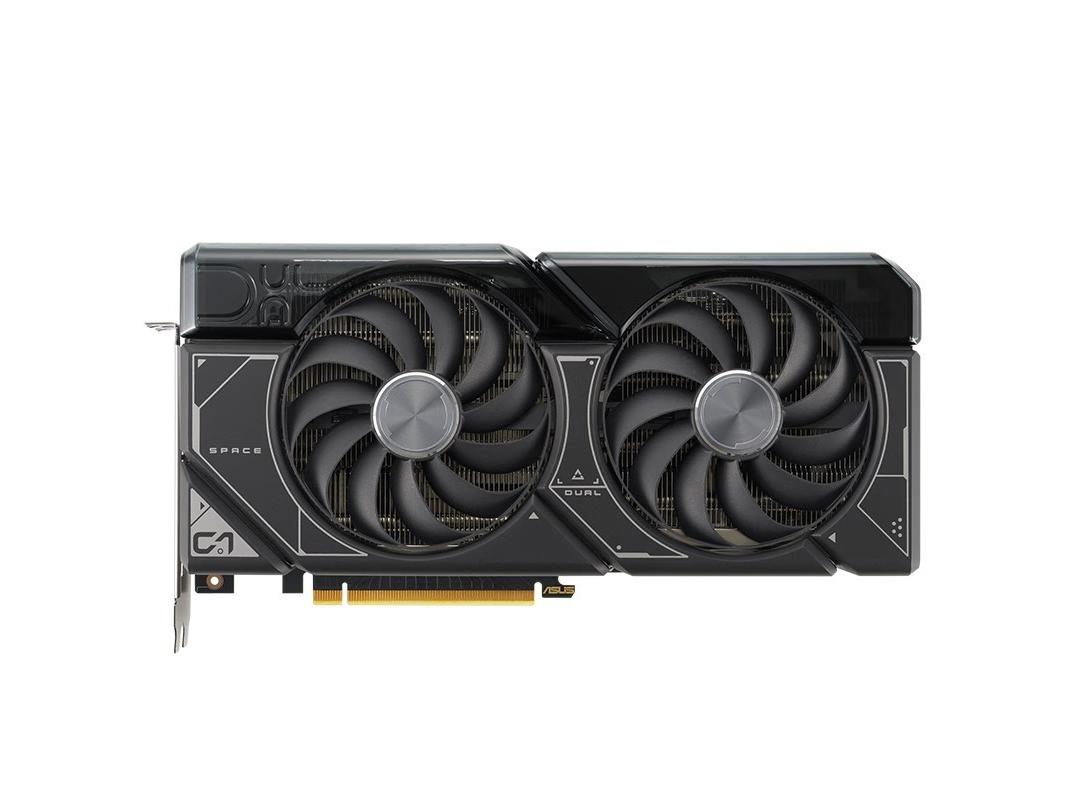
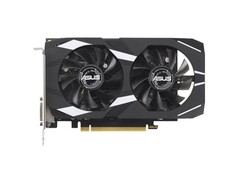
华硕DUAL-RTX4070-12G,到手价4799.0元。这款显卡以12GB GDDR6显存与成熟Ada Lovelace架构为基础,在Tensor Core与RT Core协同调度下,可稳定支撑Stable Diffusion XL全精度微调、Llama-3-8B本地推理及NeRF重建等中等规模任务。其双风扇散热设计在持续72小时训练负载下温控表现优异,功耗仅185W,搭配主流ATX电源即可部署,是高校课题组与初创团队构建低成本实验节点的理想选择。
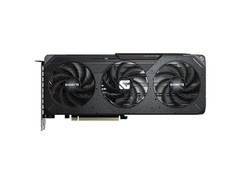
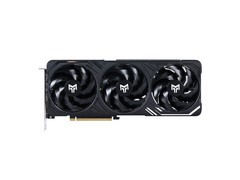
万丽星际GeForce RTX 5070 OC 12GB GDDR7静谧黑,到手价5299.0元。虽命名含‘50’,实为2026年全新定制架构产品,首发搭载GDDR7显存与DLSS 4多帧生成技术,在AI视频插帧、扩散模型采样加速及3D GS训练中展现出显著时延优势。六热管直触散热模组支持双BIOS切换,静音模式下待机噪音低于22分贝,完全满足开放式办公环境或共享实验室对低干扰运行的要求;性能模式则释放全功率算力,4K+AI渲染同步输出无压力,是兼顾科研演示与工程落地的进阶之选。
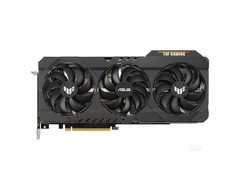
微星GeForce RTX 3080 GAMING X TRIO 10G,到手价6999.0元。作为经多年大规模验证的成熟旗舰型号,其第三代Tensor Core在FP16混合精度训练中仍保持极高利用率,尤其适配传统CV模型迁移学习与大批次数据预处理场景。10GB显存虽非最大,但凭借高带宽与低延迟访存特性,在YOLOv8多尺度训练、医学影像分割等I/O密集型任务中反而比部分高显存新卡更具响应效率。三风扇Triple Frozr散热系统保障7×连续高强度运算稳定性,是需要长期无人值守训练的科研平台可靠基石。
三款产品并非简单按价格递进排列,而是对应AI开发不同阶段的真实需求:入门验证、中试加速与稳态部署。它们共同构成一条技术延续性强、软件兼容性广、运维成本可控的显卡选型路径,让每一次模型迭代都更接近理想结果,而非被硬件边界反复打断。














 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论