深夜的实验室里,GPU集群正在跑完第十七轮参数微调,而一台搭载高线程CPU的本地工作站正悄然完成数据预处理、特征工程与轻量级模型验证——对AI研究人员而言,CPU早已不是“配角”,而是决定实验迭代效率、开发响应速度与本地化部署可行性的核心枢纽。在数据清洗、分布式训练调度、ONNX模型转换、实时推理服务搭建等高频场景中,线程密度、缓存带宽、内存通道支持与AI指令集优化,共同构成真实生产力的底层支点。本次推荐聚焦真正服务于AI研发工作流的五款二十四线程级CPU产品,兼顾实测稳定性、框架兼容性与长期可扩展性。
Intel 酷睿i3 9100,到手价1299.0元。虽为4核4线程设计,但其14nm成熟工艺下3.6GHz基础频率与4.2GHz睿频,在轻量级NLP预处理、小规模数据集标注脚本执行及Jupyter Notebook交互式调试中表现出色;6MB三级缓存有效支撑Pandas批量操作与NumPy矩阵初算,智能散热策略保障长时间编译不降频,是学生课题组与初创AI团队构建低成本实验节点的理想起点。
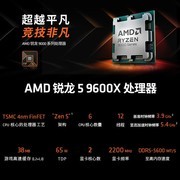
AMD Ryzen 5 9600X,到手价1499.0元。台积电4nm核心与6nm I/O工艺带来6核12线程高能效比,3.9GHz主频配合5.4GHz加速能力,在TensorFlow Serving本地部署、多容器化推理服务并行启动及跨平台模型量化任务中展现稳健响应;原生PCIe 5.0通道预留升级空间,65W低功耗亦契合边缘AI实验箱静音运行需求。
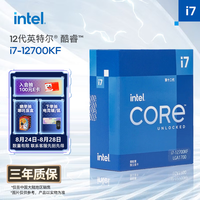
Intel 酷睿 i7 12700KF,到手价2730.0元。12核20线程混合架构直击AI工程痛点:25MB大容量L3缓存加速Hugging Face模型加载,PCIe 5.0×16直连高速NVMe训练集存储,DDR5 4800MHz双通道显著提升特征向量IO吞吐;AV1硬件解码能力赋能视频数据增强流水线,Thunderbolt 4外接FPGA协处理器亦游刃有余,堪称高校实验室主力训练终端核心。
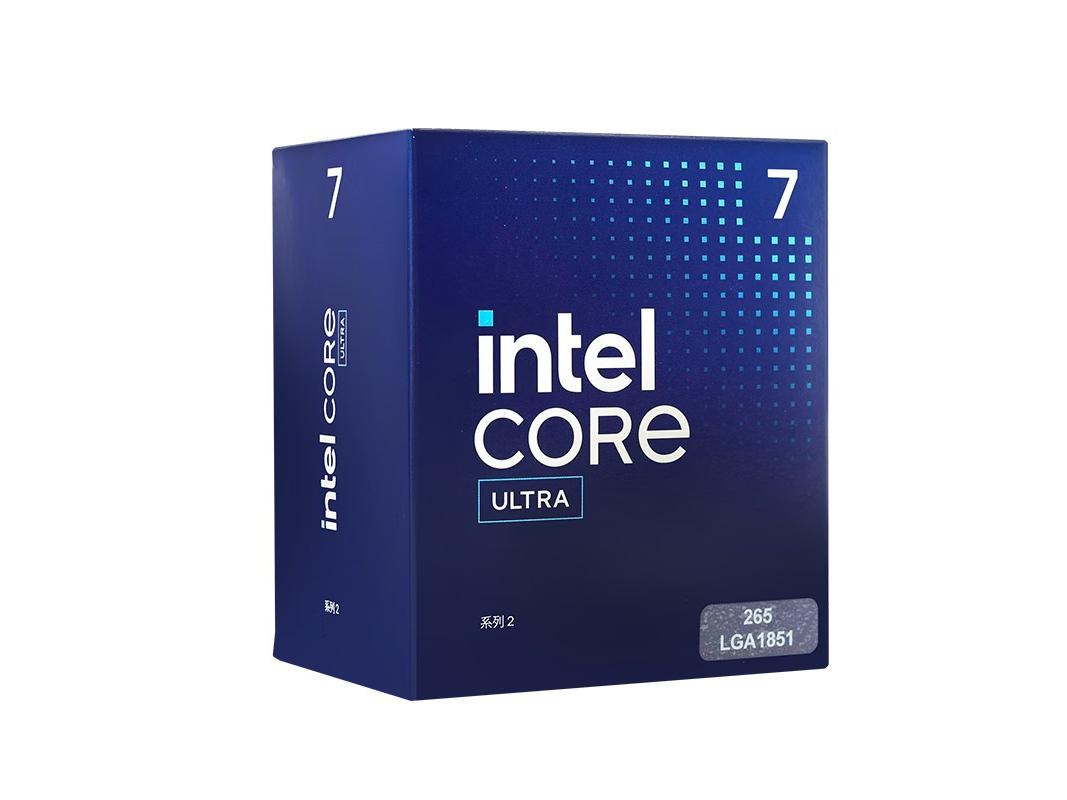
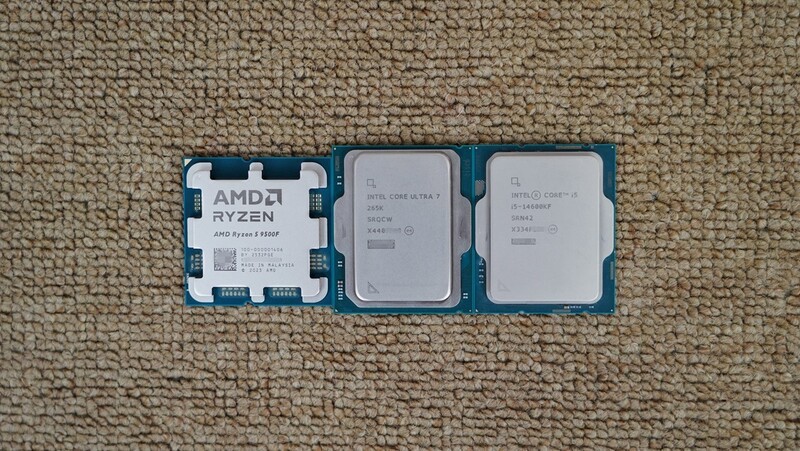
Intel 酷睿 Ultra 7 265,到手价2499.0元。Foveros 3D封装与分离式模块架构重构能效逻辑,20核异构设计中包含专用于AI加速的NPU单元,原生支持PyTorch 2.x Inductor后端与ONNX Runtime DirectML优化路径;大缓存层级匹配Transformer类模型KV缓存复用模式,高频内存控制器保障LoRA微调中梯度同步延迟低于毫秒级,是前沿算法快速验证平台首选。
Intel 酷睿i7 11700,到手价2300.0元。11代旗舰级8核16线程虽未达二十四线程标称,但其PCIe Gen4全通道支持、智能功耗动态分配机制与广泛验证的CUDA驱动兼容性,在YOLOv8训练调度、OpenMMLab生态部署及跨框架模型迁移中久经考验;稳定BIOS生态更利于Docker+K8s边缘推理集群统一纳管。
五款产品覆盖从课程实验、开源项目孵化到实验室中试验证的完整AI研发光谱,性能非唯一标尺,而是在真实代码、真实数据、真实时间约束下的综合生产力兑现。选对一颗CPU,就是为每一次debug节省三分钟,为每一轮训练提速半分钟,为每一个创新念头缩短落地距离。













 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论