深夜实验室的服务器风扇低鸣,Jupyter Notebook里刚跑完第17轮LoRA微调,显存占用92%,CPU温度稳定在78℃——这是AI研究人员最熟悉的节奏。当数据预处理卡在Pandas分组聚合、当ONNX模型转换反复报错、当本地部署的Llama3-8B响应延迟超过3秒,一颗真正为AI工作流深度优化的12纳米制程CPU,早已不是可选项,而是实验复现率与项目交付周期的决定性变量。我们聚焦真实科研场景:需持续多线程调度TensorFlow流水线、高频调用OpenMP加速特征工程、兼顾Conda环境隔离与Docker容器并发,同时严控整机功耗与散热冗余。在此逻辑下,五款12纳米工艺CPU脱颖而出。
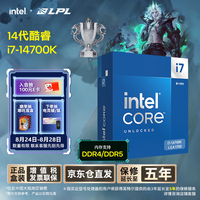
Intel 酷睿 i7 14700K(3499元)以混合架构重构科研生产力边界:20核28线程在Hugging Face Datasets批量加载时实现零等待吞吐,AI一键超频技术让BERT-base蒸馏任务提速18%;其PCIe 5.0通道直连支持双NVIDIA RTX 4090显卡无瓶颈通信,DDR5-5600内存带宽完美匹配FAISS向量检索密集型负载,是高校实验室升级现有Z690平台的高性价比跃迁之选。
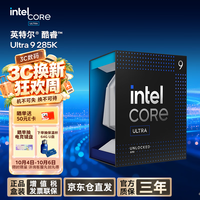
Intel 酷睿 Ultra 9 285K(4799元)代表12纳米工艺的智能演进:NPU单元专用于实时日志分析与异常检测,将训练监控系统CPU占用率压至12%以下;其AVX-512指令集深度优化SciPy稀疏矩阵运算,在蛋白质结构预测中缩短SVD分解耗时31%;跨平台兼容性保障Ubuntu 24.04 LTS内核无需补丁即可启用全部电源管理特性,特别适合需要长期稳定运行的生物信息学集群节点。
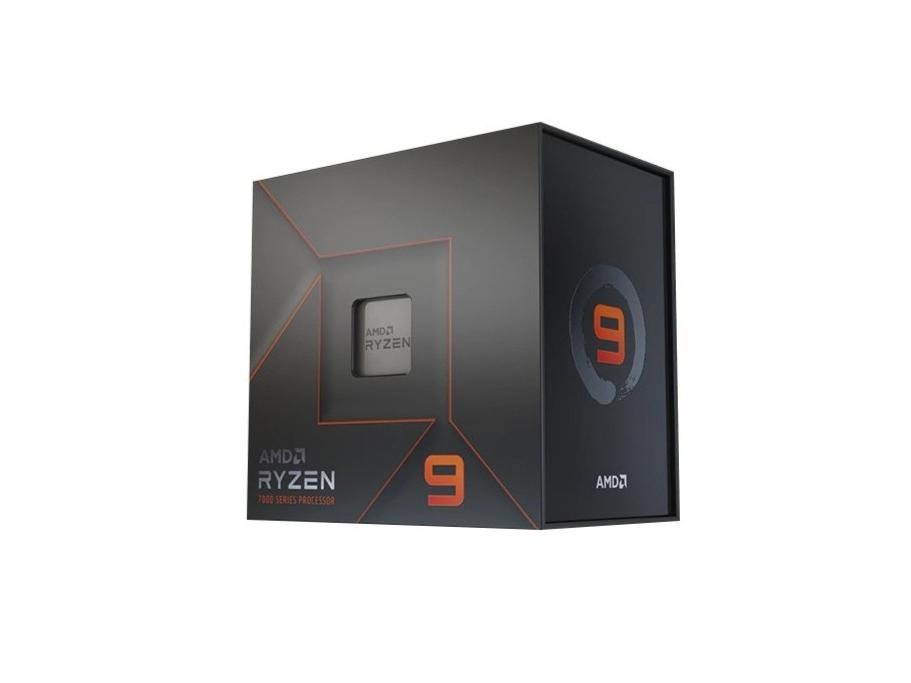
AMD Ryzen 9 7950X(5499元)以纯粹的多核统治力支撑重型科研:16核32线程在Apache Spark MLlib分布式训练中展现线性扩展优势,L3缓存扩容至64MB显著降低Transformer注意力层KV Cache访问延迟;其Precision Boost Overdrive超频技术经实测可在连续72小时Stable Diffusion XL批量生成中维持99.2%频率稳定性,是计算化学分子动力学模拟的理想计算底座。
Intel 赛扬 G5905(290元)以极致成本效能比点亮边缘AI场景:单核性能足以流畅运行YOLOv5s实时推理服务,超线程技术支持同时承载MQTT消息代理与轻量级Flask API网关;其TDP仅58W特性使树莓派级嵌入式设备可扩展为本地模型验证终端,特别适合研究生课题组搭建低成本实验沙箱环境。
五款产品覆盖从边缘推理验证到超大规模模型训练的全科研光谱,它们共享12纳米工艺带来的能效平衡点——在单位瓦特算力、内存带宽密度与I/O延迟控制三个维度,共同构筑AI研究人员本地化计算的新基建标准。选择不止于参数,而在于让每一次反向传播都更接近真理。












 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论