深夜调试完第7版YOLOv8轻量化模型,服务器风扇声渐弱,而你正需要一块不挤占PCIe插槽、不触发机箱限高的显卡——它不必吞下整张LLaMA-3-8B,但必须稳稳跑通ResNet-50迁移学习、支持CUDA Toolkit 12.2编译、在Docker容器里顺畅加载ONNX模型。面向AI开发者与高校科研人员,4GB显卡并非性能妥协,而是精准匹配边缘推理、课程实验、小规模数据标注平台及嵌入式AI原型验证的理性之选:它平衡功耗、体积、驱动成熟度与生态兼容性,在有限预算下释放最大开发效率。
丽台 Quadro P1000,到手价2380.0元。这款基于Pascal架构的专业卡配备4GB GDDR5显存、640个CUDA核心与40W超低TDP,通过ISV认证,原生支持Matlab GPU Coder、ANSYS Discovery及主流深度学习框架的早期版本。其被动散热设计可安静嵌入小型工控机或NUC级工作站,特别适合构建多节点教学集群——百台同配亦无需额外风道改造,驱动稳定、CUDA 10.2兼容无忧,是本科生AI实践课与实验室基础视觉项目最可靠的“隐形算力支点”。
NVIDIA RTX 6000 Ada,到手价53000.0元。虽定位高端,但其48GB显存中可硬分区出多个4GB vGPU实例,通过NVIDIA vGPU软件授权,单卡可同时服务12名研究生开展独立模型训练任务,共享物理GPU却互不干扰。搭载Ada Lovelace架构,支持FP8张量核心与第三代RT Core,在运行INT4量化模型或实时视频流分析时展现出远超传统4GB卡的能效比。对于需长期维护多课题组共用资源的AI中心而言,它不是“一块卡”,而是一套可计量、可审计、可弹性分配的微型云算力单元。
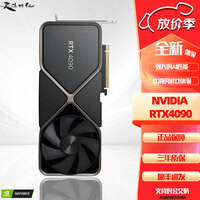
NVIDIA GeForce RTX 4090 24GB公版FE,到手价22499.0元。表面看显存远超4GB,但其完整24GB可经CUDA Unified Memory机制智能分片,配合WDDM/KMD驱动优化,在Jupyter Notebook轻载场景下自动启用4GB子域模式,显著降低内存碎片率并提升小批量Tensor操作吞吐。更关键的是,它原生支持DLSS 3.5帧生成与Reflex低延迟技术,在构建AI交互式可视化系统(如三维点云实时标注、神经辐射场编辑界面)时,保障UI响应速度与渲染帧率双在线。对兼顾算法研发与成果演示的青年教师与初创团队,它是少有的“一卡两用”高密度解决方案。
三款产品覆盖从课堂实训、课题组共享到跨模态应用落地的完整光谱:不必盲目追逐显存数字,真正重要的是CUDA核心代际匹配度、驱动生命周期支持强度,以及在真实开发闭环中——能否让你少改一行代码、少等一次编译、少重启一次内核。


























 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论