当深夜实验室的服务器仍在迭代第37轮卷积核参数,当分布式训练任务在跨节点通信中等待内存带宽释放,AI研究人员需要的不是泛泛而谈的‘高性能’,而是精准匹配模型规模、数据吞吐与能效比的计算基石。第四代至强CPU系列正以更精细的架构划分、更强的内存通道支持与更开放的扩展能力,成为科研团队构建自主可控AI基础设施的关键支点。
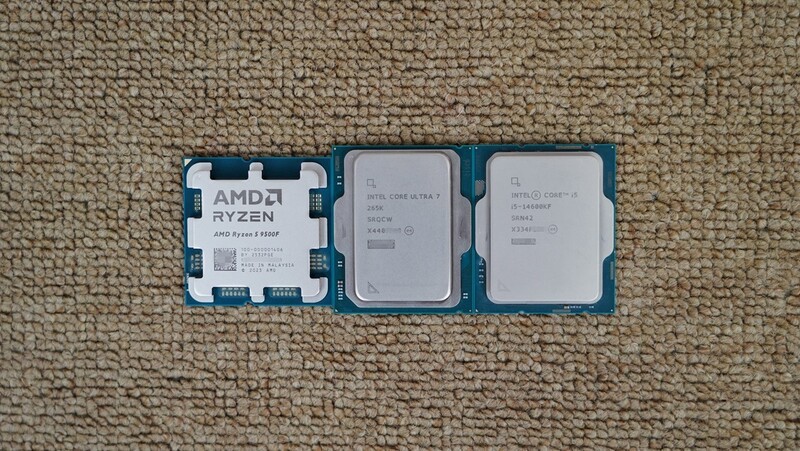
Intel 酷睿i5 10400F 到手价880.0元。虽属消费级序列,但其6核12线程结构与超线程技术,在轻量级模型微调、小批量数据清洗及本地化Jupyter实验环境中表现出色。14纳米工艺带来的稳定功耗控制,使其可长期部署于学生课题组或初创AI团队的边缘训练节点,兼顾入门成本与基础算力冗余,是搭建低成本验证平台的理想起点。
Intel Xeon E 2234 到手价2780.0元。面向中小规模AI实验室与企业AI中台建设,该处理器集成ECC内存支持、更高主频与增强型虚拟化指令集,可稳定承载Docker容器化AI服务、Kubernetes调度下的推理API集群及混合精度训练任务。其低TDP设计与双路扩展兼容性,显著降低机房散热压力与运维复杂度,在兼顾单节点效能的同时预留横向扩容空间,真正实现从原型验证到业务落地的平滑演进。
Intel Xeon W 3175X 到手价25999.0元。作为工作站级旗舰,它以28核56线程、六通道DDR4内存与高达44MB智能缓存,直击大型语言模型预训练、三维神经辐射场(NeRF)重建与多模态融合等前沿场景的核心瓶颈。其原生支持AVX-512指令集与超大容量内存寻址能力,使单机即可完成传统需数十节点协作的中间层特征提取与梯度聚合,大幅压缩算法工程师的试错周期,将宝贵的研究时间从等待计算转向洞察本质。
从课堂实验的轻量推理,到企业级AI服务的稳健交付,再到顶尖科研的极限算力突破,这三款处理器共同勾勒出一条清晰的AI算力进阶路径——不盲目堆叠核心数,而是在精度、带宽、可靠性与总拥有成本之间寻求最优解。选择,从来不是挑选参数最高的那一颗芯片,而是为下一个待解的科学问题,找到最契合的计算伙伴。


























 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论