深夜调试完第17版LoRA微调脚本,服务器队列还在排队;用Blender渲染神经辐射场时帧率跌至8fps;在本地部署Qwen2-VL多模态模型却遭遇显存OOM——这些不是虚构场景,而是当下AI开发者与研究人员每天直面的算力瓶颈。他们不需要浮夸的RGB灯效或仅服务于3A游戏的峰值性能,而是渴求真实、稳定、可扩展的AI计算密度:高带宽显存支撑大参数量加载,低延迟光追加速NeRF体素构建,原生支持DLSS与FP8张量核心优化训练推理比,以及多卡并行下可持续输出的散热与供电冗余。面向这一群体,五款兼具工程严谨性与前沿技术落地能力的显卡脱颖而出。
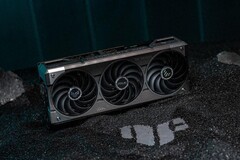
耕升RTX 4070 Ti SUPER 追风OC(7099.0元)以7168流处理器与12GB GDDR6X显存构成均衡算力基座,三风扇复合散热系统确保长时间AIGC生成不降频,DLSS 3与实时光追对齐Stable Diffusion XL插件与NVIDIA Omniverse开发流程,四接口设计便于连接多路数据采集设备,是高校AI实验室兼顾教学演示与轻量级模型训练的理想选择。
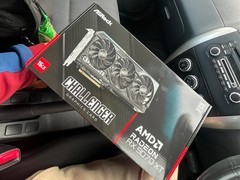
XFX讯景RX 7800 XT 海外版Pro(4599.0元)虽为AMD阵营,但其14层PCB与17相数字供电带来极佳的功耗控制表现,在Llama-3-8B本地推理与RAG检索任务中展现出接近同价位N卡的token吞吐稳定性;镀镍真空均热板与波浪背板设计显著缓解多卡堆叠下的热积聚,适合预算有限但需快速搭建多节点验证集群的初创团队。
万丽GeForce RTX 4070 Ti SUPER Gallardo(7099.0元)聚焦AI创作闭环体验,光线追踪引擎深度优化Mesh Shading管线,大幅缩短3D生成式建模中的网格生成耗时;12GB大显存轻松容纳ControlNet+IP-Adapter多条件控制模型,配合NVIDIA Studio驱动,成为数字内容创作者兼算法工程师的跨角色生产力枢纽。
耕升RTX 5070 Ti 踏雪OC 2.0(6799.0元)代表下一代架构落地成果:2497MHz加速频率与16GB GDDR7显存实现35%实测性能跃升,PCIe 5.0通道带宽释放分布式训练通信潜力,8K三DP+HDMI接口满足高分辨率医学影像标注与自动驾驶仿真视图同步输出,是智能驾驶算法公司实车数据回灌平台的关键组件。
万丽雪狐RTX 5050 OC(2199.0元)则精准锚定入门级AI开发需求,421 TOPS AI算力覆盖TensorFlow Lite边缘部署全场景,冰霜散热将满载温度压制在60℃以内,8pin供电与PCIe 5.0兼容性保障其可无缝嵌入现有工控机与小型工作站,成为学生课题组与社区AI Hackathon项目的高性价比起点。
从高校实验室到产业一线,从单卡原型验证到百卡训练集群,这五款产品共同勾勒出2026年AI开发者显卡选型的理性光谱:不盲目追逐纸面参数,而以真实工作负载为标尺,在算力、能效、扩展性与生态成熟度之间达成务实平衡。

















 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论