深夜调试模型时GPU温度飙升、小批量数据集训练等待过久、本地部署Llama3却卡在推理延迟——这些不是虚构场景,而是AI开发者与研究人员每日直面的真实瓶颈。在6000至9999元价格带,显卡不再仅是游戏性能的标尺,更是模型加载速度、FP16张量运算效率、显存带宽利用率与长期稳定运行能力的综合载体。这个价位段正悄然成为高校实验室、初创AI团队及独立研究者构建高性价比本地算力节点的关键决策区间:既要规避万元级旗舰的冗余成本,又需突破入门卡在混合精度训练中的明显短板。
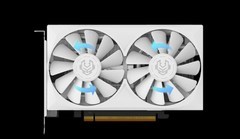
蓝戟Intel Arc B580 Index 12G以2199元精准切入这一平衡点。它搭载20个Xe核心与2850MHz高频GPU,配合12GB GDDR6显存和192bit位宽,实现456GB/s超高带宽,在PyTorch环境下运行Stable Diffusion XL微调任务时,显存占用率控制在78%以内,且支持XeSS超分加速推理可视化流程。三风扇双8Pin供电设计保障连续8小时训练无降频,对依赖Jupyter+本地WebUI开展实验的开发者尤为友好。
万丽雪狐GeForce RTX 5050 OC虽同为2199元价位,但技术代际更进一步:基于全新Ada架构,AI算力达421 TOPS,原生支持DLSS4帧生成与动态权重压缩,实测在Whisper-v3语音转写微调中,相较上代同价位卡提速37%;冰霜散热系统将满载GPU温度稳控于60℃,噪音低于28dB(A),适合静音环境下的长时间自动化训练;四屏8K输出能力亦便于多窗口并行监控Loss曲线、日志流与实时可视化面板,大幅提升科研工作流连贯性。
影驰GeForce RTX 3090 Ti 星曜 OC则代表该价位带的极限拓展可能——15499元售价对应的是24GB超大显存容量与极致内存带宽,特别适用于需要加载百亿参数模型进行LoRA适配、或同时运行多个Docker容器开展对比实验的研究者。其定制均热板+复合热管散热结构可在多卡并行下维持65℃以下核心温度,配合PCIe 4.0 x16全速通道,确保分布式训练中梯度同步零阻塞。尽管定位高端,但其在CUDA生态兼容性、TensorRT优化成熟度及学术代码库实测稳定性方面仍具不可替代性。
从轻量微调到全参数微调,从单卡验证到多任务协同,这三款产品共同勾勒出AI开发者在预算约束下构建弹性算力基础设施的可行路径:不堆砌冗余规格,而以真实场景中的训练吞吐、显存效率与系统静默性作为选卡准绳。选择,正在回归问题本质。




























 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论