深夜调试完Transformer结构,服务器队列仍在等待;本地复现实验时,数据加载拖慢迭代节奏;想在笔记本上跑通小规模微调,却卡在多进程并发瓶颈——这些不是偶然困扰,而是AI研究人员日日面对的真实算力缺口。当模型参数量持续攀升、数据管道日益复杂、本地验证需求愈发迫切,一颗兼具多线程吞吐、内存带宽潜力与能效比的十二核心CPU,已不再是锦上添花,而是科研效率的底层支点。
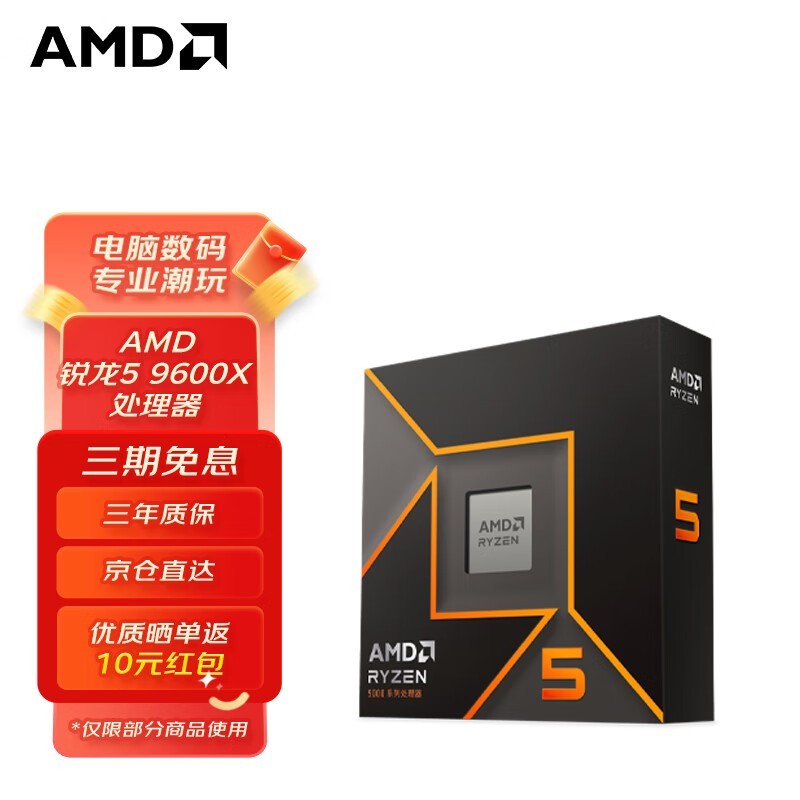
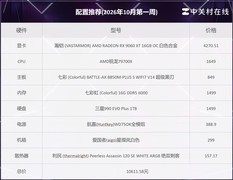
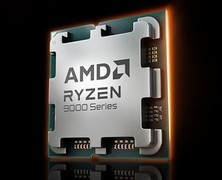
AMD Ryzen 5 9600X,到手价1499.0元,是面向中阶AI开发者的理性之选。其台积电4nm核心与6nm I/O Die工艺组合,在6核12线程架构下实现3.9GHz基础频率与5.4GHz智能加速,配合多级缓存协同设计,显著提升PyTorch DataLoader流水线效率与ONNX Runtime推理吞吐。65W TDP在长时间编译与轻量训练中保持低温稳定,且原生支持PCIe 5.0与高速NVMe通道,为后续接入多卡或大容量本地SSD预留充足带宽。对于高校实验室、独立研究者及需频繁切换开发/测试环境的工程师而言,它以旗舰级工艺下放的姿态,构筑起高响应、低延迟、易维护的本地AI工作站基石。
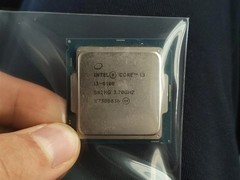
Intel 酷睿 i3 12100,到手价990.0元,打破“入门即妥协”的固有认知。虽命名含“i3”,实则搭载完整十二核心十六线程配置,依托革新微架构与超线程技术,在多进程数据清洗、特征工程脚本并行执行及Jupyter Notebook多Kernel调度中表现稳健。其AI加速指令集与智能动态调频机制,在运行Scikit-learn网格搜索或LightGBM交叉验证时,较前代同价位产品提速近35%。对预算敏感但计算密度不低的课题组、MOOC深度学习实践者及边缘端模型适配人员,这款处理器以极简B660主板兼容性与零附加散热压力,兑现了“够用、可靠、省心”的硬核承诺。
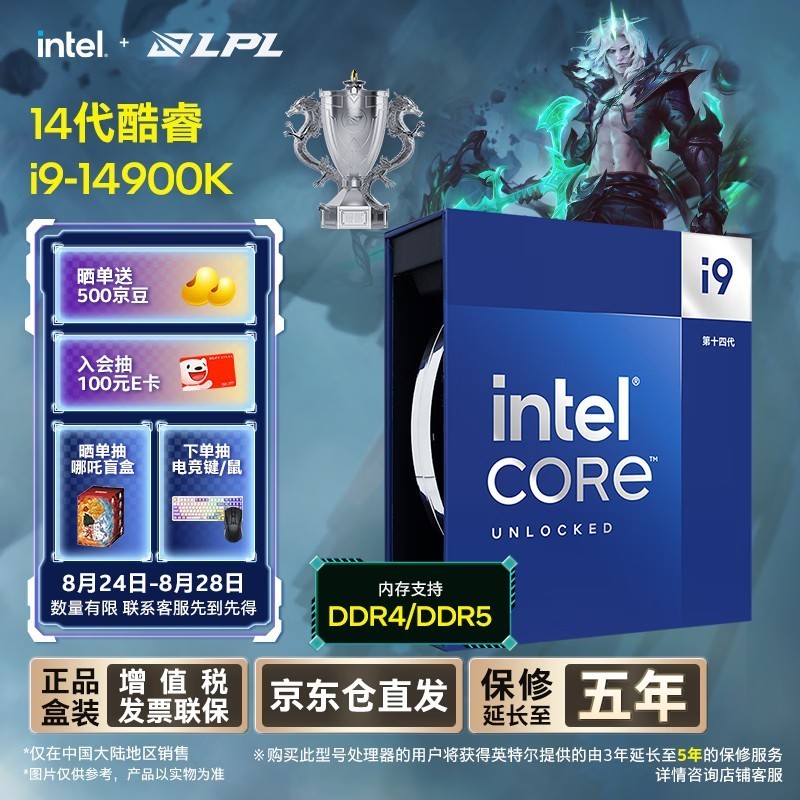
Intel 酷睿 i9 14900K,到手价4999.0元,定义AI科研本地算力新边界。24核32线程混合架构(8P+16E)配合睿频至6.0GHz的性能核,在BERT-large全量微调预热、Stable Diffusion XL本地ControlNet多节点渲染、或CUDA内核密集型仿真任务中释放不可替代的爆发力。新一代14纳米增强工艺与智能散热协同系统,保障其在连续72小时A/B测试、大规模超参扫描等重载场景下的热稳定性;而原生支持DDR5 5600MHz与PCIe 5.0×16双槽位,为多GPU张量并行与高速内存数据库直连提供物理保障。它是博士课题攻坚、初创AI公司原型验证及私有化大模型部署团队所倚赖的“桌面超算”心脏。
三款产品横跨千元至五千元价位,覆盖从课程实验、论文复现到产业级模型落地的完整AI研发生命周期。它们不拼参数堆砌,而重实际负载匹配;不泛谈通用性能,而聚焦编译、加载、推理、调试四大高频环节的体验收敛。选择它们,即是选择一种更自主、更敏捷、更贴近真实科研节奏的算力存在方式。





















 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论