当凌晨三点的服务器集群仍在迭代Transformer权重,当CUDA核心持续满载而CPU仍需调度数百个数据加载进程,AI研究人员真正需要的不是纸面参数的堆砌,而是稳定释放十六核真实算力的底层引擎——它要扛得住长周期多任务调度,经得起混合精度训练中内存带宽的反复压测,更要在有限预算内兼顾未来三年架构演进的兼容性。面对分布式训练、模型量化、神经架构搜索等典型科研负载,处理器的多线程吞吐、缓存一致性、内存延迟与PCIe扩展能力,远比单核频率更具决定性。
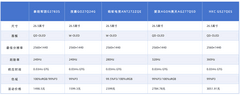
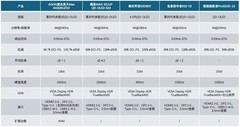
Intel酷睿i7-13790F以2999元的亲民价格切入高端科研市场,16核24线程设计在P核+E核异构架构下实现能效比跃升,5.2GHz Turbo Boost Max 3.0保障关键路径响应,33MB智能缓存大幅降低LLM预训练中KV缓存交换开销,DDR5 5600MT/s双通道支持为FAISS向量检索提供充足带宽,65W基础功耗配合219W睿频功耗,在静音工作站环境中实现性能与散热的理性平衡,是高校课题组搭建低成本训练节点的理想选择。
AMD Ryzen 9 3950X虽属前代旗舰,但5749元价位展现出惊人线程密度价值:16核32线程全物理核心设计,在Cinebench R15多核测试中斩获5501cb高分,GeekBench多核达61072分,其32MB大容量L3缓存对Hugging Face生态下的大批量文本生成任务尤为友好;7nm工艺与AM4平台成熟生态,使其在BERT微调、语音特征提取等IO敏感型任务中保持极低延迟,适合已部署X570主板的实验室平滑升级。
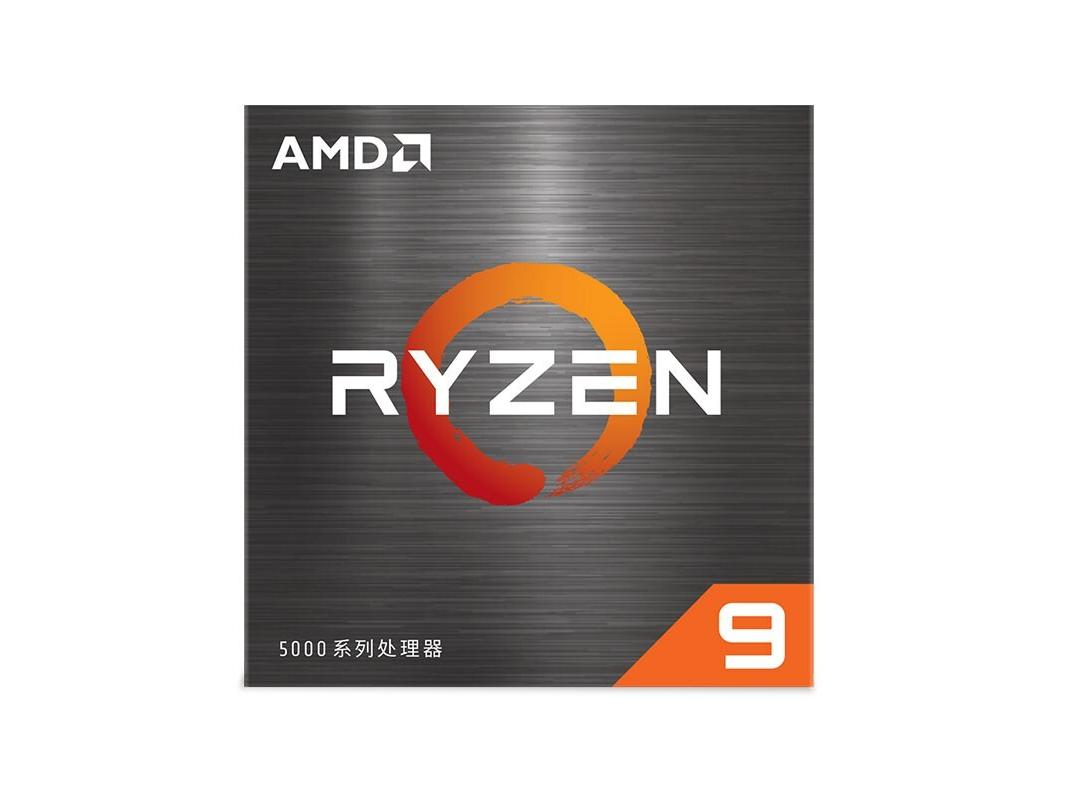
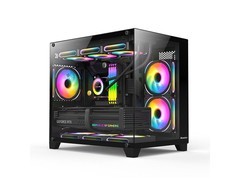
Ryzen 9 5950X以5270元提供更进一步的架构进化,16核32线程搭配64MB三级缓存,4.9GHz加速频率与AM4接口延续性,使其成为攀升IPASON高达联名主机的核心驱动力;该配置捆绑RX 6900 XT显卡,构成少有的CPU+GPU协同优化科研套机,在Stable Diffusion本地化训练、OpenMMLab视觉模型调试等场景中,PCIe 4.0双向带宽显著缩短梯度同步时间,Ubuntu/RHEL原生兼容性则降低环境部署门槛。
Intel酷睿i9-12900K以4430元定位性能中枢,16核(8P+8E)24线程与5.5GHz全核睿频组合,在TensorRT引擎编译、ONNX Runtime推理优化等CPU密集型环节表现突出;Z690平台原生支持PCIe 5.0 x16,为后续接入国产AI加速卡预留扩展空间,其LGA 1700接口亦与13代产品共享散热与供电设计,适合规划中长期技术路线的AI实验室进行模块化升级。
四款产品覆盖从入门科研节点到全栈AI工作站的不同建设阶段,价格梯度清晰,架构逻辑互补。对AI研究人员而言,十六核早已不是参数游戏,而是数据管道的承重梁、算法迭代的时间压缩器、以及科研产出效率的真实刻度。
















 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论