当代码在Jupyter中编译完成,当LoRA微调进入收敛阶段,当Stable Diffusion生成的第1024张图开始呈现语义一致性——AI开发者真正需要的,不是纸面参数堆砌的‘旗舰’,而是能稳定跑满Tensor Core、支持新一代AI加速指令集、兼顾静音散热与机箱兼容性的生产力核心。面向AI开发者与科研人员,显卡不仅是图形处理器,更是本地大模型训练、轻量化部署、实时推理验证的关键算力节点。对实验室预算敏感、重视长期稳定性、需平衡单卡性能与多卡扩展能力的用户而言,显卡选择必须直指DLSS 4支持度、GDDR7带宽利用率、CUDA核心密度及实际FP16/INT8吞吐表现。
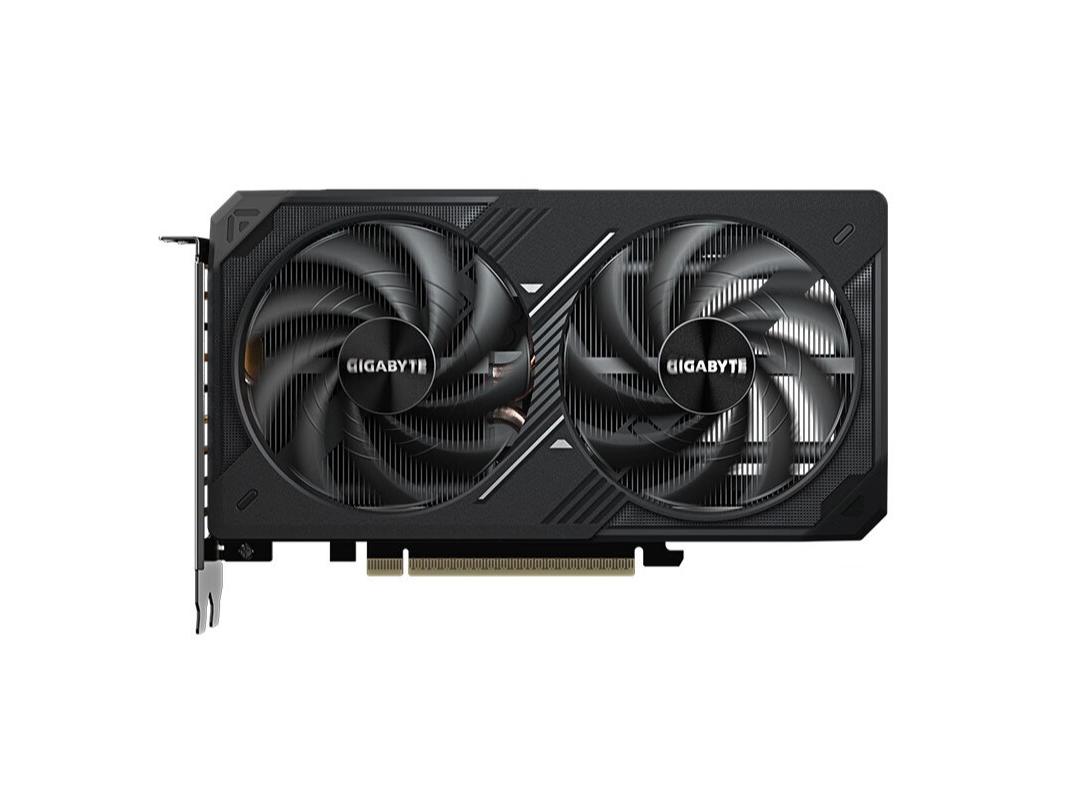
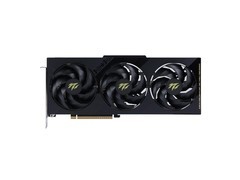
技嘉 GeForce RTX 5060 Ti WINDFORCE MAX OC 8G,到手价3499元,是当前AI轻量开发场景中的高均衡之选。基于Blackwell架构GB106核心,4608个CUDA核心配合第四代RT Core与第五代Tensor Core,在ResNet-50训练与Whisper-small语音识别等典型任务中展现出优于上代RTX 4070的单位瓦特推理效率;8GB GDDR6显存虽非顶配,但19Gbps速率与304GB/s带宽足以支撑7B模型量化推理与中等规模LoRA微调;21.5cm短卡设计与双槽厚度,完美适配主流ATX及紧凑型工作站机箱,智能风扇启停技术更保障夜间批量训练时的零干扰静音运行,是高校课题组与独立研究者构建低成本AI实验平台的理想起点。
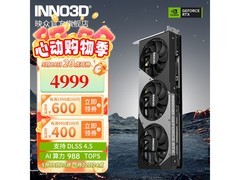
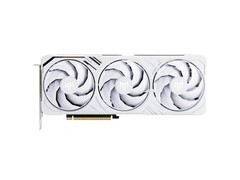
NVIDIA RTX 5070(含万丽雪狐OC与七彩虹iGame Ti双版本),到手价4599元,代表了AI开发中端性能的全新标杆。GB205核心带来12GB/16GB GDDR7显存配置,672GB/s超高带宽显著提升Llama-3-8B全参数微调数据吞吐;三风扇+双BIOS切换设计兼顾高负载持续输出与调试模式低噪需求;DP2.1b与HDMI2.1b接口组合便于连接多屏开发环境与外接AI视觉采集设备;其250W–300W功耗区间在保持高性能的同时,避免对电源与散热系统提出过度挑战,特别适合需要单卡承载完整训练-验证-部署链路的中小型AI团队。
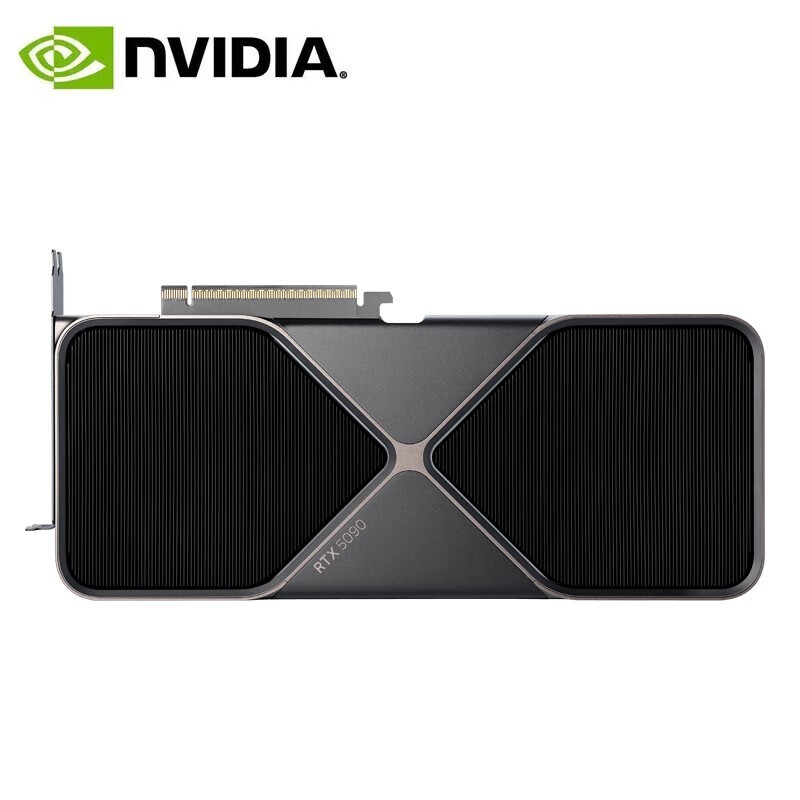
NVIDIA RTX 5090 FE公版,到手价24399元,是面向前沿AI研究的终极计算引擎。21760个CUDA核心、32GB GDDR7超大显存与512-bit位宽,使其可在单卡上原生运行13B级模型全参数训练,并支持FP8精度下的千卡级集群仿真测试;液态金属导热与575W图形功率设计确保长时间高负载下频率不缩水;PCIe 5.0接口与DP2.1输出为未来多模态AI工作站预留扩展空间;尽管价格高昂,但对于国家级重点实验室、大模型初创企业核心训练节点及需要本地化合规推理的政企AI项目,它已不仅是显卡,更是可信算力基础设施的关键组件。
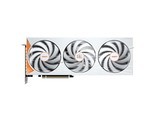
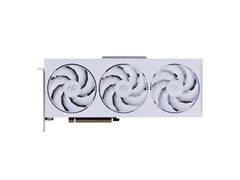
七彩虹 iGame GeForce RTX 4060 Ultra W DUO 8GB,到手价2499元,作为成熟可靠的技术锚点,依然在入门级AI开发中保有独特价值。虽基于Ampere架构,但其8GB GDDR6显存与PCIe 4.0带宽可流畅运行BERT-base微调、YOLOv8目标检测等经典任务;双风扇散热与2000g扎实用料保障长期运行稳定性;对于预算有限的学生团队、MOOC课程实践平台或边缘端AI原型验证场景,它提供了极低门槛的CUDA生态准入体验,是构建AI认知与工程习惯的第一块坚实基石。
从2499元的教育友好型入门卡,到24399元的科研级算力旗舰,四款产品共同构成2026年AI开发者显卡配置的立体光谱——它们不盲目追逐峰值参数,而以真实任务效能、生态兼容性与长期使用成本为标尺,在模型规模、训练周期、部署形态与资金规划之间,给出理性而坚定的答案。
















 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论