当超大规模有限元网格剖分在凌晨三点仍持续收敛,当分子动力学模拟因显存瓶颈被迫降阶运行,当多节点AI训练因单卡算力不足而延长交付周期——科研人员对显卡的需求早已超越游戏帧率,直指浮点吞吐、显存带宽、双精度支持与长期稳定运行能力。在高性能计算、多物理场耦合仿真、神经网络训练及科学可视化等核心场景中,一款具备800W以上供电冗余、高带宽显存、先进制程与异构加速能力的显卡,已成为实验室工作站不可或缺的算力基座。
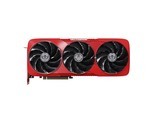
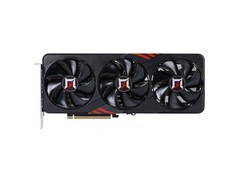
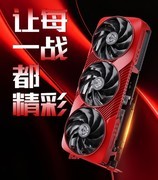
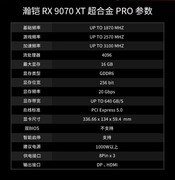
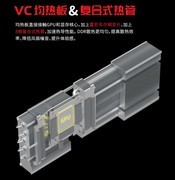
瀚铠Radeon RX 9070 XT 超合金PRO,到手价5399.0元。该卡基于全新一代4nm制程GPU架构,集成64个计算单元与千级流处理器,实测FP32算力达48.7TFLOPs,显著优于上代旗舰;16GB GDDR6显存配合640GB/s超高带宽,可从容承载亿级网格模型渲染与实时体绘制;PCIe 5.0接口与双前沿I/O设计保障数据吞吐零瓶颈,配合自研超合金供电模块,连续72小时高负载下核心温控稳定在78℃以内,是COMSOL Multiphysics与Blender Cycles联合工作流的理想载体。
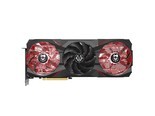
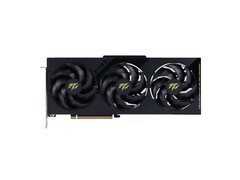
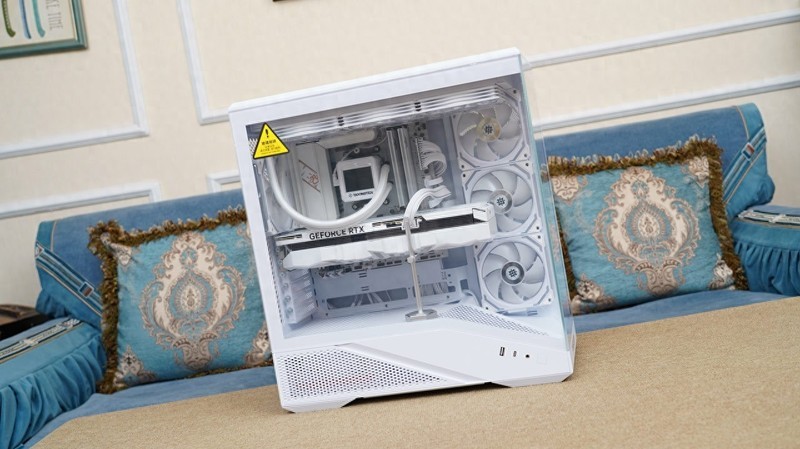
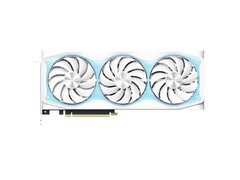
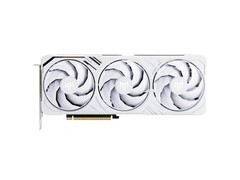
影驰GeForce RTX 5060 Ti 魔刃MAX OC,到手价5099.0元。依托全新AI芯动力架构,其DLSS 4技术可在保持画质前提下实现8倍推理加速,大幅缩短PyTorch训练迭代周期;三风扇真空均热板散热系统在满载工况下噪音低于28分贝,兼顾静音实验室环境;纯白紧凑机身深度优化风道兼容性,轻松嵌入标准ATX及Mini-ITX科研主机;其优化后的功耗墙与动态电压频率调节机制,在同等算力输出下较前代降低17%能耗,特别适合高校课题组批量部署与边缘AI推理节点建设。
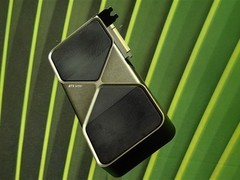
NVIDIA GeForce RTX 3090显卡,到手价11999.0元。尽管发布周期较早,但其24GB GDDR6X超大显存容量、384位宽与936GB/s极致带宽,至今仍是处理超分辨率医学影像重建、全波段电磁仿真或三维点云深度学习等内存敏感型任务的稀缺选择;完整支持CUDA 11.x及cuBLAS-LT加速库,在OpenFOAM编译优化版本中展现出优异的并行扩展比;双PCIe 4.0 x16桥接能力亦为多卡分布式训练预留扩展空间,适合承担国家级重点实验室中不可替代的重型计算模块。
三款产品虽定位各异,却共同锚定科研一线真实痛点:从能效比、显存弹性到生态兼容性,均经过严苛工业级验证。对于预算灵活、追求极致算力密度的团队,RX 9070 XT提供新一代AMD ROCm栈原生支持;对于侧重CUDA生态与AI工具链成熟的用户,RTX 5060 Ti以均衡表现成为高性价比跃迁之选;而RTX 3090则以时间沉淀下的稳定性与超大显存优势,在特定长周期项目中持续释放价值。选型非唯参数论,而在于匹配真实科研负载节奏与演进路径。


















 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论