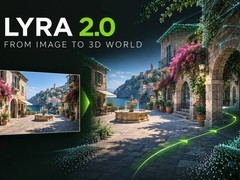
英伟达近期公开了空间智能实验室研发的Lyra 2.0系统。该系统以单张静态图像为输入,能够生成具备主动视角探索能力的连续画面,并进一步构建出可从任意角度实时渲染的稳定三维环境。
用户可通过自定义镜头路径控制观察视角,即使移动范围超出原始图像所覆盖的区域,系统仍可持续生成后续画面,并维持整体虚拟空间在几何与视觉层面的一致性。所生成的视频序列可进一步转化为标准的三维高斯表示与多边形网格模型,便于导入各类仿真平台,支持机器人感知、决策与行为训练等任务。
Lyra 2.0特别针对生成式三维建模中常见的两类核心问题进行了优化:空间遗忘与时间漂移。前者表现为系统重复访问同一空间位置时输出结构不一致;后者则体现为随视角延展,几何形变与纹理偏差持续累积。为应对上述挑战,研究团队引入一种受三维几何特征驱动的空间记忆机制,支持跨帧检索历史观测数据;同时在训练阶段主动引入模型自身生成的非理想输出,使系统具备持续识别并校正误差的能力。
在推理效率方面,经知识蒸馏优化后的轻量模型将视频生成所需的去噪步数由35步大幅缩减至4步,单次推断耗时约为原模型的十三分之一。实验表明,在单块GB200 GPU上生成80帧视频片段,轻量模型耗时约15秒,而完整模型则需约194秒。
当前版本尚无法实现全场景实时三维生成,计算开销仍较高,且主要面向静态环境建模。对动态物体的建模能力有限,偶发的视觉不连贯现象亦尚未完全消除。因此,该技术现阶段更适合作为环境资产辅助生成工具,在游戏开发流程中提升前期场景搭建效率,而非直接由一张图片生成具备完整交互逻辑的可运行游戏。
该研究成果最早于2026年4月对外发布,后于2026年11月在SIGGRAPH Asia会议前夕再次作为重点成果进行展示。相关代码已在GitHub平台开源,模型权重同步发布于Hugging Face,使用须遵循英伟达规定的学术研究许可条款。

 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论