大模型持续迭代,智能体Agent应用加速落地,AI产业已经从训练为主转向大规模推理运行阶段。海量数据爆发增长之下,存储早已不再是算力的附属配套。过去行业更加看重存储“把数据存下来”的基础能力,而如今产业更需要存储主动参与AI全业务流程,实现数据流转、知识沉淀、记忆留存,存力成为决定AI实际产出、算力利用效率的关键底座。
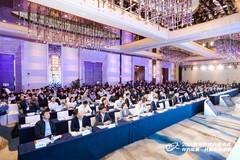
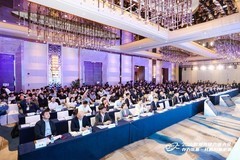
在此产业背景下,10月29日,2026数据存储产业大会于河南郑州召开。本次大会由中国电子工业标准化技术协会主办,中电标协数据存储专业委员会承办,曙光信息产业(北京)有限公司、华为技术有限公司协办,400余位来自政府、科研院校、产业企业、行业用户代表齐聚郑州,围绕“存力筑基,共启 AI新机遇”,共同研判存储产业角色变迁与未来发展路径。
从“聚力”规模扩张,迈向“筑基”能力建设
国内存储产业历经多年发展,完成了产业要素汇聚的“聚力”阶段。伴随AI浪潮席卷各行各业,行业矛盾发生显著变化,产业发展重心从硬件规模扩张,转向全栈系统能力的“筑基”建设。
中国电子工业标准化技术协会理事长张宏图在大会上谈到,AI时代数据的要求已经升级,海量数据不仅要存得下,更要流得动、转化为知识、留得住记忆。大会主题由往年的“聚力”转变为今年的“筑基”,正是产业实践沉淀后的现实选择。后续专委会将依靠创新驱动、标准引领、生态协同,将存力筑基的蓝图转化为实实在在的产业能力。
工信部电子信息司电子系统处处长金磊在致辞中指出,存储正式进入AI驱动的超级周期,需求结构的底层变革重新定义存储价值。存储产业被列为电子信息领域培育新质生产力的核心方向,纳入《电子信息制造业发展“十五五”规划》统筹布局,主管部门将在规划布局、技术攻关、生态培育等方向持续发力,为产业发展提供顶层支撑。河南省、四川省工信部门相关领导出席本次大会,推动存力产业跨区域协同发展。
报告、全景图、标准夯实产业发展底座
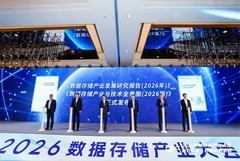
产业筑基,离不开产业研判工具、统一标准体系作为支撑。本次大会集中发布多项重磅成果,为全行业建立共识参考。
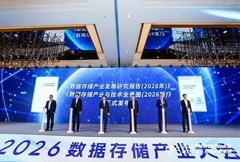
会上正式发布《数据存储产业发展研究报告(2026年)》以及《数据存储产业与技术全景图(2026版)》。报告剖析产业现状、痛点挑战,梳理年度十大产业趋势与创新实践,输出产业发展倡议;产业全景图完整梳理上下游生态,厘清产业链参与主体与产品体系,技术全景图聚焦前沿创新,完整展现存储全链条技术体系,两份成果互为补充,为企业决策提供依据。
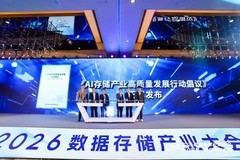
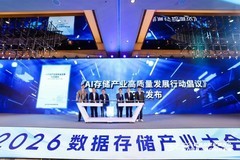
围绕未来存储创新、先进存力、存储标准三大专项,专委会落地系列成果:发布《AI存储产业高质量发展行动倡议》,明确AI存储参考架构与核心技术方向;联合赛迪顾问推出《2026年先进存力发展洞察》,解析先进存力内涵、市场规模与竞争格局;39家单位联合编制两项AI存储团体标准正式对外发布,同步启动存储系统参考架构国家标准编制,完成团标向国标转化,补齐AI存储标准体系关键短板。
大会同期设置企业联合展区,集中展示前沿存储硬件与AI存储解决方案,并且组织“走进先进存力—国家超算互联网核心节点”参观活动,让产业代表实地感受国内先进存力基础设施的落地成效。
AI重构存储技术逻辑,中科曙光提出“AI数据工厂”新范式
研究报告与标准划定产业方向,而现场主题演讲以及会后媒体专访,则把产业思考落到真实技术与业务痛点之上。本次大会,众多专家围绕超智融合架构、KV Cache存储、闪存国产化突围等热点议题开展深度交流。
华中科技大学金海教授从学术视角提出,想要破解困扰行业已久的“内存墙”瓶颈,不能依靠单点技术改良,必须推动新材料、器件、系统架构多领域协同创新,化解智能存储工程落地难题。
华为副总裁、数据存储产品线总裁袁远提出“以存强算、以存治数”发展思路。他认为存储要实现数据高效供给复用,提升算力集群利用率,深挖本土行业数据资源,把数据资源转化为我国AI产业的独特竞争优势。
在一众产业观点中,中科曙光分布式存储产品部总经理石静在大会主题演讲以及会后媒体专访中完整阐释“Token 时代,存储跃升 AI 数据工厂”这一核心判断,直面当前大模型、智能体落地过程中的成本、效率痛点,重新定义存储在AI业务链条当中的定位。
存储从被动数据容器,跃迁为主动的AI数据工厂
石静表示,过去存储的定位只是被动存放数据,但是进入Agent与Token爆发的时代,AI业务对存储的期待已经完全改变。存储不能再做“旁观者”,需要深度参与AI从数据采集、处理、训练到推理的全业务链路,转型成为一座“AI数据工厂”。
在她的构想中,AI数据工厂的理念分为四大核心层面:首先要成为全域数据底座,统一管理来源各异的海量数据;第二,实现多业务全面承载,跨业务智能调度,打通不同业务环节;第三,打造高效IO管道,实现全栈协同优化;第四,深度融入AI业务流,和向量数据库、RAG等组件联动,构建自动化流水线,提升整体生产效率。
面对采访,石静进一步拆解这套理念如何解决企业现实难题。企业数据来源分散、协议各异,曙光依靠多协议融合能力,实现文件、对象协议互通,同时原生支持KV Cache语义,搭配集中化异构存储管理平台,完成全局数据视图,让分散的数据能够便捷服务AI应用。
针对AI场景普遍存在的数据拷贝拖慢GPU算力的痛点,AI数据工厂通过元数据预加载、边处理边推送两种技术路径,重叠计算与IO过程,最大限度消除算力空泡。简单来说,不再完整拷贝全部数据集,而是按需加载数据,避免GPU长时间等待数据迁移带来的算力浪费。
对于传统存储行业用户,石静用工厂流水线的通俗比喻解释AI数据工厂的价值:AI推理、训练最终产出高质量Token,AI数据工厂就是服务Token高效生产的流水线。一方面打造高性能IO管道,提升数据流转效率;另一方面构建跨介质、跨地域的数据“传送带”,让数据在不同生产阶段顺畅流转;同时在存储侧完成数据清洗、标注,向上游算力输出标准化数据,以此实现Token更高产出效率与规模化能力。
长链路AI业务链条繁琐,从数据采集、清洗、训练,再到推理,还存在推理结果反哺训练的闭环。石静介绍,AI数据工厂依靠统一纳管打通整条业务链路,配合预取、边处理边推送的以存促算技术,同时支持推理沉淀的知识、记忆反向回馈模型,实现模型持续迭代优化,打通端到端闭环。
面向智能体Agent带来的高频碎片化小IO、KV Cache管理等新挑战,曙光也形成对应的技术方案。通过小文件聚合、BurstBuffer技术应对海量小文件;分布式元数据集群分担并发请求;软硬件结合的“超级隧道”技术压低IO时延,保障Agent任务长链路稳定运行。
在产品落地上,曙光依靠ParaStor分布式存储、FlashNexus集中式存储双轮驱动,共同支撑AI数据工厂底座,并且封装为ParaCache方案,完成KV Cache多级存储分层。FlashNexus集中式存储定位L3.5层,主打低长尾时延;ParaStor分布式存储作为L4共享KV池子,具备大容量扩展能力,并且已经在国内头部大模型企业实现商用落地。二者技术同源,可以实现数据跨产品自由流动,覆盖训练、推理、归档全场景。
谈及为什么会形成“AI数据工厂”这一判断,石静结合大量一线客户实践表示,现在用户已经不再只关心存储带宽、IOPS指标,而是希望存储深度融入AI流水线,把算子下沉、提前感知数据加载需求,以此拉高GPU利用率。叠加存储介质成本压力,客户迫切希望减少数据重复拷贝,提升存储资源利用率,这些真实的产业变化,推动曙光提出存储向AI数据工厂跃迁的思路。
此外在绿色存力层面,曙光高密液冷存储已经在新建算力中心批量落地,同时通过CPU功耗管控、纠删码、重删压缩等软件技术,进一步降低存储整体能耗。
针对行业普遍存在的预算认知落差:客户采购存储习惯按照容量、带宽做评估,但KV Cache属于中间状态数据,石静也给出曙光的评估方法论。不再单纯看存储容量,而是对比不同层级存储的性价比,分别针对内存尚能承载KV Cache、内存被打爆两种业务场景,测算外置存储带来的Token吞吐收益。实测场景中,将KV Cache卸载到L4分布式存储,Token吞吐性能相比GPU重复计算提升15 25倍,单TB分布式存储成本仅为内存的约1/40,帮助客户找到性能与成本的平衡点。
行业展望:存力筑基是系统工程,软硬协同打开 AI 新空间
本次2026数据存储产业大会,是国内存储产业向AI时代转型的缩影。当前市场目光更多聚焦算力,但存力短板会直接限制算力价值释放。存力筑基,并不是简单堆砌硬件设备,而是架构创新、标准建设、数据治理、产品落地、生态协同共同组成的系统性工程。
从大会发布的研究报告、团体国家标准,到中科曙光“AI数据工厂”这类来自产业一线的落地范式,都指向同一个方向:AI时代的存储,价值已经从“存数据”升级为“生产数据价值”。
面向未来,数据存储专委会将持续联动政产学研用各方,以先进存力筑牢数字底座,依靠标准体系牵引技术迭代,以开放生态激活创新动能。产业企业也将持续打磨产品与方案,让存力真正成为AI高质量发展的坚实底座,共同把握AI时代存储产业全新发展机遇。








 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论