当万卡GPU集群启动大模型训练,真正决定吞吐上限的,往往不是显存带宽或FP16算力——而是迈络思交换机、迈络思网卡与迈络思线缆所构筑的底层互连骨架。数据在节点间每多绕一层协议栈、每增加一次内存拷贝、每遭遇一次拥塞丢包,千亿参数的梯度同步就多一分停滞。空转的GPU,是算力最昂贵的沉默。
英伟达Networking(原Mellanox)以InfiniBand与RoCE双轨并进,定义AI智算时代的网络范式。其产品非通用硬件,而是专为All-to-All通信、梯度聚合、参数广播等典型负载深度优化的算力加速器。
? InfiniBand:超低延迟确定性网络
从EDR到XDR世代,迈络思Quantum系列交换机持续刷新端口级时延下限——Q3400液冷硅光机型实现800G单端口、90ns级端到端转发;QM9700与QM9790凭借SHARPv3网络内计算能力,在MPI AllReduce场景中将通信延迟压缩至传统方案的1/4;SB7890与SN4600则分别稳守高密接入与AI Spine核心位。全系原生支持RDMA,零CPU干预、微秒级抖动、万卡无损扩展。
? RoCE:以太网生态中的性能跃迁
依托Spectrum系列交换机与ConnectX系列迈络思网卡协同,构建Zero-Touch RoCE v2无损网络。SN4410与SN4600提供PFC+ECN+DCQCN三级拥塞控制闭环,配合ConnectX-7 200G网卡的硬件级流量调度,让标准以太网具备HPC级通信确定性。
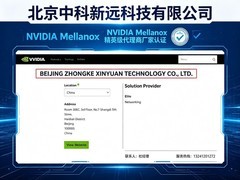
所有迈络思交换机、迈络思网卡、迈络思线缆,均通过NVIDIA Networking精英级认证体系严格审核。北京中科新远科技有限公司作为官方授权代理商,持有全品类原厂分销资质,覆盖IB与RoCE全技术栈,服务智算中心、高校实验室及AI原生企业超百家。八年专注高性能互连部署,支持从架构设计、设备选型、现场测试到集群调优的一站式交付。
如需获取Q3200/XDR交换机配置建议、ConnectX-7网卡兼容清单、或定制化IB/RoCE拓扑方案,请即刻联系北京中科新远杜经理:13241201272。
(经销商资质可于NVIDIA官网Partner Locator实时核验)


 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论