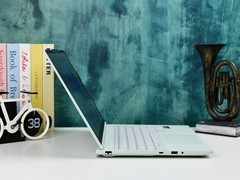
未来人类X98实测:一份100,823 字的中文文档,29.7秒读完;读完之后随便挑一处细节问,1到 4秒给出答案。过去谈本地大模型,话题总停在“能不能跑起来”。这次我们想问的是另一个问题:跑起来之后,好不好用,能不能一直用。
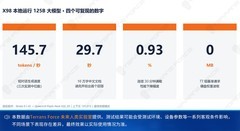
答案是这组数:短对话生成中位145.7 tokens/秒(约每秒183个汉字),连续30 分钟满载性能下降0.93%,模型常驻内存后,整个推理过程没有读一次硬盘。
一、移动终端本地大模型的现实阻碍
专业用户选择本地推理,核心诉求集中在数据安全与使用成本,但落地时通常卡在两处。
一是显存资源。以常见的 4-bit 量化为例,125B级模型的权重体积约60-70G,多数笔记本独显难以完整承载;二是云端服务的固有局限。云端调用需要把业务文档、代码、客户资料上传至服务商服务器,存在数据流转与合规压力,同时按token 计费、高峰排队。
二、四条通道一起决定速度
处理器——IntelCore Ultra 9 290HX Plus,24核 24 线程,睿频5.5GHz。在本地推理里它不是配角:显存没命中的专家,由CPU 直接在内存里计算,实测引擎在本机启用了23 个工作线程同时开工。
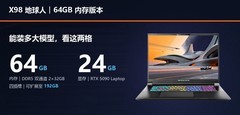
显卡——NVIDIARTX 5090 Laptop,24GBGDDR7,Blackwell 架构、第5 代 Tensor Core1824 AI TOPS。它负责常驻最常用的那批专家,实测装下11,837 个,占模型24,576 个专家的四成半。
内存——64GBDDR5 双通道2x32GB,四个插槽最高可扩展至192GB。内存决定这台机器能加载哪一档量化模型,这是它和大显存台式机最实在的差距所在。
显卡链路——处理器与显卡之间实测PCIe Gen5 x16(空闲时节能降至Gen1)。专家从内存换进显存,走的就是这条路。
跑大模型从来不是显卡一个人的事,这四条通道一起决定它有多快、能装多大。
三、24GB显存装不下125B,未来人类X98怎么接住
未来人类X98本次测试的模型Qwen3.8-Flash-Next是MoE(混合专家)架构,共48 层、每层512 个专家,合计24,576 个专家模块;IQ2_XS档的专家权重约35.5GB,模型文件合计约70GB——显存装不下全部专家,内存也装不下整个模型文件。Strata引擎的做法是按热度分层,把不同部分放到不同介质上:
1.显存层:常驻高频访问的11,837 个热专家(约占总量48%),并随对话内容自适应换入换出;
2.内存层:以锁页方式承载其余全部专家权重(实测锁页池33,812 MiB,约33GB),未命中的专家由处理器就地计算,与显卡并行、互不等待;
3.硬盘层:约29GB 的查找表留在SSD,运行时只读取少量行、主要由系统缓存承接——模型常驻后,77组基准请求在推理过程中的硬盘权重读取量统计为0 MB。
实测效果:常规请求显存命中率95%–98%;10万字长文首读场景命中率84.8%,未命中部分经由内存消化,仍未触发硬盘读取。
四、实测推理性能
1.短对话生成:145.7tokens/秒(三次实测中位数,区间142.2–146.1),约合每秒183 个汉字;
2.长文本预填充:33,103tokens 载入11.5 秒;128,353tokens 载入44.6 秒;
3.中文超长文档:100,823字(实测79,803 tokens)29.7秒完成全文读取并给出首个回答;
4.二次问答:全文载入后追问1–4 秒响应。
五、模型能力验证
1. 长文本检索(大海捞针,英文合成语料):3.2万 /6.4 万 /12.8 万 tokens三档长度x 三种插入深度,9组全部命中。
2. 中文长文档问答与幻觉抑制:针对那份10 万字文档发起6组细节提问,输出与原文一致;其中一组故意询问文档中不存在的信息,模型回复“文档中未提及”,未编造内容。答对不难,难的是不知道的时候说不知道。
3. 五项真实业务任务(每项一次执行完成),结果如下:
任务 | 结果 |
商品文案改写 | 五项关键参数全部准确保留,无绝对化违规表述 |
多区域销售核算 | 五小问全对,含“砍掉一个区域需同步更换基期”的陷阱题 |
采购公告信息抽取 | 13 个字段完整,预算 12×4.2=50.4 万元计算正确 |
代码生成 | 本地运行 7 条边界用例,全部通过 |
多轮逻辑推理 | 指代识别准确,并主动指出差价中包含硬盘升级 |
这三项测的是模型能力,但对用户而言,它就是这台未来人类X98的交付能力:合同、代码、长报告不出本机,也能拿到可用结果。
六、供电散热与持续负载:十分钟之后见真章
330W 电源适配器、98Wh电池,GPU功耗上限175W。未来人类X98对散热的设计思路是四要素——6CM扇叶尺寸、5500高转速、导热硅脂、双12V/7.8W电机功率。
硬件说了不算,看实测。连续30 分钟、56轮串行满载:首段平均134.5 tokens/秒,末段平均133.2 tokens/秒,下降0.93%,全程无推理中断、无程序崩溃。
运行状态同样平稳:约第10 分钟进入75–80℃ 平台区间、峰值80℃ 后不再攀升;功耗稳定在166–168W(贴着175W 上限跑,瞬时峰值173.4W);核心频率全程约2,270MHz,未出现过热降频。
笔记本跑推理的短板从来不是第一秒的性能,是十分钟之后的性能。
七、硬件版本的能力边界
本次未来人类X98测试的IQ2_XS是兼顾速度与体积的量化档位,并不是这个模型的精度上限。
若需要接近4-bit 的更高精度权重,按引擎官方规则需要96GB 及以上内存才能让全部权重常驻内存——对应128GB 内存版本。
64GB 版本的定位同样清楚:它买到的是“数据留在本机、无按次计费、125B随时可用”这三件事,而不是最高精度。对合同、源代码、客户资料不便外送的岗位来说,这三件事往往就是需求的核心;要模型能力的上限,该看的是更高配版本。
八、数据不出门,随时可问
适合需要把文档和数据留在本机的人——法务看合同、财务核数据、医疗和研发处理不便外流的资料;需要反复读长材料的人——一份十万字的东西读一次,之后随问随答;以及想在本地跑代码助手、又不想按token 计费的开发者。这几类人的共同点很明确:他们要的不是模型能力的天花板,是“随时能问、数据不出门”。
测试方法与口径
测试机:TERRANSFORCE X98|IntelCore Ultra 9 290HX Plus(24核24线程)|NVIDIARTX 5090 Laptop 24GB(24,463MiB)
|64GBDDR5 2x32GB;四插槽可扩展至192GB|1TBM.2 NVMe(PCIe4.0)
|显卡链路PCIeGen5 x16(负载下引擎实测,空闲节能降至Gen1)|驱动592.02|Windows11 build 26200
|电源模式:最佳性能|GPU功耗上限175W
软件:Strata引擎0.1.41(MIT开源)|模型Qwen3.8-Flash-Next(千问团队开源)|IQ2_XS量化档(ISTA-DASLab)
|上下文131,072|KVint8(常驻32,768)|专家缓存11,837槽位/16,244 MiB|锁页专家池33,812MiB
|CPU工作线程23|开启图片输入
环境:使用本机127.0.0.1环回
方法:prompt带唯一nonce,确保零缓存复用;temperature0、思考模式关闭;每档3次取中位数;
持续负载为56轮串行满载(合计30分钟);77组基准请求reused均为0、推理过程硬盘权重读取均为0
口径:生成tok/s= engine_generated ÷ decode_ms;预填充tok/s=(prompt_tokens? reused)÷prompt_ms;
中文按实测约1.26字符/token换算;token数均为引擎实测值;needle与基线填充语料为英文合成文本
未来人类X98|125B本地部署实测,跑通只是开始
未来人类X98实测:一份 100,823 字的中文文档,29.7 秒读完;读完之后随便挑一处细节问,1 到 4 秒给出答案。过去谈本地大模型,话题总停在“能不能跑起来”。这次我们想问的是另一个问题:跑起来之后,好不好用,能不能一直用。
答案是这组数:短对话生成中位 145.7 tokens/秒(约每秒 183个汉字),连续 30 分钟满载性能下降 0.93%,模型常驻内存后,整个推理过程没有读一次硬盘。
一、移动终端本地大模型的现实阻碍
专业用户选择本地推理,核心诉求集中在数据安全与使用成本,但落地时通常卡在两处。
一是显存资源。以常见的 4-bit 量化为例,125B 级模型的权重体积约60-70G,多数笔记本独显难以完整承载;二是云端服务的固有局限。云端调用需要把业务文档、代码、客户资料上传至服务商服务器,存在数据流转与合规压力,同时按 token 计费、高峰排队。
二、四条通道一起决定速度
处理器——Intel Core Ultra 9 290HX Plus,24 核 24 线程,睿频 5.5GHz。在本地推理里它不是配角:显存没命中的专家,由 CPU 直接在内存里计算,实测引擎在本机启用了 23 个工作线程同时开工。
显卡——NVIDIA RTX 5090 Laptop,24GB GDDR7,Blackwell 架构、第 5 代 Tensor Core 1824 AI TOPS。它负责常驻最常用的那批专家,实测装下 11,837 个,占模型 24,576 个专家的四成半。
内存——64GBDDR5 双通道2×32GB,四个插槽最高可扩展至 192GB。内存决定这台机器能加载哪一档量化模型,这是它和大显存台式机最实在的差距所在。
显卡链路——处理器与显卡之间实测 PCIe Gen5 ×16(空闲时节能降至 Gen1)。专家从内存换进显存,走的就是这条路。
跑大模型从来不是显卡一个人的事,这四条通道一起决定它有多快、能装多大。
三、24GB 显存装不下 125B,未来人类X98怎么接住
未来人类X98本次测试的模型Qwen3.8-Flash-Next 是 MoE(混合专家)架构,共 48 层、每层 512 个专家,合计 24,576 个专家模块;IQ2_XS 档的专家权重约 35.5GB,模型文件合计约 70GB——显存装不下全部专家,内存也装不下整个模型文件。Strata 引擎的做法是按热度分层,把不同部分放到不同介质上:
1. 显存层:常驻高频访问的 11,837 个热专家(约占总量 48%),并随对话内容自适应换入换出;
2. 内存层:以锁页方式承载其余全部专家权重(实测锁页池 33,812MiB,约 33GB),未命中的专家由处理器就地计算,与显卡并行、互不等待;
3. 硬盘层:约 29GB 的查找表留在 SSD,运行时只读取少量行、主要由系统缓存承接——模型常驻后,77 组基准请求在推理过程中的硬盘权重读取量统计为 0 MB。
实测效果:常规请求显存命中率 95%–98%;10 万字长文首读场景命中率 84.8%,未命中部分经由内存消化,仍未触发硬盘读取。
四、实测推理性能
1. 短对话生成:145.7 tokens/秒(三次实测中位数,区间142.2–146.1),约合每秒 183 个汉字;
2. 长文本预填充:33,103 tokens 载入 11.5 秒;128,353 tokens 载入 44.6 秒;
3. 中文超长文档:100,823 字(实测 79,803tokens)29.7 秒完成全文读取并给出首个回答;
4. 二次问答:全文载入后追问 1–4 秒响应。
五、模型能力验证
1. 长文本检索(大海捞针,英文合成语料):3.2 万 / 6.4 万 / 12.8 万 tokens 三档长度 × 三种插入深度,9 组全部命中。
2. 中文长文档问答与幻觉抑制:针对那份 10 万字文档发起 6 组细节提问,输出与原文一致;其中一组故意询问文档中不存在的信息,模型回复“文档中未提及”,未编造内容。答对不难,难的是不知道的时候说不知道。
3. 五项真实业务任务(每项一次执行完成),结果如下:
任务 | 结果 |
商品文案改写 | 五项关键参数全部准确保留,无绝对化违规表述 |
多区域销售核算 | 五小问全对,含“砍掉一个区域需同步更换基期”的陷阱题 |
采购公告信息抽取 | 13 个字段完整,预算 12×4.2=50.4 万元计算正确 |
代码生成 | 本地运行 7 条边界用例,全部通过 |
多轮逻辑推理 | 指代识别准确,并主动指出差价中包含硬盘升级 |
这三项测的是模型能力,但对用户而言,它就是这台未来人类X98的交付能力:合同、代码、长报告不出本机,也能拿到可用结果。
六、供电散热与持续负载:十分钟之后见真章
330W 电源适配器、98Wh 电池,GPU 功耗上限 175W。未来人类X98对散热的设计思路是四要素——6CM扇叶尺寸、5500高转速、导热硅脂、双12V/7.8W电机功率。
硬件说了不算,看实测。连续 30 分钟、56 轮串行满载:首段平均 134.5tokens/秒,末段平均 133.2 tokens/秒,下降 0.93%,全程无推理中断、无程序崩溃。
运行状态同样平稳:约第 10 分钟进入 75–80℃ 平台区间、峰值 80℃ 后不再攀升;功耗稳定在 166–168W(贴着 175W 上限跑,瞬时峰值 173.4W);核心频率全程约 2,270MHz,未出现过热降频。
笔记本跑推理的短板从来不是第一秒的性能,是十分钟之后的性能。
七、硬件版本的能力边界
本次未来人类X98测试的IQ2_XS 是兼顾速度与体积的量化档位,并不是这个模型的精度上限。
若需要接近 4-bit 的更高精度权重,按引擎官方规则需要 96GB 及以上内存才能让全部权重常驻内存——对应 128GB 内存版本。
64GB 版本的定位同样清楚:它买到的是“数据留在本机、无按次计费、125B 随时可用”这三件事,而不是最高精度。对合同、源代码、客户资料不便外送的岗位来说,这三件事往往就是需求的核心;要模型能力的上限,该看的是更高配版本。
八、数据不出门,随时可问
适合需要把文档和数据留在本机的人——法务看合同、财务核数据、医疗和研发处理不便外流的资料;需要反复读长材料的人——一份十万字的东西读一次,之后随问随答;以及想在本地跑代码助手、又不想按 token 计费的开发者。这几类人的共同点很明确:他们要的不是模型能力的天花板,是“随时能问、数据不出门”。
测试方法与口径
测试机:TERRANS FORCE X98|IntelCore Ultra 9 290HX Plus(24核24线程)|NVIDIARTX 5090 Laptop 24GB(24,463 MiB)
|64GB DDR5 2×32GB;四插槽可扩展至192GB|1TB M.2 NVMe(PCIe 4.0)
|显卡链路 PCIe Gen5 ×16(负载下引擎实测,空闲节能降至Gen1)|驱动592.02|Windows11 build 26200
|电源模式:最佳性能|GPU 功耗上限175 W
软件:Strata 引擎 0.1.41(MIT开源)|模型Qwen3.8-Flash-Next(千问团队开源)|IQ2_XS 量化档(ISTA-DASLab)
|上下文 131,072|KV int8(常驻 32,768)|专家缓存 11,837 槽位 / 16,244 MiB|锁页专家池 33,812 MiB
|CPU 工作线程 23|开启图片输入
环境:使用本机 127.0.0.1 环回
方法:prompt 带唯一 nonce,确保零缓存复用;temperature 0、思考模式关闭;每档 3 次取中位数;
持续负载为 56 轮串行满载(合计 30 分钟);77 组基准请求 reused 均为 0、推理过程硬盘权重读取均为 0
口径:生成 tok/s = engine_generated ÷ decode_ms;预填充tok/s =(prompt_tokens? reused)÷prompt_ms;
中文按实测约 1.26 字符/token 换算;token 数均为引擎实测值;needle 与基线填充语料为英文合成文本



 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论