【ZOL中关村在线原创评测】对于PC行业而言,Windows on ARM笔记本电脑一直以来都不算成功,无论是早期微软自己推出的Surface RT二合一平板电脑,还是高通后续的两次入局尝试,毫不客气地说,它们目前都是以失败告终。即便骁龙X Elite有所起色,但其在体验方面存在的问题却难以让Windows on ARM笔记本电脑获得如x86+Windows亦或是ARM+macOS那样的成功。
但是,NVIDIA RTX Spark的出现,彻底改变了Windows on ARM的尴尬地位,用现在流行的一句网络梗形容就是:“这里,已经变了!”
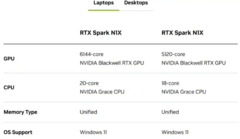
NVIDIA RTX Spark N1X 超级芯片,作为全新的Windows on ARM算力底座,着实为基于其打造的笔记本电脑带来了远超以往Windows on ARM笔记本电脑的体验,最高20核心CPU+6144个CUDA核心GPU,以及128GB LPDDR5x 9400MT/s超大统一内存的豪华配置,加上NVIDIA与微软的深度合作,使得Windows on ARM在RTX Spark N1X上的表现远超预期,10月16日一开售,就有多个品牌的 RTX Spark产品售罄。
RTX Spark N1X平台首发产品包含了来自华硕ProArt、戴尔XPS、惠普OMNIBOOK、联想YOGA Pro、微星尊爵以及微软Laptop Ultra六大品牌的明星产品线,这与当初高通骁龙初次入局时寥寥无几的厂商拿出自家“边角料”模具的惨淡情景相比可谓是大相径庭,足见各家对NVIDIA RTX Spark的重视。
这次关于RTX Spark的首发评测,笔者将会借助联想YOGA Pro 15 RTX Spark来为大家呈现,相信以联想天花板级别的性能调校,一定会将RTX Spark N1X的尖端性能展现的淋漓尽致。这款128GB统一内存版本的售价是42999元。
·测试平台硬件配置
而在性能测试之前,我们先来看看联想 YOGA Pro 15 RTX Spark的配置以及RTX Spark平台的技术特性。
YOGA Pro系列承载了联想高端产品的意志,精工细作、调校出色,素来有着绝佳的品质。联想拿出这套模具给到RTX Spark做首发,足以看出其诚意。
作为旗舰级轻薄本,联想 YOGA Pro 15 RTX Spark搭载的NVIDIA RTX Spark N1X处理器,由20个Grace CPU核心打造,涵盖10个Cortex-X925大核和10个Cortex-A725能效核。GPU则采用了48组SM执行单元,每组包含128个CUDA核心,总计6144个CUDA核心。同时它搭载了128GB LPDDR5X 9400MT/s超大高速统一内存,最高配置2TB PCIe 5.0固态硬盘。
当然,对于预算较少的用户来说,联想 YOGA Pro 15 RTX Spark还提供了64GB LPDDR5X统一内存版本的机型。
其实最近几年大家对于超大统一内存并不陌生,AMD锐龙AI Max+已经在这一领域深耕近两年,这次RTX Spark算是打破了AMD一家独大的场面。
·RTX Spark平台技术特性解析
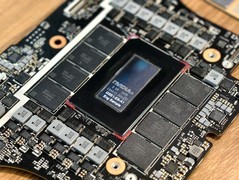
NVIDIA在今年六月份台北电脑展GTC大会上首秀了RTX Spark芯片,它是一颗面向笔记本电脑和紧凑型桌面系统的处理器。基础规格前面我们也提到了,它由10颗X925超大核+10颗A725中等规模核心构成的CPU,以及硬件规格接近桌面级RTX 5070的Blackwell架构GPU组成,并且由TSMC 3nm制程工艺打造。
翻开架构图可以看到,这颗芯片由S-Die和G-Die组成,S-Die集成了CPU、NPU、I/O、内存控制器,与G-Die的Blackwell GPU通过NVLink C2C连接。其中X925超大核搭载了2MB L2缓存,最大频率为4GHz,而A725中核,也就是能效核搭载了512KB L2缓存,最大频率为2.8GHz,整个核心又分为两组集群,二者均为5+5核心结构,不过其中一组共享16MB L3,另外一组共享8MB L3,总计24MB L3缓存。
另外除了CPU的L3缓存之外,片上还集成有16MB的SLC缓存。
RTX Spark N1X的GPU Tile是大家非常熟悉的Blackwell架构打造,它由48组SM执行单元构成,规模上类似50组SM的GB205核心,与桌面级RTX 5070的48组SM和6144 CUDA核心一样,不过因为它的内存带宽只有300GB/s,再加上编解码器也集成在了GPU Tile上,所以GPU Tile上集成的专用的24MB L2缓存可能是没有太多性能冗余的,因此实际性能表现自然是比不上桌面级RTX 5070。不过相比移动级的RTX 5070Ti的46组SM,RTX Spark N1X这颗GPU的整体规模要更大一些,最终图形性能表现肯定是相当值得信赖的了。
另外在G-Die上除了CUDA之外,还包含了第四代RT Core、第五代Tensor Core,第六代NVDEC解码器和第九代NVENC编码器。
作为主打AI能力的PC芯片,RTX Spark N1X最为亮眼的还是统一内存。与苹果M5 Max、锐龙AI Max+ 395一样,它的最大内存支持到128GB,并且可以最高分配96GB做独占显存,内存规格为LPDDR5x-9400MT/s,位宽256bit,带宽300GB/s。从规格、位宽以及带宽三个层面来看,它比M5 Max的LPDDR5x-9600MT/s、512bit、612GB/s规格要低不少,但是比锐龙AI Max+ 395的LPDDR5x-8000MT/s、256bit、256GB/s规格要更高一些。
不过Spark N1X在AI方面的能力还不止于此。它拥有高达1PFLOPS的算力支持,同时Tensor Core、CUDA、TensorRT等也为其在智能体AI、AI推理应用方面奠定了强有力的性能基础。
在应用层面,相比此前NVIDIA自家的基于Linux的DGX Spark来说,RTX Spark受益于Windows on ARM生态,除了在AI应用方面可以惠及到大众用户之外,自然还会有不错的游戏、娱乐、生产力性能。尤其是相对于以往高通骁龙的Windows on ARM系统来说,NVIDIA还有CUDA、TensorRT、光线追踪、DLSS5、G-Sync等等各方面的加速或优化技术做支持,再加上与微软之间的紧密合作以及全球范围内各大ISV为其做适配,RTX Spark的Windows on ARM与以往的Windows on ARM可能就完全不是同一个概念了。
除了满血版的20核CPU之外,RTX Spark还有一颗18核心CPU+5120 CUDA核心GPU的低一档型号,最终产品价格肯定是要比满血版便宜一些了。
产品端,NVIDIA也对OEM厂商提出了一些硬性要求,比如必须采用符合G-SYNC标准、覆盖100% P3色域、峰值亮度不低于1000nits、刷新率不低于120Hz的高素质屏幕。同时对于外观设计、接口规格、电池容量、续航能力等等方面都有非常高的标准,因此造就了旗舰配置机型普遍超过40000元的超高定价。另外在产品形态方面,目前除了笔记本之外还包含有迷你主机,这也是近年来AI PC的主流形态之一了。
·CPU理论性能评估
基础特性了解之后,我们看性能测试。本次测试我们在联想YOGA Pro 15 RTX Spark的联想电脑管家中,将性能模式调整到最大化的“创作模式”,以获取RTX Spark N1X平台的最佳性能表现,下面来看看测试结果。
CPU单核和多核性能评估,我们依旧使用大家熟悉的CINEBENCH。这里需要说明的一点是,CINEBENCH R23没有原生ARM 64版本,因此可以通过它来大概判断Prism转译情况下,RTX Spark N1X的性能损耗状况。而CINEBENCH 2024和2026则是提供了原生ARM 64版本,这自然能够衡量出它的真实性能表现。
在CINEBENCH 2024测试标准下,RTX Spark N1X单核得分132,多核得分1727,相对苹果M5 Max的单核205以及多核2078分来说要低,相对酷睿Ultra X9 388H以及锐龙AI Max+ 395来说,双方的单核和多核性能表现相差并不算太大。
CINEBENCH 2026测试标准,RTX Spark N1X单核得分556,多核得分7217,多核的整体性能表现比酷睿和锐龙都要好不少,与M5 Max基本持平,单核则依旧不低M5 Max。
所以总体来说,RTX Spark N1X在原生ARM 64版本软件测试中,单核和多核性能基本处于当前顶尖处理器的序列,作为NVIDIA推出的首款PC SoC芯片,它的CPU部分的表现笔者个人觉得还是能够达到预期的。
不过在非ARM 64原生的CINEBENCH R23测试中,RTX Spark N1X的性能就会受到比较大的影响,单核得分1305,多核得分17855分,对照CINEBENCH 2024和2026的测试结果来看,Prism转译对RTX Spark N1X的影响还是比较明显的。
另外笔者还测试了CINEBENCH 2026的离电性能,单核为550分,多核为6991分,相对于插电性能来说,分别只下降了1%和4%,可见RTX Spark N1X不插电性能基本上是没有什么损耗的。
·CPU应用性能评估
实际应用性能方面,这里我们依旧使用7-Zip、X264/X265 Benchmark、Corona 10 Benchmark以及V-Ray Benchmark进行压缩/解压缩、视频编码以及渲染方面的测试。
7-ZIP这款软件是有原生ARM 64版本的,实测其压缩速度达到了143382 KB/s,解压缩速度达到了1603104 KB/s,总评分高达153.171GIPS。这个成绩整体来说要超过酷睿Ultra X9 388H的表现,而对比锐龙AI Max+ 395来说,压缩性能高于锐龙,解压缩性能不及锐龙。
视频编码测试,x264 Benchmark编码2500帧耗时33秒,平均帧速率为74.45fps,而x265 Benchmark编码1128帧耗时33.33秒,平均帧速率为33.58fps。这一方面RTX Spark N1X的表现比酷睿Ultra X9 388H要低一些,与锐龙AI Max+ 395基本持平。另外考虑到x264 Benchmark和x265 Benchmark都不是原生ARM 64软件,所以这一成绩只做参考即可,最终的表现根据大家实际使用的视频剪辑软件的不同,肯定是会有比较明显的差异的。
渲染方面,首先来看Corona 10 Benchmark的测试,RTX Spark N1X光线渲染速度可达5750262 rays/s,这项应用测试RTX Spark N1X要比酷睿和锐龙都低不少,主要原因也是因为软件没有原生ARM 64版本。所以其实Prism转译对于RTX Spark N1X的性能影响还是比较显著的,但在实际应用中,RTX Spark N1X平台相对以往的高通骁龙平台来说,是有着云泥之别的。
最后一项渲染测试是V-Ray Benchmark,RTX Spark N1X一分钟采样率为19064 vsamples,对比酷睿和锐龙的22000和29000 vsamples是要低不少的。
当然因为x86和ARM 64本身存在架构层面的差异,且非原生ARM 64软件跑在Windows on ARM上确实性能损耗比较明显,因此除了CINEBENCH 2024/2026、7-Zip这些原生ARM 64版本软件结果可以作为标准测试数据之外,其它测试结果均为参考值,实际应用请以最终体验为准。
·GPU理论性能评估
接下来再来看看这颗6144 CUDA核心GPU的性能表现。理论性能我们还是参照3DMark测试标准,这款软件有专门针对ARM平台的测试项目,包括Speed Way、Steel Nomad(Light)、Port Royal以及Solar Bay(Extreme),x86平台常用的Time Spy、Fire Strike并没有ARM的测试版本,所以这里就不进行测试了。
以下是RTX Spark N1X GPU的具体测试结果,如果以x86和ARM平台都通用的Steel Nomad Light测试结果做参考的话,RTX Spark N1X的这颗GPU性能要比Radeon 8060S性能高出约65%,是目前Windows平台性能最强的一颗集成型GPU,不过对于NVIDIA来说,这并不意外。
·GPU应用性能评估
GPU应用性能方面,我们主要参考V-Ray Benchmark的测试,这里我们使用CLI模式,这颗GPU的RTX vpaths测试结果为2917,CUDA vpaths测试结果为2442,表现不错,在GPU渲染方面,CUDA的加速能力确实是独一档。
另外笔者还进行了D5渲染器测试,主要包含了利用GPU去做工程图和工程视频文件的渲染导出,这项应用的主要工作负载基本都在GPU侧,所以能够反映出GPU在工程渲染应用上的真实表现。
首先来看图片渲染,原生默认尺寸为1840×1420,RTX Spark N1X的GPU完成渲染耗时仅为1分02秒,表现优异。
接下来是1080p分辨率、mp4格式的工程视频渲染,总耗时为3分36秒,对于集成型GPU来说,这个成绩是目前所有Windows平台中表现最为出色的。
·游戏性能评估
得益于足够大的核心规模,RTX Spark N1X在游戏方面的表现其实是非常让人期待的。不过在实际测试中我们发现,某些老游戏会出现不认显存的报错提示,比如《荒野大镖客2》,当然目前并不确定这是不是普遍情况,只是我手上这台机器遇到了这样的问题。
首先来看《CS2》,笔者分别测试了2560×1600和1920×1200分辨率,高画质下平均帧率分别为172fps和299.9fps,1% LOW帧分别为53.6fps和121.6fps。
《漫威争锋》这款游戏笔者使用了ARM64EC Beta版本进行测试,2560×1600分辨率,最高画质,考虑到这是一款电竞游戏,所以只开了2倍多帧生成,最终游戏平均帧率可以达到86fps,1% LOW帧平均为36fps。
再来看一款国产二游《明日方舟:终末地》,这款游戏对于集成显卡性能来说有着不小的挑战,2560×1600分辨率,最高画质,4倍多帧生成设定下,跑图时游戏帧率基本能到110fps以上,1% LOW帧比较低在30fps上下波动;而进入战斗后帧率可以提升到160fps以上,但是通过下面第二张GIF图采集的图像来看,帧率波动还是比较大的,从119fps跨越到了218fps。
《古墓丽影:暗影》2560×1600分辨率、最高画质,DLSS平衡模式,平均帧率94fps。
《赛博朋克2077》2560×1600分辨率,超级光追+4倍多帧生成,平均帧率111.53fps。
《黑神话:悟空》2560×1600分辨率,超高画质+全景光追高,4倍多帧生成可以达到52fps,这个优势相对酷睿和锐龙而言还是相当明显的。
另外笔者还测试了近期的两款新游,比如《鬼武者:剑之道》,2560×1600分辨率,最高画质,2倍多帧生成的设定下平均可以达到90fps以上的流畅度。
《控制:共振》这款游戏对硬件要求极高,2560×1600分辨率,最高画质,6倍多帧生成后可以达到135fps左右的流畅度。不过6倍多帧生成的手感不是很好,人物转身、动作的延迟感比较明显,调至4倍多帧生成是比较平衡的选择。
虽然绝大部分的游戏都比以往Windows on ARM生态要好很多,但依旧有一些不兼容的情况存在,比如Steam版本的《三角洲行动》会因安全系统不支持而无法进入;再比如《F1 2026》这款游戏完全不支持ARM处理器。不过以NVIDIA的号召力来说,对于推动Windows on ARM生态的发展和完善来说就只是时间问题了。
·内存和硬盘存储性能评测
存储性能方面,RTX Spark N1X在内存读写速度、延迟方面的表现远远优于酷睿和锐龙平台,AIDA 64内存读速测试结果为122.78 GB/s,内存写入速度为220.35 GB/s,内存拷贝速度为143.06 GB/s,而延迟只有15.1ns,表现非常出色。
YOGA Pro 15 RTX Spark配置了一块2TB PCIe 5.0固态硬盘,CrystalDiskMark实测顺序读取速度为11158.03 MB/s,顺序写入速度为10496.76 MB/s;4K随机读取速度为44.67 MB/s,4K随机写入速度为90.3 MB/s,顺序读写速度表现出色,4K随机读写速度一般。
·综合性能与生产力性能评估
综合性能我们参考PassMark的测试结果,总评分为10450.1分,超越了当前市面83%的设备,对于一款Windows on ARM,且采用集成显卡的设备来说,这个成绩已经是非常不错的表现了。单项测试中,CPU得分31418.6,2D图形性能评分821.9,这一项比较低,3D图形性能评分16134.6,内存评分2704.2,硬盘评分65720.5,存储方面的表现确实非常不错。
接下来是PCMark 10和UL Procyon的Office办公生产力测试,PCMark 10标准下,RTX Spark N1X平台总分11198,UL Procyon测试标准总分231000,整体生产力效率出色。笔者实际体验了一下Office的Excel和PowerPoint应用,整体非常流畅,交互动画无迟滞和卡顿,正常办公使用是完全没有任何问题的。
·AI性能评估
本地AI,是RTX Spark N1X最为重要的应用方向。128GB超大统一内存正是为此而生。在NVIDIA APP或联想YOGA Pro 15 RTX Spark的BIOS中,用户可以直接调整可变显存的大小,最高可以分配96GB容量,直接拖动下图中的滑块即可完成对应容量的分配。
笔者测试时均采用最高的96GB可变显存。首先来看看UL Procyon AI文字生成测试,这里包含了PHI 3.5、MISTRAL 7B、Llama 3.1以及Llama 2四款大语言模型,可以看到,RTX Spark N1X平台跑这些大模型的推理任务完全没啥压力,生成速度分别为74.09 tokens/s,53.26 tokens/s,50.15 tokens/s以及27.76 tokens/s,全面优于同为128GB超大统一内存,96GB可变显存的锐龙AI Max+ 395平台。
AI计算视觉方面,RTX Spark N1X同样是Windows平台里的独一档表现,CONVNEXT现代化卷积神经网络架构?吞吐量达到1801.55 图像/秒;BLIP视觉语言预训练模型解码器推理速度达到395.088 能力/秒,推理速度381.612 能力/秒;SAM 2.1开源图像和视频分割中的实时视频处理方面,解码器推理速度高达797.972 能力/秒,编码器推理速度高达56.623 能力/秒;DETR端到端目标检测框架?推理速度达到215.212 能力/秒;ESRGAN增强型超分辨率生成对抗网络(用于图像修复),推理速度15.596 能力/秒。
从测试结果来看,RTX Spark N1X在各类主流图像、视频方面的计算机视觉性能方面表现极佳
Stable Diffusion 1.5 AI图片生成测试中,RTX Spark N1X平台总评分达到了1459分,512×512分辨率,4批次,16张图像生成耗时68.495秒,图像生成速度每张4.281秒,而且模型精度为FP16。从UL Procyon的AI图文生成以及AI计算机视觉测试可以看到,RTX Spark N1X在AI应用方面的能力确实是独一档。
接下来看看实际应用方面的表现,首先来看ComfyUI的性能测试,具体方法就不在这里赘述了,从下图可以看到,利用ComfyUI去做图像生成的话,GPU和内存负载是非常高的,非超大统一内存的机器做起来不仅耗时,而且还会有各种问题。
以Flux2.Klein_4b_BF16、Flux2.Klein_4b_FP8以及RTX Spark原生支持的NVFP4精度的Flux2.Klein_4b为例,生成5次图片的平均运行时长分别为25.741秒,18.489秒以及15.489秒。
NVFP4可以说是Blackwell GPU第五代Tensor Core的专属优势,对于图像生成速度方面的加持也是肉眼可见的快,这一点对RTX Spark N1X本地AI能力的加强有着非常显著的作用。
对于国内的大众用户来说,相信不少朋友已经把Work Buddy融入了自己的日常工作流当中。随着RTX Spark N1X的落地,Work Buddy也是进行了第一时间的适配,并且可以实现本地模型的零成本使用。用户可以打开设置菜单后点选“模型”选项,然后下载本地大模型,推理引擎为CUDA-13,自动下载好之后就可以在本地模型上用Work Buddy干活了,相对来说更加省钱。
回到对话框,下拉列表就可以切换到刚下好的本地模型。
此时给WorkBuddy发布任务之后,从任务管理器中可以看到GPU的负载直接被拉满。这里我让本地模型帮我做一个144页PPT,约14.5万字的RTX Spark技术文档归纳总结,整体的完成速度还是非常快的,大概在3分钟之内就完成了文档的解析与归纳,而且答案准确,没有明显纰漏。
·电池续航能力评估
最后我们来聊聊续航。这款联想YOGA Pro 15 RTX Spark提供了92.5Wh高密度电池和140W氮化镓电源适配器,15分钟快充可以换回3小时续航的能力。因为续航时间受影响的因素比较多,所以这部分测试结果只做参考,实际续航时间根据实际应用方式不同、使用环境不同等等会有明显差异。
测试环境我们按照惯例依旧是设定在系统能效模式、联想笔记本支持的节能模式上,屏幕亮度调整到50%,音量30%,全程开启Wi-Fi和蓝牙,屏幕刷新率调整到60Hz,关闭键盘背光。
首先在UL Procyon的1小时Office连续办公掉电测试中,YOGA Pro 15 RTX Spark掉电量为10%,略微弱于酷睿Ultra平台的表现。
其次在PCMark 10的Office应用续航测试中,YOGA Pro 15 RTX Spark结果为10小时45分钟,表现中规中矩。
·延续x86版外观设计
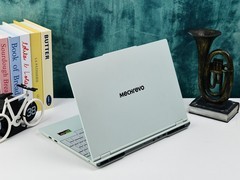
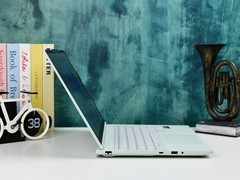
回归到联想YOGA Pro 15 RTX Spark产品本身,可以看到这款产品采用了与x86版机型一样的模具设计,全铝合金机身,简约干练的设计风格,利落的机身线条,A面正中镶嵌的Lenovo LOGO以及顶部凸起的摄像头模组,都是这款旗舰级轻薄本的设计语言。
单手掀开顶盖,这块15.3英寸2.5K分辨率、165Hz(支持48-165Hz VRR可变)刷新率,三边超窄边框、PureSight Pro OLED触控镜面屏跃然呈现在眼前。其HDR峰值亮度达到1100nits,支持100% DCI-P3色域和100% sRGB色域覆盖,支持杜比视界,通过了VESA DisplayHDR True Black 1000认证,PANTONE及PANTONE SkinTone双重色彩认证,以及Eyesafe 2.0和TÜV无频闪双重护眼认证,屏幕素质绝佳。实测其平均色准ΔE<0.5,加上可做数位手绘板的超大触控板,完全可以为视觉创作者带来堪比专业级显示器的色彩体验。
而放到日常应用中,这块屏幕的素质显然是超模般的存在。
再看整个C面。联想YOGA Pro 15 RTX Spark采用了巧克力键盘,1.5mm键程、0.3mm弧度的键帽以及鲜明利落的回弹反馈,共同塑造了优秀的输入体验。不过受限于机身空间,以及键盘两侧区域让给了大面积的扬声单元,联想YOGA Pro 15 RTX Spark并未配备独立数字键区,且方向键上下键为半高设计,这可能会给有相应需求的办公用户带来一些不便。
联想YOGA Pro 15 RTX Spark的超大面积Haptic Force Pad压感触控板颇为独特,除了可以配合触控屏完全替代鼠标去操控电脑之外,还可以配合随机附赠的高压感触控笔实现数位板功能,专业画师完全无需再去额外搭配数位板来进行绘画创作。
此外,其在A面摄像头模组下方与Lenovo LOGO之间的位置设计了磁吸式触控笔收纳区域,而且磁力吸附紧密,一般情况下不用担心掉落。
虽然ARM架构芯片天生具有不错的能效表现,但是联想YOGA Pro 15 RTX Spark依旧在底部设计了大面积的进风口,以确保更好的散热效率和稳定的长效性能输出。同时可以看到,进风口尾部的橡胶脚垫贯穿并覆盖了整个进风口区域,这使得机身尾部散出的热风不会被吸回到进风口中。另外,机身底部靠近前端的区域隐藏有扬声器开孔,配合键盘左右两侧的大面积扬声单元,整机4低音2高音的4扬声器音响系统,可以完美呈现出震撼的杜比全景声效果。
从侧面看过去,联想YOGA Pro 15 RTX Spark保持了较为纤薄的机身设计,整机厚度16.7mm,重量1.75kg,在当下不算特别轻,但整体的携带体验可以满足日常通勤以及出差等高频移动场景的需求。
接口配置上,联想YOGA Pro 15 RTX Spark确保了整体的扩展体验,总计提供2个USB4 Type-C和2个USB-A(10Gbps)数据传输口,视频端口主要是HDMI 2.1,同时还配置了标准的SD读卡器,3.5mm耳麦插孔,另外还配置了电源键与摄像头物理开关键。
·评测总结
测试完联想YOGA Pro 15 RTX Spark,并深度体验一段时间之后,给我最为直接的感觉就是,这次用户在日常使用的时候,终于不用再关注自己手上是一台兼容性堪忧、交互体验迟滞或卡顿的Windows on ARM设备了。毫不夸张的说,RTX Spark N1X彻底改变了Windows on ARM以往非常糟糕的印象,让这类设备真正变成高效率的生产力工具、可靠的游戏平台以及卓越的本地AI载体。这些改变使得RTX Spark N1X自身的CPU、GPU性能反倒显得不那么重要了,毕竟多年来,Windows on ARM最核心的槽点就是“它不像是一台能正常用的设备”。
总体来看,RTX Spark N1X作为NVIDIA第一代PC SoC芯片是非常成功的,而这种成功在当下的半导体芯片行业里其实并不常见,不少新架构、新理念的第一代芯片的表现都非常糟糕,而RTX Spark N1X则远超预期。因为它无论是在基础的CPU、GPU、内存性能层面,还是在AI、办公、游戏等实际应用层面,都能够给到终端用户非常不错的体验,这对于Windows on ARM生态来说是头一次。
不过在测试过程中,我们也依旧看到了一些兼容性方面的问题,这主要出现在游戏层面。另外如果你同时打开很多软件的话,相对x86 Windows设备来说,还是能明确感受到交互上的一些延迟。但即便存在这些问题,依旧不影响RTX Spark N1X是极为成功的一颗“首发芯片”,而且我们相信以NVIDIA的影响力,现在遇到的很多问题将不再像以往那样无从解决,Windows on ARM的生态发展、兼容性改善以及应用生态的壮大,必然会在RTX Spark N1X的推动下步入快车道。
NVIDIA在今年六月份台北电脑展GTC大会上首秀了RTX Spark芯片,它是一颗面向笔记本电脑和紧凑型桌面系统的处理器。基础规格前面我们也提到了,它由10颗X925超大核+10颗A725中等规模核心构成的CPU,以及硬件规格接近桌面级RTX 5070的Blackwell架构GPU组成,并且由TSMC N3E制程工艺打造。
翻开架构图可以看到,这颗芯片由S-Die和G-Die组成,S-Die集成了CPU、NPU、I/O、内存控制器,与G-Die的Blackwell GPU通过NVLink接口C2C连接。其中X925超大核搭载了2MB L2缓存,最大频率为4GHz,而A725中核,也就是能效核搭载了512KB L2缓存,最大频率为2.8GHz,整个核心又分为两组集群,二者均为5+5核心结构,不过其中一组共享16MB L3,另外一组共享8MB L3,总计24MB L3缓存。
另外除了CPU的L3缓存之外,片上还集成有16MB的SLC缓存。同时在CPU Die上还集成了NPU、ISP、媒体引擎、PCIe、内存控制器以及IO等不同的计算单元或功能、接口与拓展模块。
RTX Spark N1X的GPU Tile是大家非常熟悉的Blackwell架构打造,它由48组SM执行单元构成,规模上类似50组SM的GB205核心,与桌面级RTX 5070的48组SM和6144 CUDA核心一样,不过因为它的内存带宽因为只有300GB/s,再加上编解码器也集成在了GPU Tile上,所以GPU Tile上集成的专用的24MB L2缓存可能是没有太多性能冗余的,因此实际性能表现自然是比不上桌面级RTX 5070。不过相比移动级的RTX 5070Ti的46组SM,RTX Spark N1X这颗GPU的整体规模要更大一些,最终图形性能表现肯定是相当值得信赖的了。
另外在G-Die上除了CUDA之外,还包含了第四代RT Core、第五代Tensor Core,第六代NVEDC解码器和第九代NVENC编码器。
作为主打AI能力的PC芯片,RTX Spark N1X最为亮眼的还是统一内存。与苹果M5 Max、锐龙AI Max+ 395一样,它的最大内存支持到128GB,并且可以最高分配96GB做显存,内存规格为LPDDR5x-9400MT/s,位宽256bit,带宽300GB/s。从规格、位宽以及带宽三个层面来看,它比M5 Max的LPDDR5x-9600MT/s、512bit、612GB/s规格要低不少,但是比锐龙AI Max+ 395的LPDDR5x-8000MT/s、256bit、256GB/s规格要更高一些。
不过Spark N1X在AI方面的能力还不止于此。如果对比苹果M5 Max以及锐龙AI Max+395的GPU规格的话,前者为40组CU/5120 ALU核心,后者为40组CU/2560 SP,而Spark N1X的48组6144 CUDA显然规模要更大,由此带来了极高的吞吐量,再加上NVIDIA GPU本身还有Tensor Core的存在,所以其在吞吐量方面的优势相当显著,这为其在智能体AI、AI推理应用方面奠定了强有力的性能基础。
在应用层面,相比此前NVIDIA自家的基于Linux的DGX Spark来说,RTX Spark受益于Windows on ARM生态,除了在AI应用方面可以惠及到大众用户之外,自然还会有不错的游戏、娱乐、生产力性能。尤其是相对于以往高通骁龙的Windows on ARM系统来说,NVIDIA还有CUDA、TensorRT、光线追踪、DLSS5、G-Sync等等各方面的加速或优化技术做支持,再加上与微软之间的紧密合作以及全球范围内各大ISV为其做适配,RTX Spark的Windows on ARM与以往的Windows on ARM可能就完全不是同一个概念了。
除了满血版的20核CPU之外,RTX Spark还有一颗18核心CPU+5120 CUDA核心GPU的低一档型号,最终产品价格肯定是要比满血版便宜一些了。
产品端,NVIDIA也对OEM厂商提出了一些硬性要求,比如必须采用符合G-SYNC标准、覆盖100% P3色域、峰值亮度不低于1000nits、刷新率不低于120Hz的双层OLED屏幕。同时对于外观设计、接口规格、电池容量、续航能力等等方面都有非常高的标准,因此造就了旗舰配置机型普遍接近50000元的超高定价。另外在产品形态方面,目前除了笔记本之外还包含有迷你主机,这也是近年来AI PC的主流形态之一了。


 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论