深夜调试模型时GPU温度骤升、数据预处理卡在I/O瓶颈、想跑个LoRA微调却受限于显存带宽——对AI开发者与研究人员而言,显卡不是单纯拼参数的硬件,而是贯穿数据加载、模型训练、实时推理、结果可视化的生产力中枢。它需要在有限预算下平衡算力密度、软件兼容性、长期稳定性与能效比,尤其当团队需部署多套实验环境或教学演示系统时,过度堆砌旗舰规格反而造成资源冗余与维护负担。
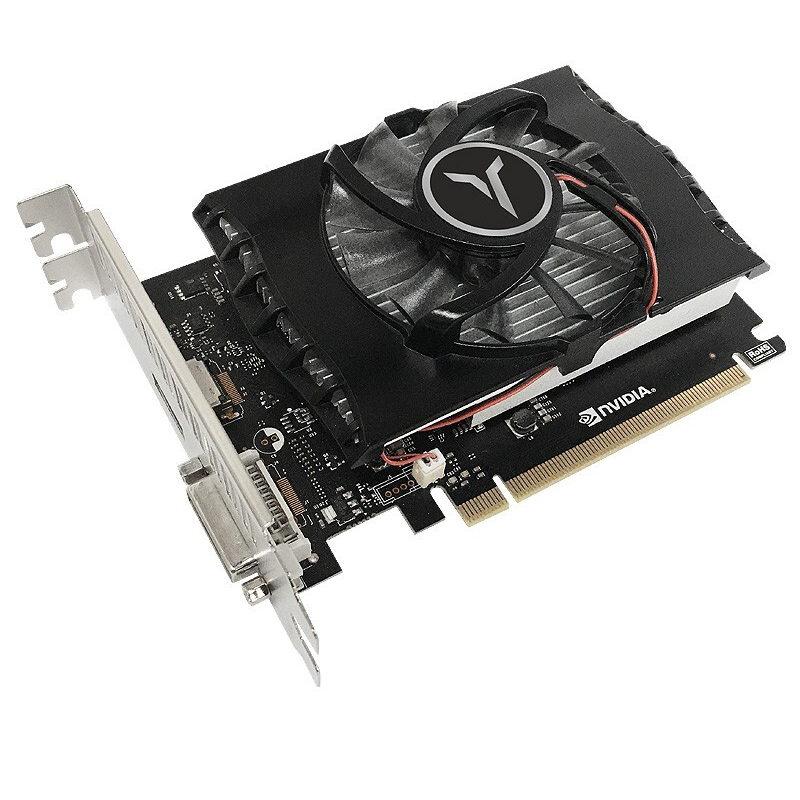
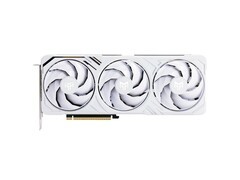
盈通GT1030-4G D4极速版以649元亲民价格切入,成为轻量级AI开发场景中不可忽视的务实之选。其虽定位入门,却完整支持CUDA 6.1及主流深度学习框架的推理加速,4GB GDDR5显存足以承载BERT-base、ResNet-18等中小模型的单次前向推理与TensorBoard可视化;低至30W的整卡功耗使其可无缝嵌入NUC主机、工控机或老旧工作站升级方案,配合4K双屏输出能力,极大提升代码调试与结果对比效率。对于高校实验室批量采购、初学者搭建本地LLM交互环境或企业内部模型验证节点,它提供了极高的单位算力成本比与部署灵活性。
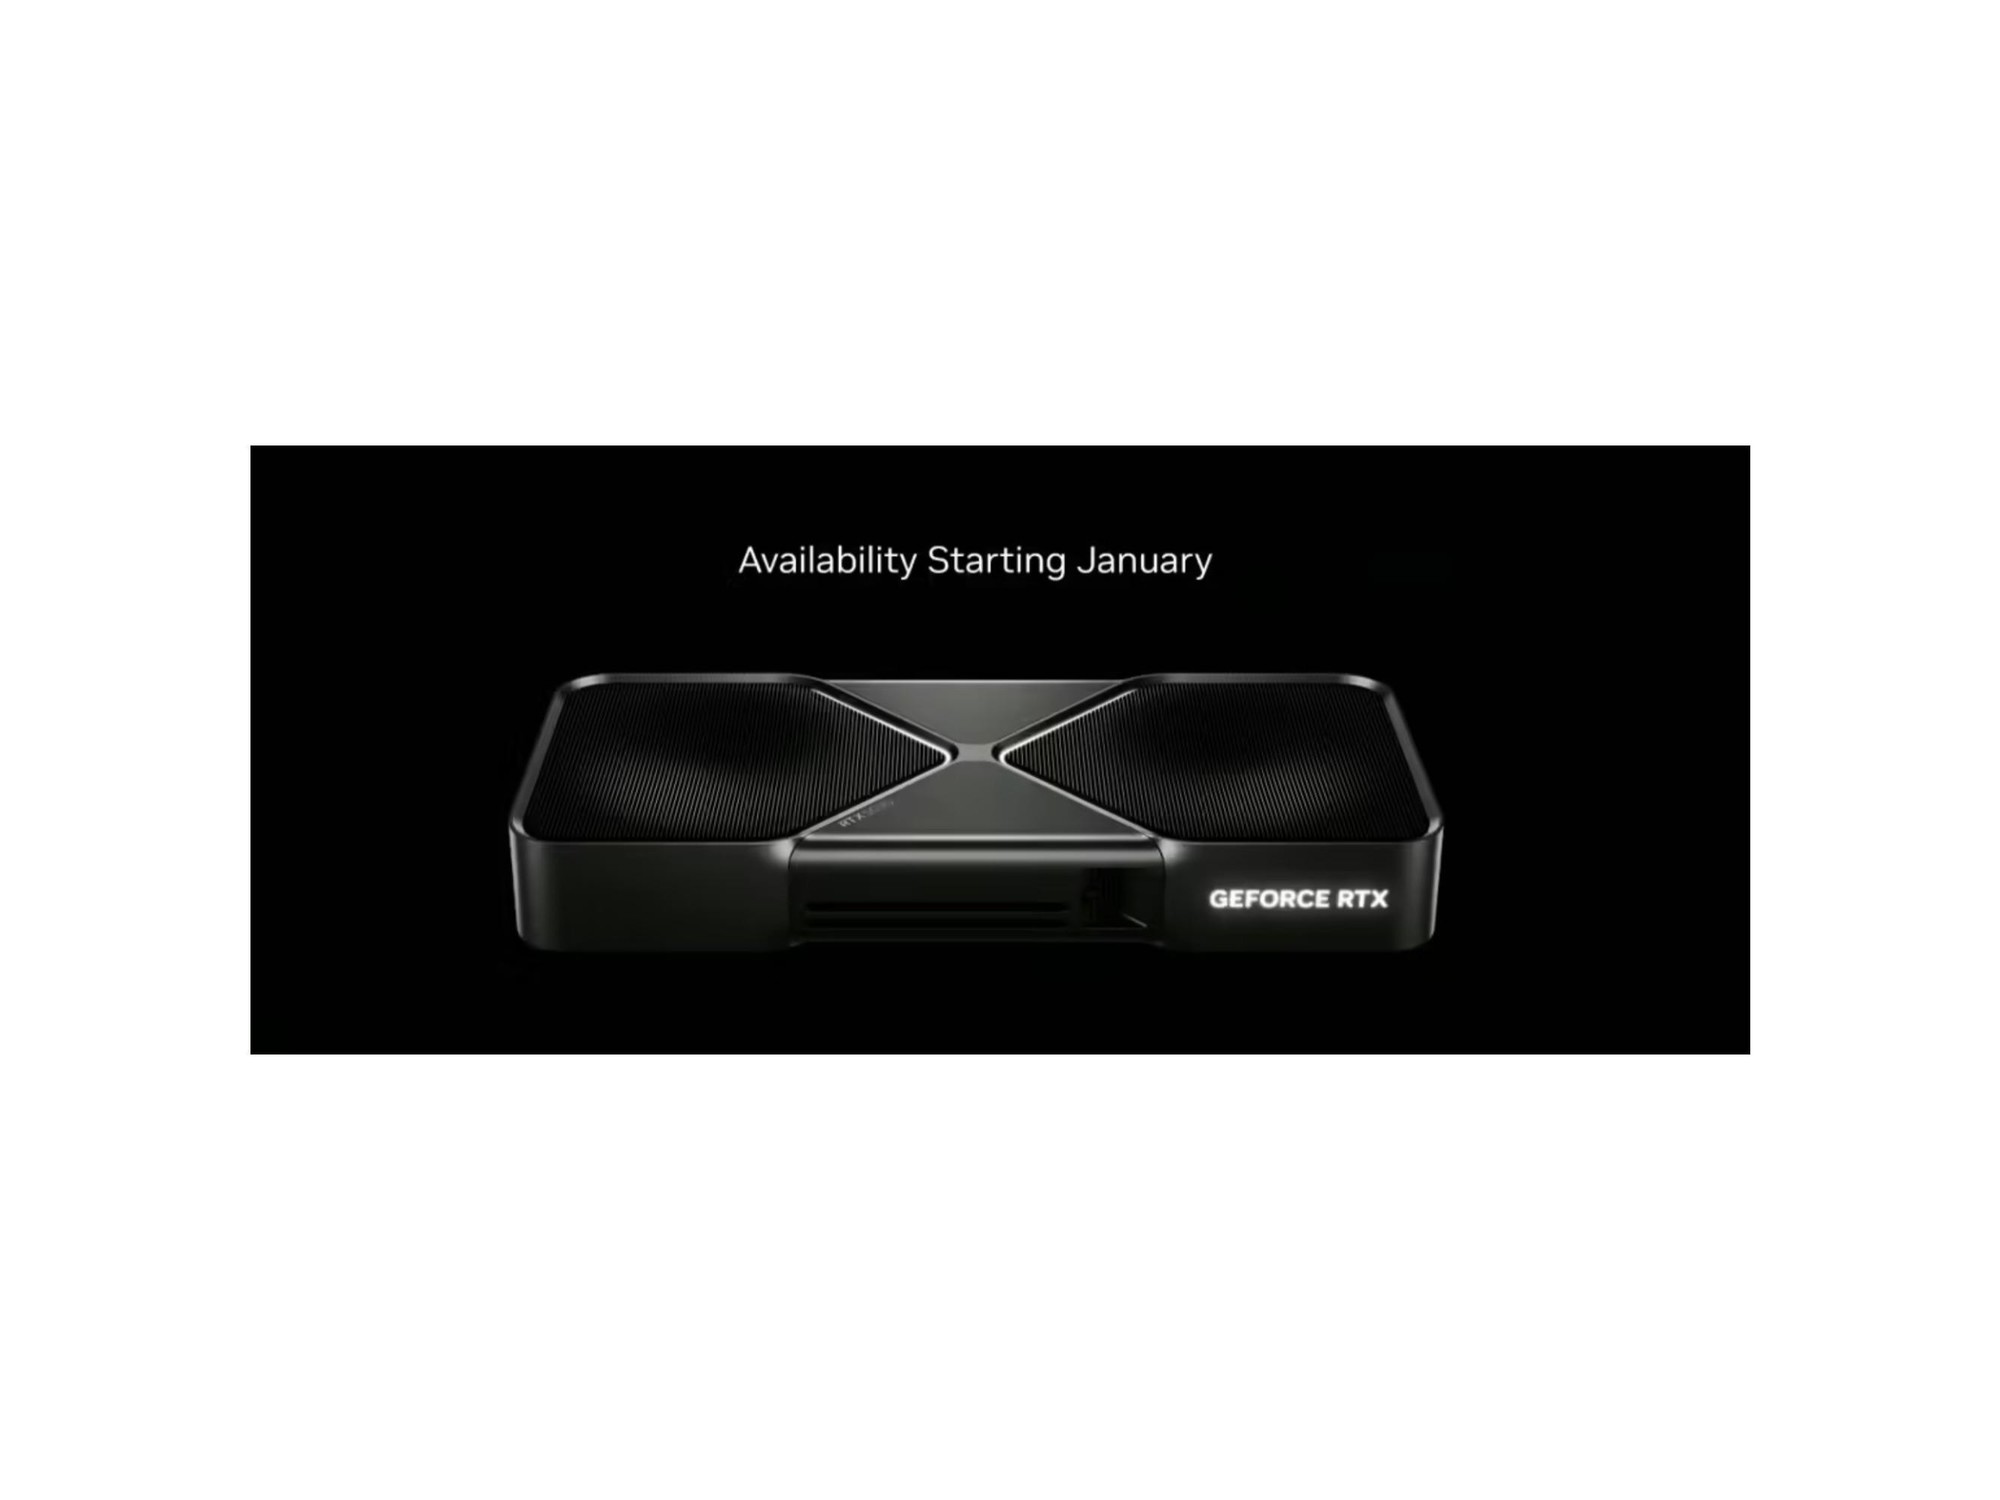
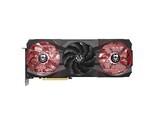
NVIDIA RTX 5070 Ti以6299元定价锚定专业进阶需求。其全新架构带来翻倍的Tensor Core吞吐与第三代RT Core光追加速能力,DLSS 4.0与FP8原生支持显著缩短大语言模型量化推理延迟;24GB GDDR7显存配合1024GB/s带宽,从容应对7B参数模型全量加载与多实例并发服务;军规级供电元件与真空腔均热板散热设计保障7×24小时训练稳定性,而PCIe 5.0 x16接口与NVLink预备通道则为后续分布式扩展预留空间。对从事计算机视觉算法研发、语音合成模型迭代或需要高频A/B测试的研究团队,该卡是兼顾前沿技术适配性与工程落地可靠性的核心枢纽。
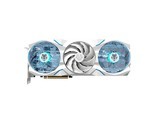
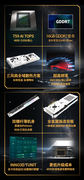
瀚铠Radeon RX 9070 XT超合金PRO以5399元形成差异化竞争力。基于4nm制程的RDNA 4架构赋予其48.7TFLOPs峰值算力与近3GHz游戏频率,在OpenCL与ROCm生态持续优化背景下,已可高效运行Stable Diffusion XL、Whisper-large等开源AI工作流;16GB GDDR6显存搭配640GB/s带宽与PCIe 5.0支持,在图像生成批量渲染与视频帧级分析任务中展现出优于同价位N卡的内存吞吐韧性;超合金供电模组与复合热管设计在持续高负载下温控表现优异,特别适合高校AI课程实训平台、创意工作室AI辅助设计管线或边缘端多模态推理节点。三者覆盖从入门验证、中型训练到专业推演的完整AI开发生命周期,无需为单一峰值性能牺牲生态适配与长期运维成本。
面对日益碎片化与场景化的AI应用需求,显卡选择早已超越跑分逻辑——它应是贴合开发者真实工作流的静默协作者。这三款产品以清晰的定位分层、扎实的软硬协同与克制的性能释放,共同构筑起2026年面向AI实践者的理性装备矩阵。





 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论