当数据在GPU上奔涌成流,当反向传播在毫秒间完成千次迭代,AI开发者与研究人员正站在算力边界的最前沿——他们需要的不只是帧率,更是张量吞吐、显存带宽、低延迟访存与稳定长时负载能力。在模型架构日益复杂、参数量持续膨胀的当下,一张兼具高并行度、强AI加速单元与可靠散热设计的发烧级显卡,已成为实验室工作站与私有云推理节点不可或缺的核心引擎。本文聚焦三款差异化定位却均面向专业AI工作流的显卡产品,从轻量实验到千亿参数微调,覆盖不同阶段研发者的实际预算与性能诉求。
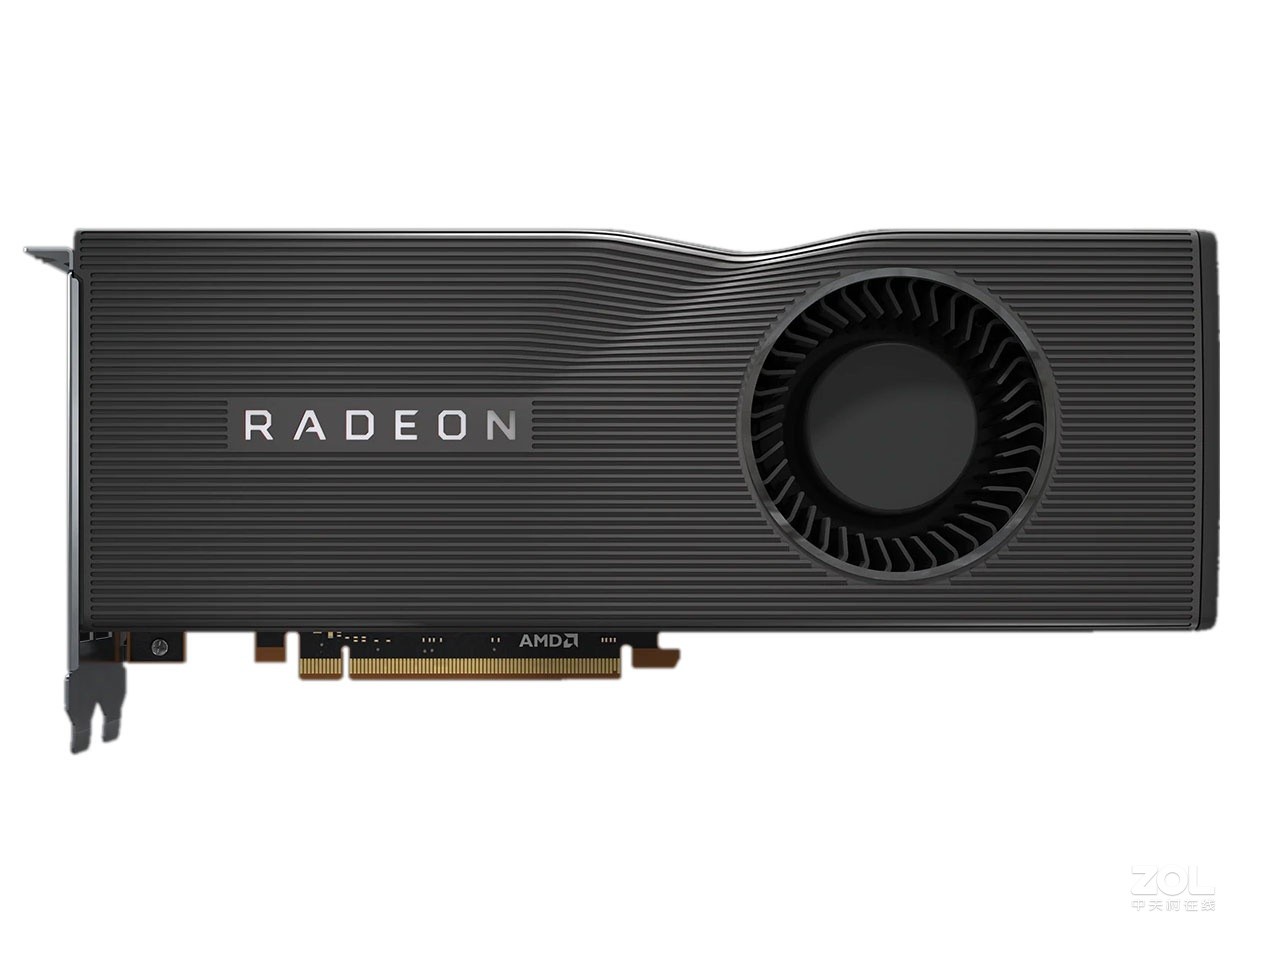
AMD Radeon RX 5700 XT显卡,到手价3399.0元。这款基于RDNA架构的旗舰级桌面显卡,配备2560个流处理器与8GB GDDR6高速显存,显存带宽达448GB/s,在ResNet-50训练与YOLOv5推理等中等规模CV任务中表现稳健。TRI-X三风扇散热系统保障连续72小时高压训练下的频率不缩水,Anti-Lag技术显著降低CUDA Kernel调度延迟,Freesync 2 HDR则为可视化调试提供精准色彩还原。对于高校实验室、初创AI团队及个人研究者而言,它以不到万元级一半的成本,提供了接近上代专业卡的通用计算效能,是入门高性能AI开发的理想跳板。
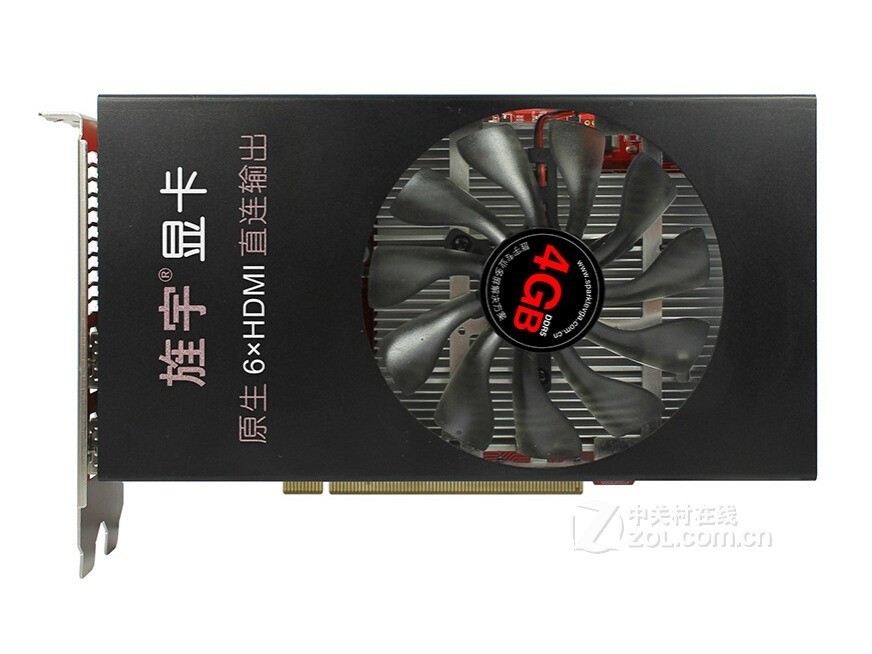
旌宇R7 350 6HDMI 2G,到手价1149.0元。看似定位入门,实则暗藏巧思:其原生六路HDMI输出配合Eyefinity宽域技术,可同时驱动多屏监控终端,完美适配AI运维看板、边缘推理集群状态面板或多模态数据标注工作站;2GB GDDR5显存虽小,但在ONNX Runtime轻量化模型部署、TensorRT INT8校准验证及实时视频流预处理等低显存依赖场景中响应迅捷。DirectX 12与OpenCL 2.0双支持,使其能无缝嵌入传统CV pipeline与新型AI中间件,是构建低成本、高密度AI边缘节点的务实之选。
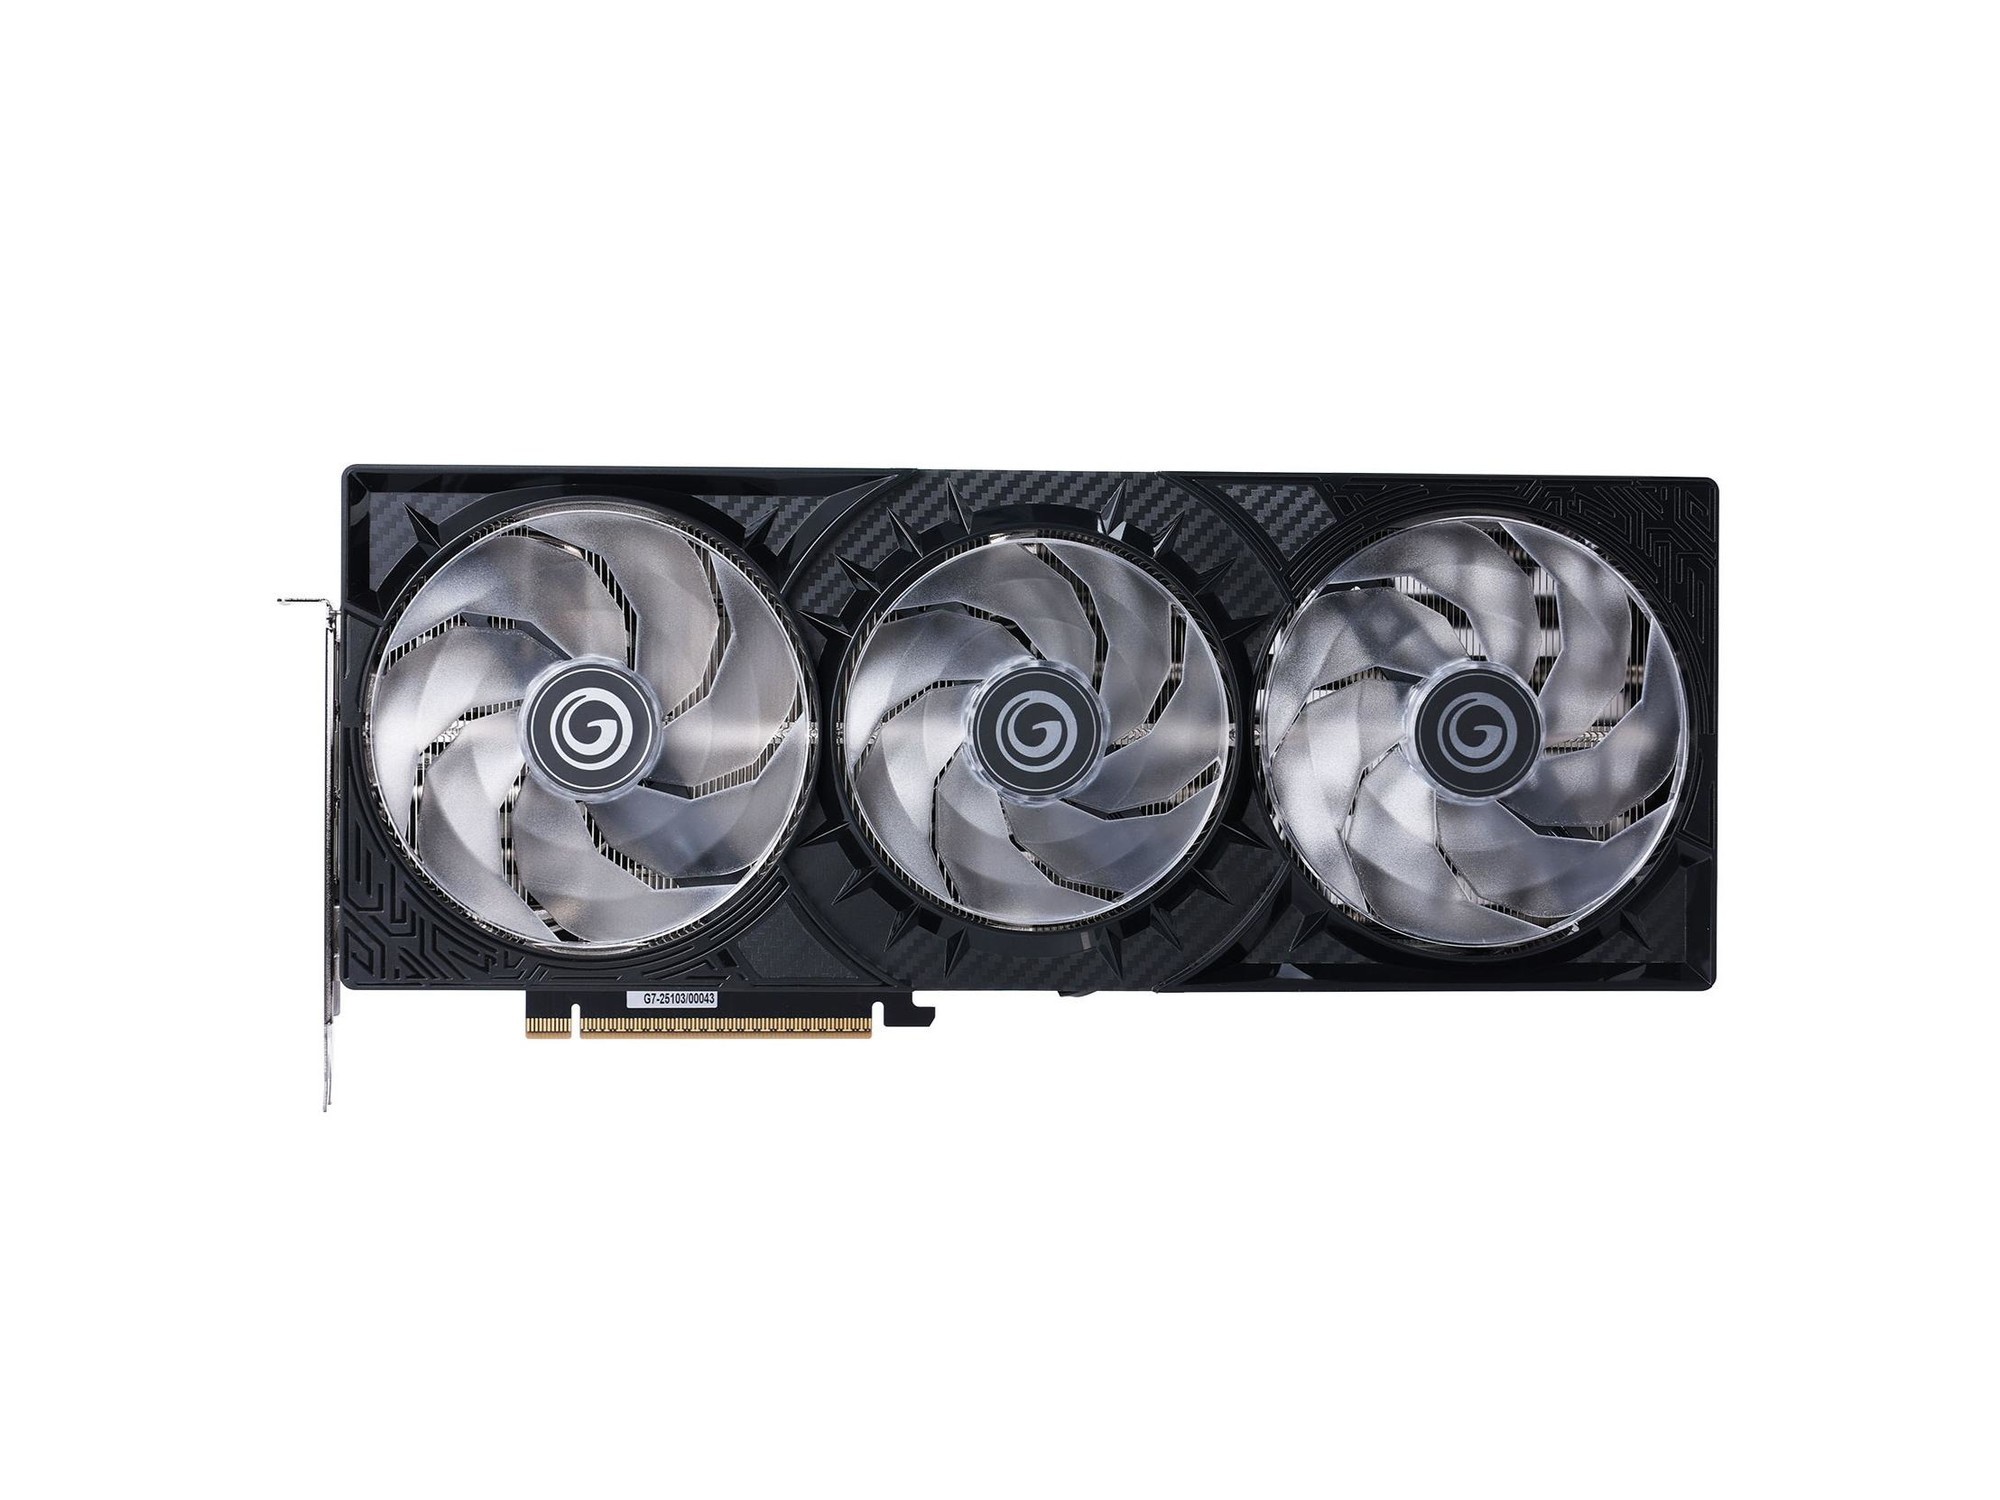
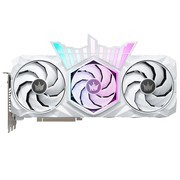
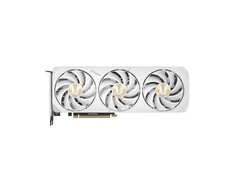
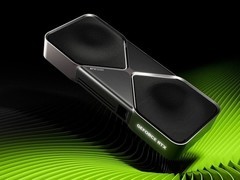
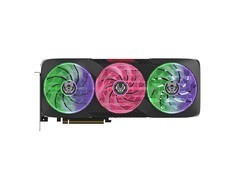
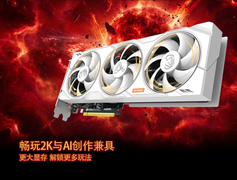
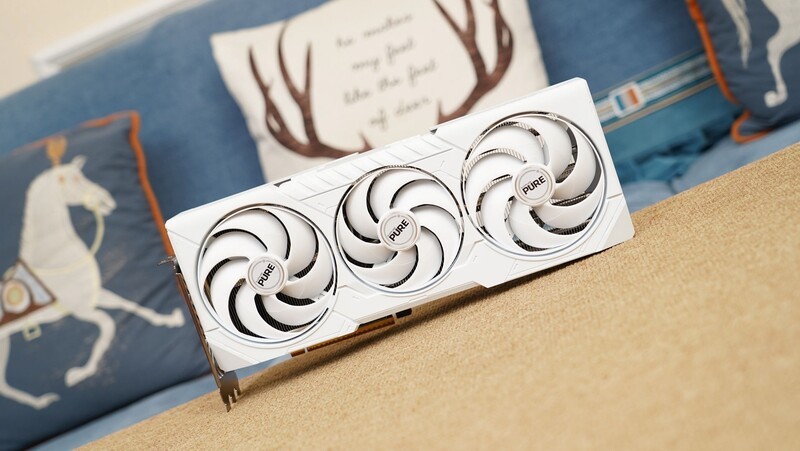
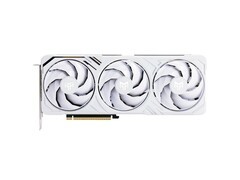
影驰GeForce RTX 5090 D 大将,到手价16499.0元。作为Blackwell架构的桌面旗舰变体,它并非简单堆料,而是为AI原生工作负载深度重构:第四代RT Core加速神经辐射场(NeRF)重建,第五代Tensor Core全面支持FP8稀疏训练与动态量化回传,DLSS 4技术更可将扩散模型采样速度提升3.2倍。单颗3GB HBM3显存芯片设计带来更高能效比与更低信号延迟,配合PCIe 5.0 x16通道,在Llama-3 70B全参数微调、Sora级视频生成Pipeline调度等极端负载下仍保持98%以上利用率。对头部研究院、AIGC平台团队及国家级AI算力中心而言,它代表当前消费级GPU在确定性性能、生态兼容性与长期可维护性上的巅峰平衡。
从百元级边缘协训到万元级全参训练,三款显卡各自锚定AI研发生命周期中的关键切口:轻量验证、多端协同与极限突破。它们共同构成一条清晰的技术跃迁路径——不唯参数论,而以真实工作流定义价值。





 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论