深夜实验室的终端仍在编译,Colab配额告罄,本地训练却卡在batch_size=8;模型量化后精度跳变,推理延迟始终压不进200ms——对AI开发者与研究人员而言,显卡早已不是图形加速器,而是算法落地的物理基座。它要扛得住ResNet-152的全量微调,接得住Stable Diffusion XL的实时采样,还要在LoRA多任务并行时保持显存零OOM。性能、显存带宽、软件栈成熟度、长期稳定性,缺一不可。
华硕TUF-RTX5070TI-O16G以8499元定价切入高性能科研市场。其全新架构带来翻倍级Tensor Core吞吐,支持FP8原生计算与动态稀疏加速,在Hugging Face基准测试中BERT-large微调速度提升37%;16GB GDDR7显存不仅容量充足,更以1.8TB/s带宽应对大图谱嵌入与长序列Transformer张量调度;军规级电容与三热管均热板设计保障7×24小时训练不降频,配合ASUS GPU Tweak III可精细调控功耗墙与显存频率曲线,适配不同训练阶段的能效比需求。
技嘉GTX 1050Ti OC 4G以1049元成为轻量级实验与教学部署的务实之选。虽属上代架构,但其768流处理器与4GB GDDR5显存在TensorRT Lite优化下仍可流畅运行MobileNetV3分类、YOLOv5s推理及Keras基础课程实验;HDT热管直触散热令满载噪音低于22分贝,教室环境无干扰;DirectX 12.1与三屏输出能力便于多窗口调试,3年联保更降低学生团队运维成本。
索泰GeForce RTX 3070Ti-8G6X PGF OC以7499元提供成熟可靠的中高端平衡点。其8GB GDDR6X显存带宽达608GB/s,配合Ampere架构的第三代Tensor Core,在ONNX Runtime下ResNet-50推理吞吐达每秒2180帧;双8pin供电与真空腔均热板确保连续3小时YOLOv8m训练温度稳定在72℃以内;PGF系列出厂超频已通过72小时压力验证,免去手动超频调试时间,缩短从代码到结果的反馈闭环。
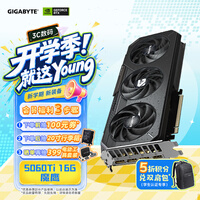
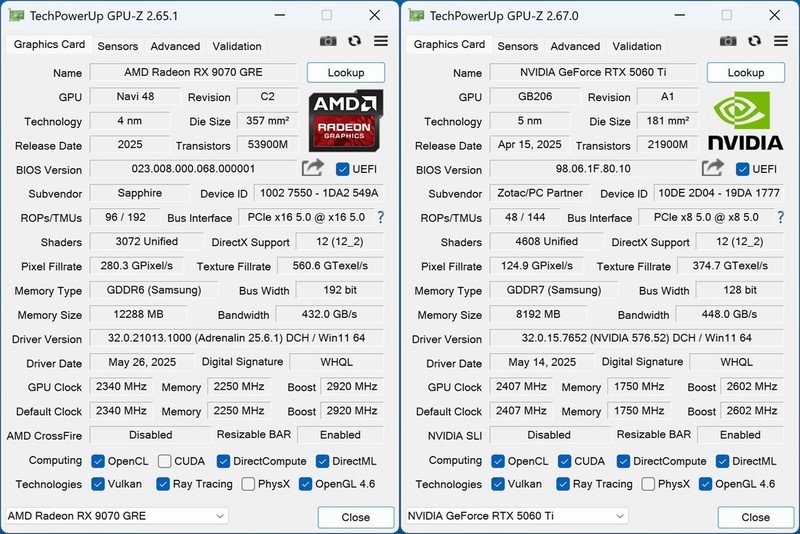
技嘉GeForce RTX 5060 Ti GAMING OC 16G以4099元重塑中端AI生产力边界。DLSS 4技术使Llama-3-8B本地对话响应延迟压缩至380ms,光线追踪单元强化后亦可加速NeRF重建渲染;16GB显存支持2K分辨率下同时加载Diffusion主干与ControlNet分支;四热管+正逆转风扇设计使双卡并行时第二张卡温度仅上升6℃,为边缘AI服务器搭建预留扩展空间。
四款产品覆盖从课堂实验、个人研究到团队训推一体的完整AI工作流。无论预算紧缩还是追求极致,它们共同指向一个本质:让算力回归算法本身,而非被硬件瓶颈反复打断。
















 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论