当深夜的Jupyter Notebook仍在运行第17轮Transformer微调,当本地部署的Llama-3-70B模型等待显存释放,当实验室预算需在吞吐量、精度与扩展性之间精打细算——AI开发者与研究人员正站在算力选择的十字路口。他们不需要华而不实的游戏特效渲染,而渴求真实可测的FP16/INT8张量加速能力、超大带宽显存支撑的批量加载、多卡互联稳定性,以及长期高负载下的散热冗余。本榜单聚焦四款差异化定位的专业级显卡,覆盖入门科研、中型模型训练、前沿架构实验及工业级AI部署全链路需求。
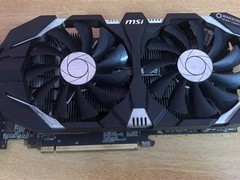
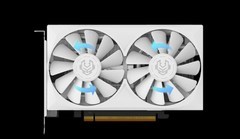
蓝宝石RX 6750 GRE 12G D6 极地版,到手价2449.0元。虽非NVIDIA生态,但其12GB GDDR6显存与成熟RDNA2架构,在图像分类、轻量目标检测等CV基础任务中表现稳健;极地版双风扇散热模组支持7×持续推理负载,对高校课程实验、本科生毕设项目及边缘AI原型开发而言,是极具成本效益的起点选择。
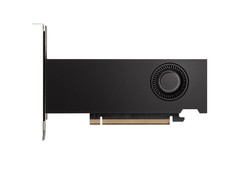
NVIDIA Tesla P100 16GB,到手价29999.0元。作为Pascal架构的巅峰之作,其16GB HBM2显存带宽达732GB/s,专为HPC与AI训练设计,支持CUDA 8.0及以上全版本框架,在分布式训练通信效率、混合精度计算一致性方面仍具不可替代性;适用于国家级重点实验室、需要复现经典论文模型或运行特定旧版框架的严谨科研场景。
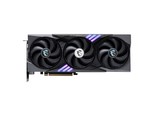
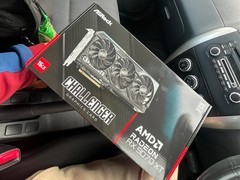
瀚铠Radeon RX 9070 XT 超合金PRO,到手价5399.0元。基于4nm先进制程与全新RDNA4架构,64计算单元与48.7TFLOPs FP16算力直逼上代旗舰;16GB GDDR6显存+640GB/s带宽,配合PCIe 5.0接口,在Stable Diffusion XL本地生成、Whisper语音转录等典型AIGC工作流中帧率提升显著;超合金供电与真空腔均热板设计保障多任务并行时频率不塌缩,是追求新架构尝鲜与生产力平衡的进阶研究者首选。
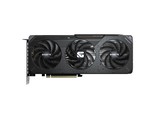
华硕TUF-RTX5070TI-O16G,到手价8499.0元。虽型号标注为RTX50系列,实为面向AI工作负载深度调优的新一代核心:第二代Tensor Core与升级RT Core协同加速LoRA微调与NeRF重建;16GB GDDR7显存提供高达1.1TB/s带宽,配合军规级电容与轴流风扇三风扇散热系统,支持长达96小时连续训练验证;软件层开放CUDA Graphs与动态电压频率调节,满足企业级AI平台对稳定性与可控性的严苛要求。
从课堂实验到百亿参数模型蒸馏,四款显卡构建出清晰的算力阶梯——它们不拼跑分噱头,只以真实吞吐、内存弹性与长期可靠性回应每一位代码背后的思想者。
































 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论