2026年的AI产业,正在悄然完成一场从“对话”到“行动”的转向。风险投资机构a16z援引OpenRouter的数据显示,仅从2026年2月至今,智能体的Token使用量已经增长约14倍。增长曲线的背后,是AI正在走出单纯的内容生成阶段:数以百万计的智能体开始作为“虚拟员工”进入真实业务场景,写代码、管理供应链、处理客服工单、调度科研模拟,甚至打理个人事务。
当智能体从“一问一答”转向 7×24小时持续运行、自主调用工具完成任务,整个数据中心的算力底座正在被重新定义。其中最值得关注的变化,发生在过去常被视作“配角”的CPU身上——它不仅正在重回AI基础设施的核心位置,也倒逼行业彻底反思沿用多年的性能评估标准。
当Token不再是终点,智能体改写CPU价值逻辑
在传统大模型时代,CPU的价值往往被掩盖在GPU的光芒之下,性能评估也始终围绕“Token生成”展开:每秒生成多少Token、每瓦算力支撑多少Token、每美元能买到多少Token。但在智能体AI的语境下,这套标尺正在快速失效。 Arm云AI解决方案架构总监Ravi Malhotra在近期的媒体沟通会上直言,智能体AI的核心要求,是生成的Token能够在真实世界中得到切实应用。这意味着性能评估的维度,必须从“生成了多少内容”,转向“完成了多少任务”。
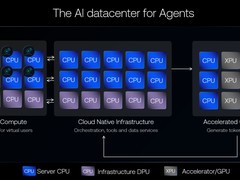
要理解CPU的新角色,首先要拆解智能体的完整工作流。一套典型的智能体任务可以分为两部分:一是推理与规划,也就是Token生成环节,通常运行在AI机架上,负责逻辑思考与内容输出;二是工具调用与任务编排,也就是把思考转化为行动的环节,包括访问数据库、调用API、执行代码、沙箱隔离等,这部分工作几乎全部由CPU承载。 这还只是通用框架。落到具体场景,不同智能体对CPU的需求天差地别。Ravi Malhotra将主流智能体用例归为五类:软件工程、企业自动化、科学研究、个人助理与机器人技术。其中软件开发类智能体需要执行代码编译、测试等重CPU操作,单次任务耗时久,对单核性能要求极高;而企业客服、个人助理类场景单次操作轻,但并发量巨大,更考验CPU的吞吐量与并发效率。“没有两个智能体是完全一样的。”这是Ravi Malhotra反复强调的观点。也正因如此,传统单一维度的跑分指标,已经无法真实反映CPU在智能体场景下的实际表现。
从芯片到机架,一套面向真实负载的评估方法论
面对行业的评估盲区,Arm在近期发布的白皮书中提出了一套完整的智能体AI CPU性能评估方法论,核心是“双轮驱动”的评测思路:组件级基准测试与端到端智能体基准测试相结合。 组件级测试的价值在于精准。通过单独测试Web服务、数据库、向量检索、模型服务框架、沙箱创建等单一模块,可以清晰地看到CPU在IPC、I/O、并发能力、内存带宽等单项指标上的表现。但组件性能的简单叠加,并不等于智能体的真实体验——真实工作流中,各个模块是串联协同的,中间的调度损耗、延迟叠加都无法通过单项测试体现。 这正是端到端智能体基准的意义所在。以SWE-bench、Terminal-Bench为代表的新一代基准,能够模拟完整的软件开发、终端操作等智能体工作流,直接测量单位时间内完成的任务数量,更贴近真实业务表现。
而这套评测体系最具突破性的一点,是将评估视角从“单颗芯片”拉升到了“整个机架”。 在被问及为何要强调机架级性能时,Ravi Malhotra给出了非常务实的答案:客户在数据中心里部署和使用的是整个机架,而不仅仅是单颗CPU。只对比单芯片性能,无法衡量能效、内存效率、服务器密度这些真正影响部署成本的关键因素。数据中心的功耗、空间、散热都是刚性约束,在固定预算下能交付多少持续有效的算力,才是运营商最关心的指标。
Arm将这种能力定义为“持续性能”:它不追求极端的峰值跑分,而是要在高并发、长时间运行的场景下,在满足服务等级协议的前提下,实现吞吐量的最大化。比如在软件开发场景,每核心运行1-2个智能体可能就是服务质量的临界点;而在轻量的企业运营场景,可以承载更高的并发。如何在吞吐量与响应延迟之间找到最优解,才是智能体时代CPU的核心命题。
第三方实测验证,机架级性能近两倍的底气
这套方法论并非纸上谈兵。独立技术分析机构Signal65基于上述框架,对Arm AGI CPU与AMD第五代EPYC(代号 Turin)处理器进行了智能体工作负载的对比测试,所有测试脚本统一,数据经过第三方独立验证。 最终的结果颇具冲击力:在相同的功耗预算下,Arm AGI CPU的每机架性能约为AMD EPYC 9755的1.99倍,几乎实现了翻倍。
分场景来看,优势分布各有不同:工具调用类场景(Nginx、MySQL),Arm AGI CPU每机架性能平均达到对比平台的1.7倍;推理与规划类场景(Milvus 向量数据库、vLLM 服务框架、fastText)达到2.2倍;智能体工作流和任务编排场景(SWE-bench、Terminal-Bench)则为2倍。 值得注意的是,Arm 的优势并非来自单核性能的碾压。报告显示,Arm AGI CPU在每核以及SoC层面的性能平均仅比对比平台高出约20%。真正拉开差距的,是能效带来的规模效应:由于每核心功耗更低,在相同的机架功耗预算下,可以部署更多的核心与服务器。单核性能乘以核心数量的规模优势,最终在机架层面转化为近两倍的性能差距。
另一个容易被忽略的关键指标是沙箱开销。出于数据安全与隔离要求,每个智能体往往需要运行在独立的沙箱环境中,沙箱的创建速度与运行开销,直接影响智能体的启动延迟与整体吞吐量。测试覆盖了冷创建、热创建、核心超额订阅等多种场景,结果显示Arm AGI CPU的沙箱开销显著低于对比平台;相较AMD EPYC 9965,Arm AGI CPU最多可将沙箱创建时延降低45%。对于动辄数万并发智能体的企业场景而言,这一差距会直接转化为实打实的效率提升与成本下降。
三十年积累踩中时代节点,CPU的三个新身份
性能优势的背后,是Arm架构在云原生时代的长期积累。Ravi Malhotra坦言,低功耗是Arm三十多年来的核心设计基因,但真正让服务器CPU具备竞争力的,是与超大规模云厂商的深度协同。从2018年推出Neoverse系列开始,Arm就与头部云厂商紧密合作,针对数据库、缓存、机器学习、编解码等真实云工作负载优化微架构。从Neoverse N1到最新的V3核心,每一代迭代都在提升性能的同时严格控制功耗,而Neoverse V3正是Arm AGI CPU的核心。 这种设计思路,恰好踩中了智能体时代的需求变化。在智能体AI的架构中,CPU的角色早已不是GPU的“附属品”,而是承担了三大核心职能: 第一,是Token价值的落地者。将大模型生成的Token转化为实际行动,无论是编译代码、读写数据库还是调用第三方服务,最终都要靠CPU执行; 第二,是加速器的 “后勤官”。在AI头节点中,CPU负责作业调度、数据准备、KV缓存与向量数据库的读写,确保昂贵的GPU能够持续满负荷运转,不会因为数据供给不足而闲置。在代码开发这类CPU密集型场景中,CPU的速度甚至直接决定了GPU的利用率; 第三,是工作流的“调度员”与“安全员”。负责智能体任务的编排调度,同时通过沙箱等技术实现安全隔离,保障多智能体并发运行时的数据安全。 这也正是行业所说“CPU重回C位”的真正含义:它不是要取代GPU,而是在智能体的完整链路中,成为了与加速器同等重要的一级算力支柱。
从厂商方案到行业共识,标准正在路上
技术的价值最终要落到产业落地中。目前Arm已经推出了两款服务器参考设计:1OU双节点与2U2P,合作伙伴包括超微电脑、联想、华擎科技等,覆盖从通用服务器到AI头节点的多种场景,风冷与液冷方案均已就绪。 在开放计算领域,Arm正在向OCP(开放计算项目)贡献AGI CPU服务器参考设计,Meta的Yosemite YV5也已将Arm AGI CPU引入OCP机架级设计之中。这意味着,面向智能体优化的CPU架构,正在从厂商方案走向开放的行业标准。
更值得关注的是行业层面的共识。Arm提出的这套评估方法论,已经得到了富士通、Meta、OpenAI等产业头部玩家的公开支持。 富士通高级副总裁、先进计算开发事业部负责人Toshio Yoshida表示,在开发下一代Arm架构CPU产品FUJITSU-MONAKA的过程中,深刻体会到透明、可重复且具有代表性的测评体系的重要性,欢迎Arm推动行业协作的举措。
OpenAI全球前沿部署工程负责人Colin Jarvis则认为,AI系统正从生成内容发展为通过推理、使用工具完成复杂任务,围绕代表性基准开展行业协作,对于刻画新兴工作负载、优化整个AI系统性能至关重要。
当然,现在就谈统一的行业标准还为时尚早。智能体技术本身仍在快速演进,新的场景、新的架构、新的工作流还在不断涌现,几乎每隔一段时间就会有新的基准测试出现。
Ravi Malhotra也坦言,Arm提出的是一套评测方法论,而非正式的行业标准。它更像一个务实的起点,引导行业跳出单一跑分的思维,从真实业务场景出发,重新审视CPU的价值。 对于企业用户而言,这或许也是最理性的选型思路:不存在万能的“最强 CPU”,也不需要用一套统一权重给所有平台排名。先明确自己的智能体场景是什么,再对应到组件与端到端基准中去验证,找到适合自身业务的性能与效率平衡点。
智能体AI的浪潮,正在把算力产业从“比峰值”的时代,推向“算实效”的时代。CPU的价值回归,只是这场变革的缩影。当所有算力最终都要以“完成多少真实工作”来度量,整个数据中心的技术路线,或许都会因此改写。
写在最后
说到底,这场性能评估标准的迭代,本质上是 AI 产业从“生成内容”转向“创造价值”的注脚。大模型时代的算力竞赛,比拼的是Token生成的速度与规模,考验的是“大脑”的上限;而智能体时代的算力竞争,比拼的是任务交付的效率与成本,考验的是“躯干”的韧性。CPU从配角重回核心视野,恰恰说明AI的落地已经走到了深水区——不再靠纸面参数吸引眼球,而是要靠真实的业务产出证明价值。
Arm给出的方法论未必是最终答案,但它踩中了行业最核心的转向:算力的强弱,终究要以“做成了多少事”来度量。当数百万智能体开始成为企业的“数字员工”,整个数据中心的技术逻辑、产业的评价体系,都将围绕这一核心重新生长。




 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论