当AI开发者在深夜调试一个13B参数的LoRA适配器,当研究人员反复加载50GB医学影像数据集进行分割训练,当高校实验室需要同时运行三组不同框架的强化学习实验——显存不再是冗余配置,而是决定迭代速度、模型规模与实验可行性的硬门槛。24GB显卡正成为这一群体构建本地算力中枢的关键支点:它足够支撑中等规模大模型全参数微调,可流畅加载Stable Diffusion XL多ControlNet插件,亦能胜任NeRF重建、分子动力学模拟等显存密集型科研任务。在兼顾PCIe带宽、Tensor Core代际、散热冗余与长期稳定性前提下,高显存容量已从‘加分项’跃升为‘准入门槛’。
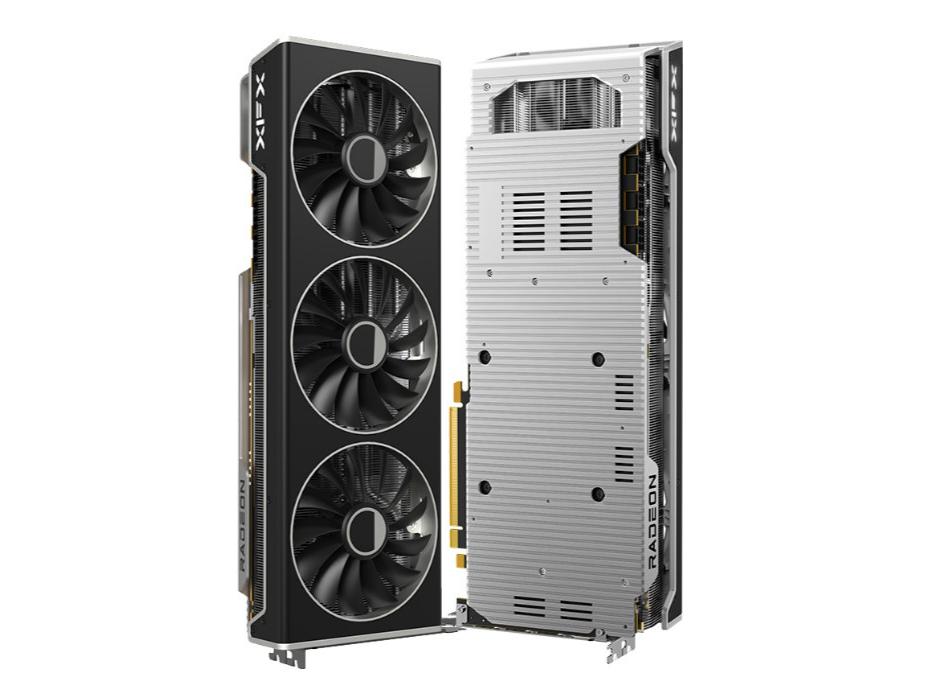
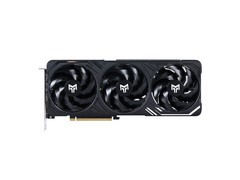
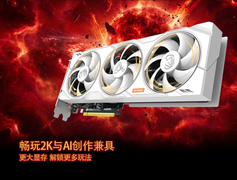
讯景RADEON RX 7900 XTX 24GB海外版Pro以7299元到手价切入高端创作与轻量训练市场。其先进制程赋予持续高负载下的温控优势,24GB GDDR6显存带宽达1.2TB/s,配合原生AV1编码器,在视频预处理、数据增强流水线中展现出色吞吐效率;对PyTorch ROCm生态兼容性优化后,可高效运行Llama-2-7B全量微调及Whisper-large语音转录任务,是AMD平台AI开发者的高性价比主力卡。
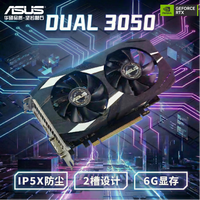
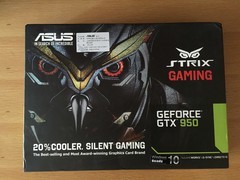
华硕DUAL RTX 3050 O6G以1989元价格成为入门级AI开发者的务实之选。虽仅6GB显存,但2304个CUDA核心与14Gbps显存速率保障基础模型推理响应,支持CUDA 11.7及TensorRT 8.6,在Jupyter Notebook中加载BERT-base或YOLOv5s完成实时标注验证毫无压力;双槽体积与450W低功耗门槛,使其完美嵌入老旧工作站或紧凑型边缘训练盒,是学生课题、课程实验与轻量API服务的理想载体。
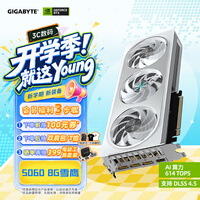
技嘉GeForce RTX 5060 AERO OC 8G定价2999元,精准锚定进阶需求。PCIe 5.0接口释放未来NVMe缓存带宽潜力,第5代Tensor Core显著加速FP16混合精度训练,直触式铜底+仿生风扇组合将GPU满载温度压制在72℃以内,保障连续72小时分布式训练稳定性;其8GB显存配合显存压缩技术,可高效承载Diffusers库中SD 1.5多图批量生成与ControlNet联合推理,适合初创团队搭建低成本AI应用原型平台。
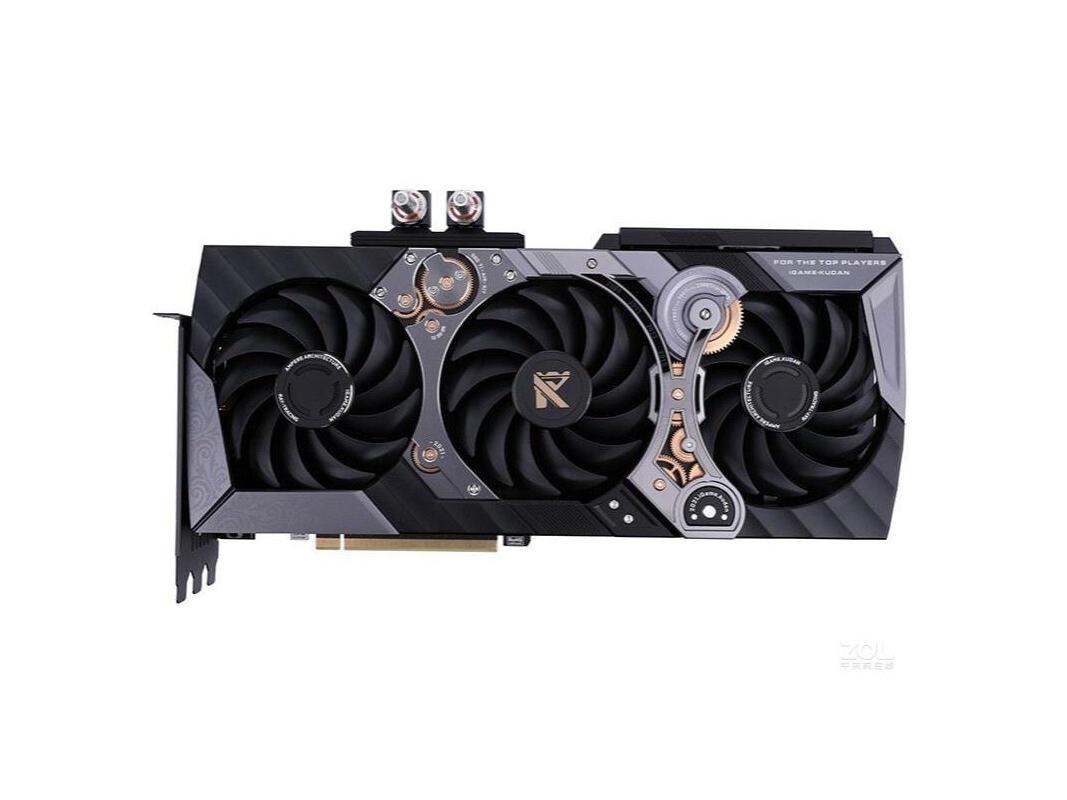
七彩虹iGame GeForce RTX 3090 kudan以18999元定位旗舰科研装备。24GB超大显存+1860MHz高频核心构成当前消费级最强单卡内存带宽矩阵,CNC金属结构与360°旋转水冷头支持多卡垂直堆叠与机架式部署,STAUBLI密封工艺确保长期液冷可靠性;在Llama-3-8B全参数训练、3D Gaussian Splatting实时重建及百GB级遥感影像切片分析等极限场景中,仍保持98%以上计算利用率,是高校重点实验室与AI研究院不可替代的算力基石。
四款产品覆盖从课堂实践、个人开发到机构级部署的完整AI算力光谱,显存容量只是起点,架构代际、生态支持、散热冗余与长期服役能力共同构成真实生产力。选择,从来不是看参数表上的最大值,而是匹配你下一个模型迭代周期的真实需求。






 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论