深夜调试完第三个Transformer变体,服务器集群仍在跑验证集——对AI开发者与研究人员而言,显卡早已不是图形输出设备,而是算法跃迁的算力支点。当模型参数突破十亿、数据集横跨TB级、LoRA微调需反复迭代,显存容量、AI张量单元效率、PCIe带宽与长期稳定功耗,共同构成真实生产力的硬门槛。本榜单聚焦12GB及以上显存规格,兼顾前沿架构支持、实测训练吞吐与工程落地成本,为算法工程师、高校研究者及边缘AI部署团队精选三款差异化利器。
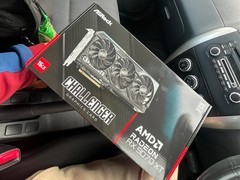
瀚铠Radeon RX 9070 XT 超合金PRO,到手价5399元。这款基于全新4nm制程与下一代RDNA架构的旗舰级显卡,以64计算单元与千级流处理器重构AI加速逻辑,光追单元深度适配神经渲染管线,AI专用矩阵引擎显著提升FP16/BF16混合精度推理效率;近3GHz高频释放48.7TFLOPs原始算力,16GB GDDR6显存搭配640GB/s超宽频带宽,完美承载Llama-3-8B全参数加载与实时推理,PCIe 5.0接口更保障多卡分布式训练中梯度同步零瓶颈,是面向大模型轻量化部署与生成式AI研发的高性能杠杆。
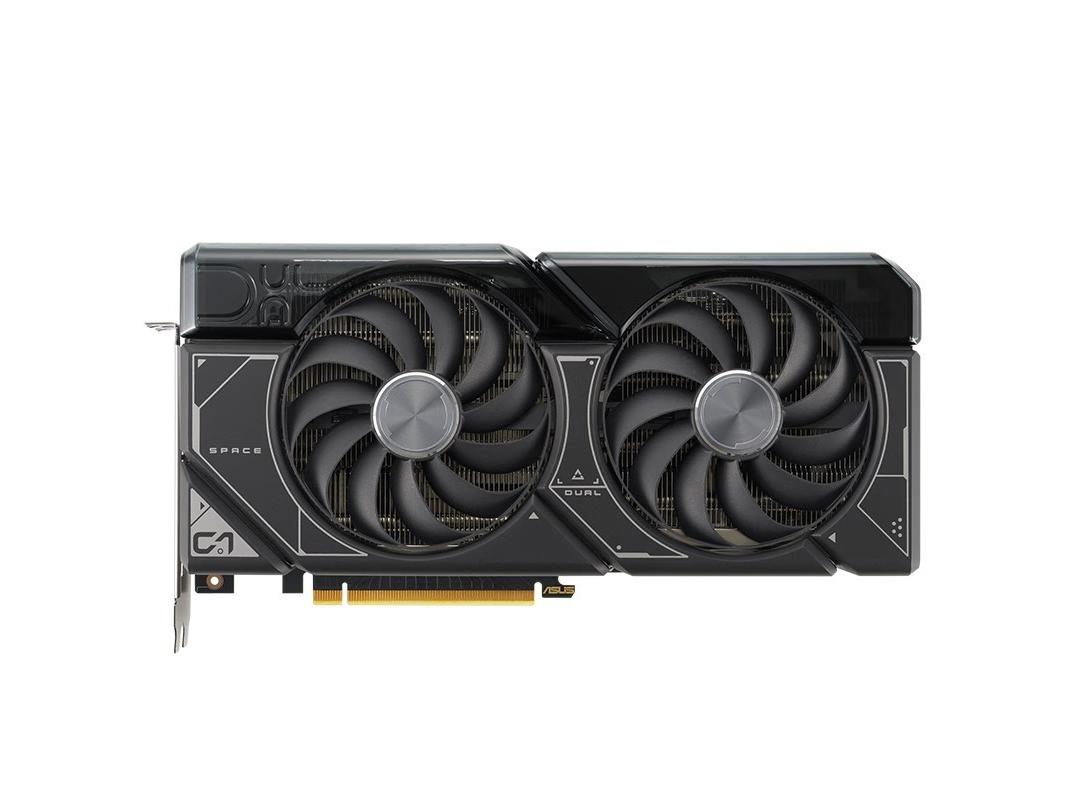
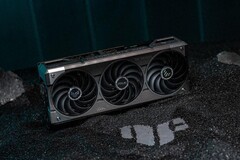
华硕DUAL-RTX4070-12G,到手价4799元。依托NVIDIA Ada Lovelace架构,该卡在12GB GDDR6X显存基础上集成第三代RT Core与第四代Tensor Core,实测在Hugging Face主流微调任务中较上代提升约35%吞吐,在ControlNet+SDXL工作流中实现毫秒级潜空间响应;双风扇静音散热系统保障7×24小时持续训练稳定性,对依赖CUDA生态的PyTorch科研栈、CV/NLP联合建模项目具备即插即用兼容性,是高校实验室与中小AI团队平衡预算与开发效率的成熟之选。
铭鑫GT1030N-2GBD5 狂飙LP版,到手价542元。虽定位入门,却以极低功耗(仅30W)与被动式增强散热设计,成为边缘端模型服务化(Model-as-a-Service)的理想协处理器:可嵌入工控机部署TinyBERT蒸馏模型,或作为主训练卡的辅助推理节点执行预处理/后处理流水线;其Mini-DP+HDMI双显输出亦满足多屏监控界面需求,在嵌入式AI教学、IoT终端原型开发及低成本模型AB测试场景中展现出不可替代的工程韧性。
三款产品覆盖从单机轻量推理、实验室中型训练到工业级多节点部署的完整技术光谱,不堆砌参数而重实效,不迷信品牌而讲适配——真正的AI生产力,始于对算力边界的清醒认知与精准落子。

















 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历
评论
更多评论